机器人实时控制面临一对天然矛盾:要判断物体如何运动、任务进行到哪一步,需要足够长的视觉历史;但一旦处理历史,动作就会变慢。更关键的是,给模型历史,它不一定会用。
10月27日,青稞Talk 162 期邀请到 Long-WAM 第一作者、香港大学 ECE 博士生(NVIDIA Research Efficient AI 团队研究科学家实习生)黄炜,分享《Long-WAM:探索世界动作模型的“记忆”Scaling 与 Infra》。
本次分享系统讲解了世界动作模型为何需要“记忆”、长上下文 scaling 为何依赖自回归视频预训练、因果上下文如何带来异步控制的天然平滑,以及如何通过流式观察编码、异步执行与硬件加速,让“先想象、再行动”跑在 RTX 5090、DGX Spark、Jetson AGX Thor 等边缘端;最后还讨论了大模型与执行策略之间“大脑与小脑”的分工协同,并结合真机实验展示其在动态与长时程操作中的表现。
开场与介绍
青稞社区的朋友们大家好,我是黄炜,很高兴能受到青稞社区的邀请来这里跟大家分享我们最新的工作:Long-WAM,Scaling the Context of World-Action Models。我是今天的分享者,这里先做一个简单的自我介绍。
我现在是香港大学 ECE 系的博士生,我的导师是齐晓娟老师,同时我是 NVIDIA Research Efficient AI Group 的研究实习生,我的 mentor 是陈玉康博士,我的 manager 是宋晗老师。然后我之前主要在做一些 efficiency、efficient AI 相关的一些工作,包括 compression、long context,还有一些 real-time 的 AI,包括 robotic inference。今天主要分享的是我们在具身智能领域,特别是 World Action Model 的 context scaling,以及它的 inference infra 相关的一篇工作,叫做 Long World Action Model。
一、为什么机器人需要记忆,为什么 Infra 重要
那我们就直接步入到我们的正题吧。其实一开始,我们想向大家解释一下我们为什么要做 Long-WAM 这样一个工作,为什么机器人是需要记忆的,为什么 infra 是非常重要的。大概先说一下我们的心路历程和 background。
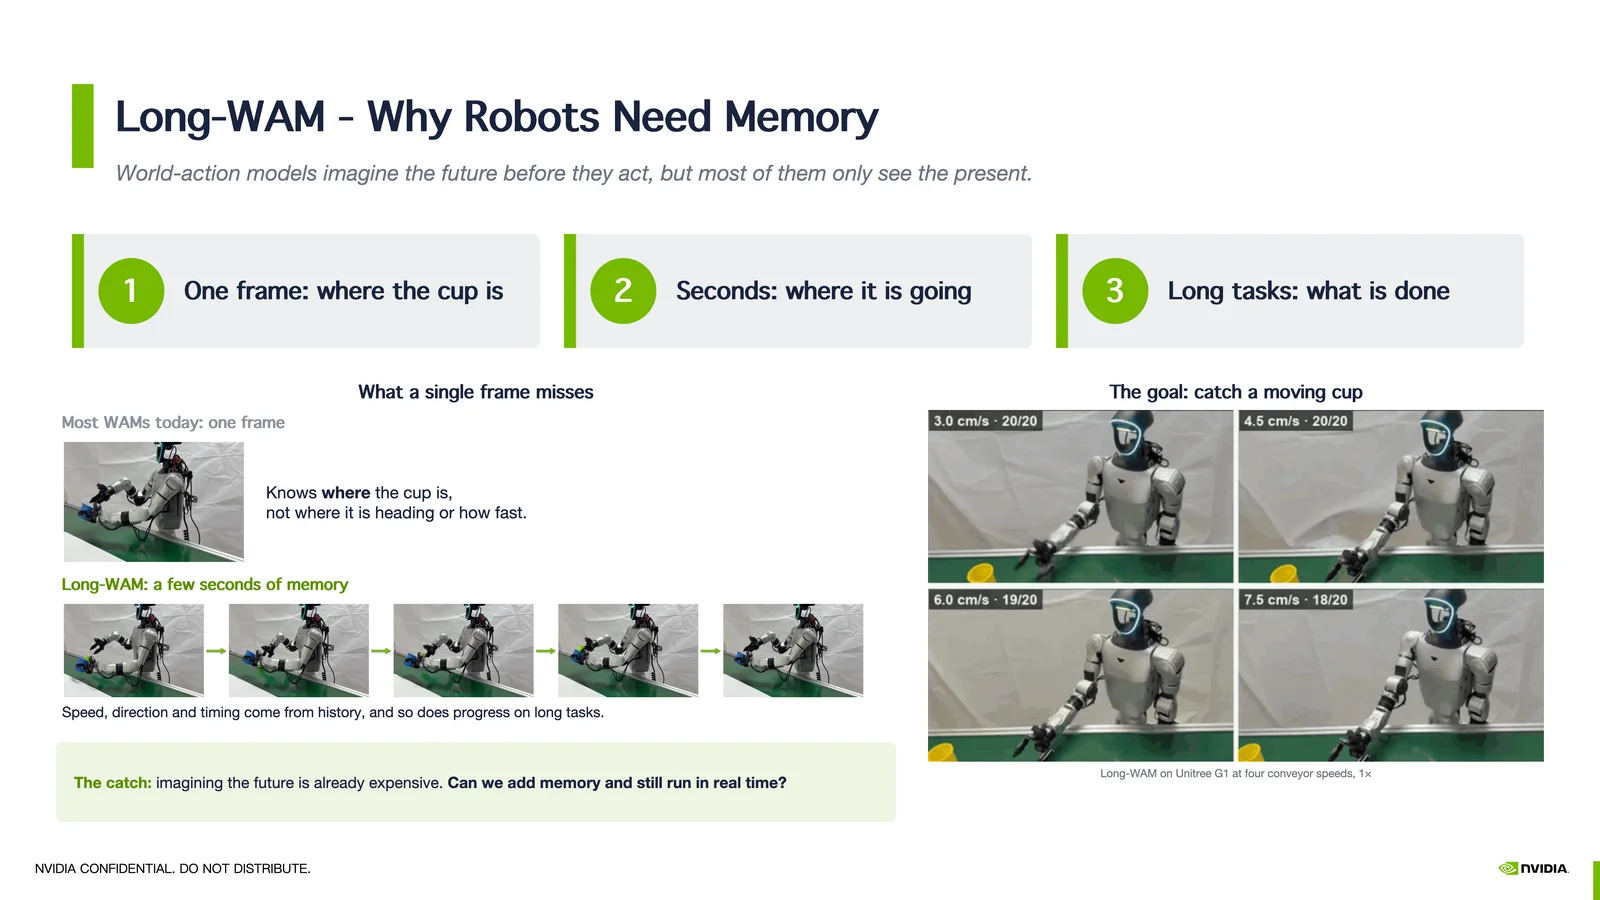
那我们一开始发现,最主流的不管是 VLA 也好、World Action Model 也好,大家都倾向于单帧的输入。单帧的输入下,我们根据当前的 observation 和我们的 instruction,还有机器人的 state,去做一个 action 的预测。当然这样效率是非常高的,我们可以在不同的状态进行切换、错误恢复,在任意 state 下都可以执行,这是非常好的事情。
我之前在思考一个问题:我们面临一些高动态的场景。我们发现很多机器人真机上的 Demo 速度非常慢,VLA 可能相对快一点,基本可以做到端侧 10Hz 推理;World Action Model 则很慢,尤其是 IDM 这种推理形式,需要先 prediction,再做 action 的 prediction。哪怕是采用 code denoise joint output,速度也相对比较慢。尽管之前有 Fast-WAM、AHA-WAM 这类不错的工作把速度提上来,但往往需要做出取舍:比如放弃 IDM 推理方式、把 steps 压得很小,或是依靠极端剪枝、极端压缩才能提速。能不能让 World Action Model 在不做这类牺牲的情况下跑得更快,是一个非常关键的问题。
另外,回到我们前面的一个点,我们发现,即便机器人推理速度偏慢,但物理世界里大多数物体都是运动的。静态场景下的任务其实占比不高,不管是工厂流水线、物流场景还是居家环境,很多物体都处于运动状态。如果机器人要抓取运动物体,首先它的 action 要足够快。
第二点,就像我们自己去接运动物体,比如打篮球、打网球,或是接住别人抛过来的东西,我们都需要预判它的落点。想要预判准确,就需要掌握它的运动规律。所以我当时就在想,为什么现有的 World Action Model、VLA 大多没有时序 context?当然之前也有不少和 memory 相关的研究,但这些工作大多聚焦一些长期的工作 memory,比如 Hours 级别的、days 级别的,甚至是超长上下文级别的一些生活记忆。而我们认为,second 级别短时的记忆也是非常重要的。
就像 slide 里这个例子:如果我们在传送带上有一个运动的杯子,那么我们想要机器人抓住它,就需要预判它的运动落点 —— 也就是当机械臂抵达抓取位置时,杯子会运动到哪个位置。如果我们只看当前帧,机器人无法感知杯子正在运动;引入短期 memory 之后,我们可以在 KV 缓存中读取多帧里杯子的位置与时序变化,模型就能推理出在未来若干帧、若干秒之后杯子的位置,抓取也就会更精准。这是我们最初的假设,后续实验也验证了这个猜想。
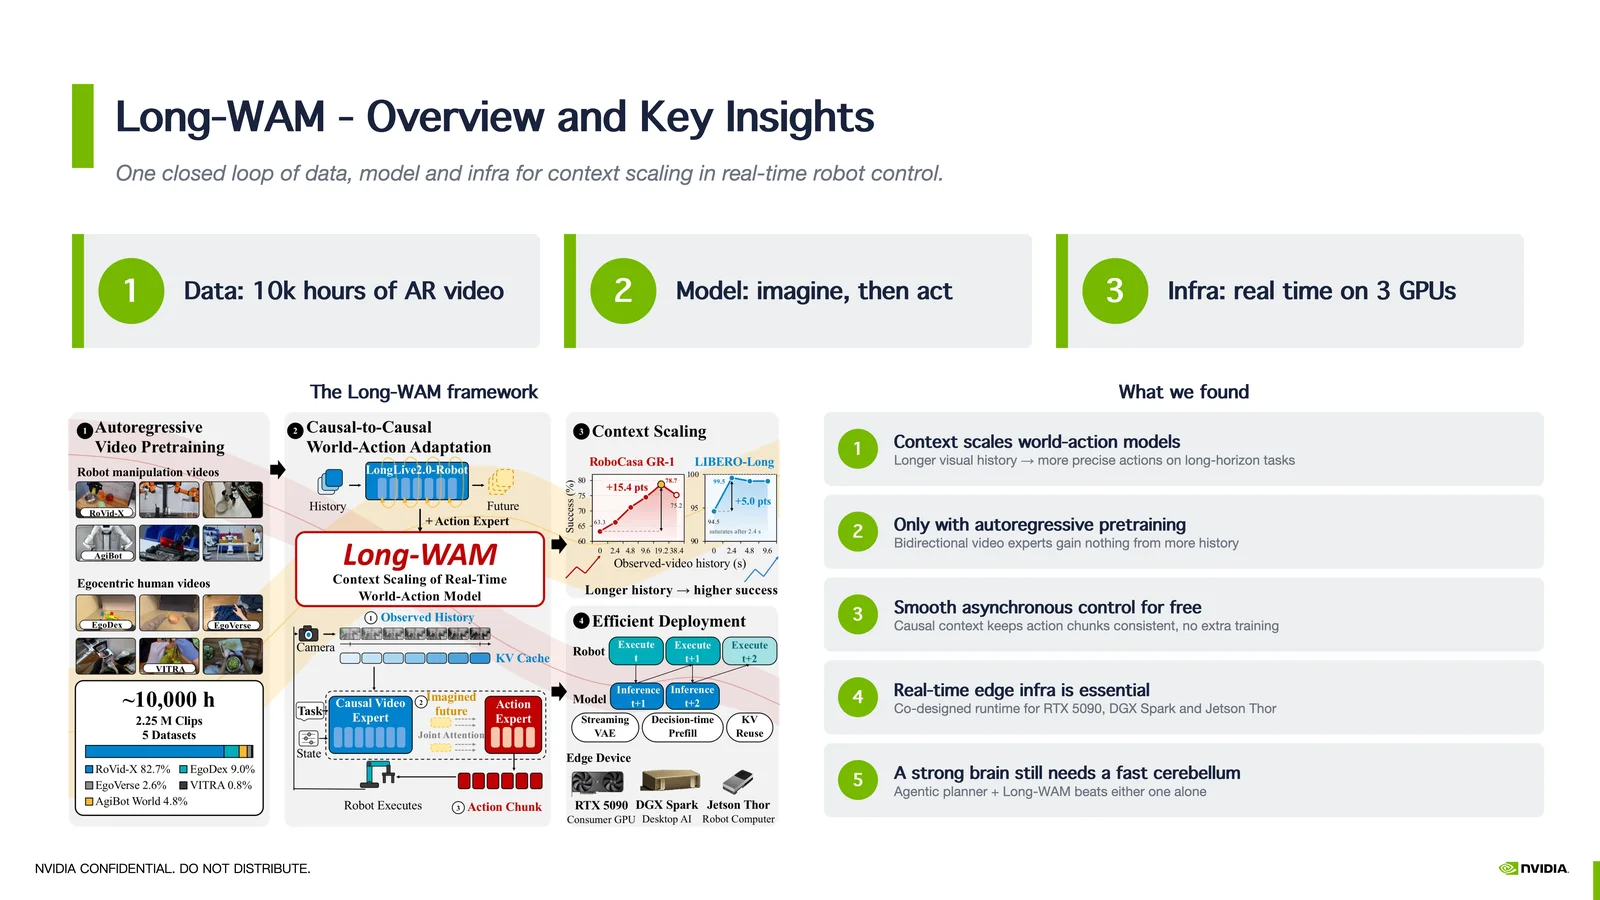
我们从这个小例子出发,来整体介绍我们 Long World Action Model 这个工作。整体上,这项工作的 contribution 分为三块。
第一部分是 Data。我们收集了大量的机器人的一些视频数据,包含真机数据、ego 数据以及物理交互数据,总量约 10K Hours。构建这份数据,是因为我们想用它训一个 Autoregressive Video Generation Model,为什么这样做我在后面会具体介绍。
第二部分是 Model。Model 整体架构是统一的,包含 Video Expert 和 Action Expert,我们采用 Mixture of Transformer,也就是 MoT 的方式并联,构成我们的 World Action Model。
第三部分是 Infra,也就是 Inference Infrastructure。我们注意到很多现有工作的部署硬件以消费级显卡 RTX 5090,以及 A100、H100、GB200、B300 这类训练卡为主。但是我们发现机器人有专门的端侧硬件,比如 Jetson AGX Orin、Jetson AGX Thor,甚至一些个人 PC、DGX Spark 这类平台。我们的目标就是在这类端侧硬件上对模型做加速,真正实现实时推理与机器人闭环控制。以上就是这项工作的三大核心模块。
然后我在这里直接列出我们的 5 点发现,先把这些发现告诉大家,这样后面看 slides 的时候,大家能更清楚地理解这些结果背后的原因。
首先第一点,Context Scaling 对 World Action Model 是非常重要的。一方面就像前面举的例子,拉长 Context 之后,模型在动态任务上表现更好,因为 Context 里包含了丰富的物体运动信息。另一方面,针对时长大概 30 到 40 秒这类偏长的桌面任务,当我们引入 Context,模型对整条任务 Trajectory 的理解会更好,这类长程桌面任务的成功率也会提升。
然后第二个发现:Only with Autoregressive Pre-training。这一点很有意思。我们发现拉长 Context 之后,World Action Model 的推理是 Causal 的形式,用来保存历史记忆。传统的 World Action Model 大多基于 Bidirectional,也就是双向 Video Generation Model 作为 Backbone,再拼接一个 Action Expert 输出动作。
这种情况下,负责理解和生成运动的 Video Expert 本身是双向建模的,原生不具备 Context Scaling 的能力,也无法在长 Context 下做 Causal Inference。我们在团队之前 LongLive Model 的基础上开展了一项工作——LongLive 2.0 是我们在 5 月份发布的纯 Autoregressive Video Generation Model,基于 Wan 系列 Model 训练得到。在这类 AR Model 上,我们看到,当开启 Context Scaling 时,模型能够获得更大的收益。
当然不是说 Bidirectional Model 完全没有提升。我们在部分 Benchmark 上观察到,用 Bidirectional Video Expert 做初始化也能有一定收益,但它的上限偏低,Scaling 曲线比较平缓。在 AR Video Expert 上,我们发现它的曲线整体上升是比较明显的,它能更适配 Context Scaling。
第 3 点是一个额外的 Bonus。我们发现引入 Context 之后,真机部署时模型整体运行会更加丝滑。做过真机实验的同学应该清楚,为了实现 Real-Time,我们会采用 RTC 或者 Smooth 这类 Asynchronized Infrastructure。模型推理一个 Chunk 的同时,真机在执行上一段动作;当真机执行到中途,模型就可以基于新的 Observation,开始推理下一个 Action Chunk,让模型 Inference 和真机执行相互 Overlap。这样整套真机流程会更加 Smooth,整体端到端执行速度更快。
这里存在一个关键问题:每一轮推理基于某一中间状态的 Observation,和最终动作在真机执行完成的时刻之间存在时间 Gap。普通的 VLA 或者 World Action Model 直接部署,很容易出现明显的动作 Jerk,抖动严重、不 Smooth,甚至机器人 Out of Bound、发生卡死。当然已有一些后训练方法,比如最简单做 Smooth 操作、RTC 或者后训练来适配这种分步推理。而引入 Context 之后,推理下一个 Chunk 时会携带上一阶段的历史 Context,动作天然就能够衔接,输出会更加 Smooth。这就是额外的 Bonus。有了短时 Context,模型不仅在动态任务、长程桌面操控任务上变强,还能让真机异步推理的执行过程更平滑,相当于一箭三雕。我们也可以额外做后训练、动作 Trajectory 拼接这类操作实现平滑,但依靠拉长 Context 就可以省去这些额外的后处理和优化步骤,这是很有意思的一点。
第四点,Real-Time Edge Inference,Edge Essential 就不用多说了,我们在真正的边缘设备上去做这样的 Real-Time Inference 至关重要,尤其是机器人端侧显卡,例如 Orin,或是消费级显卡上,相比于我们在 server 端的显卡上去做是非常重要的,它的使用价值。
最后一点,也是近期比较热门的方向。我们认为,即便我们拥有 GPT Astra、OPUS 5.5、Gemini 这类能力很强的“大脑”,可以根据 Observation 生成代码、调用底层控制,输出动作 EF、DoF 等信号。但是只依靠 Agent 方案依然存在不少问题。
是不是有了 Agent,我们就不再需要 VLA、World Action Model 这类 Actuator、执行器?我们的结论是仍然需要。举个很直观的例子,这类动态抓取任务是 Agent 很难完成的。用过 Astra API 的话大家会发现,一段本来只需要 10–20 秒的简单桌面任务,Agentic API 往往需要 20 分钟到半小时,其实是非常不实用的。动态抓取任务更是几乎不可能完成。
在我们这样的场景下,一定是需要快速响应的 Policy,让机器人快速做一些下意识的动作,去完成我们的需求。所以我们认为 Action Model、VLA 这类端到端 Policy 依然不可缺少。更理想的范式是二者结合:既利用 Agentic 大脑强大的 Reasoning 和 Planning 能力,同时依靠 Policy 完成精细抓取、快速响应这类实时操控。
OK,以上就是五点总结。我们提前把这项工作里的观察和经验提炼出来分享给大家,方便大家在后面看 slides 的时候,更好地理解我们的 Motivation 和实验结果。
二、Video Prediction 与模型设计
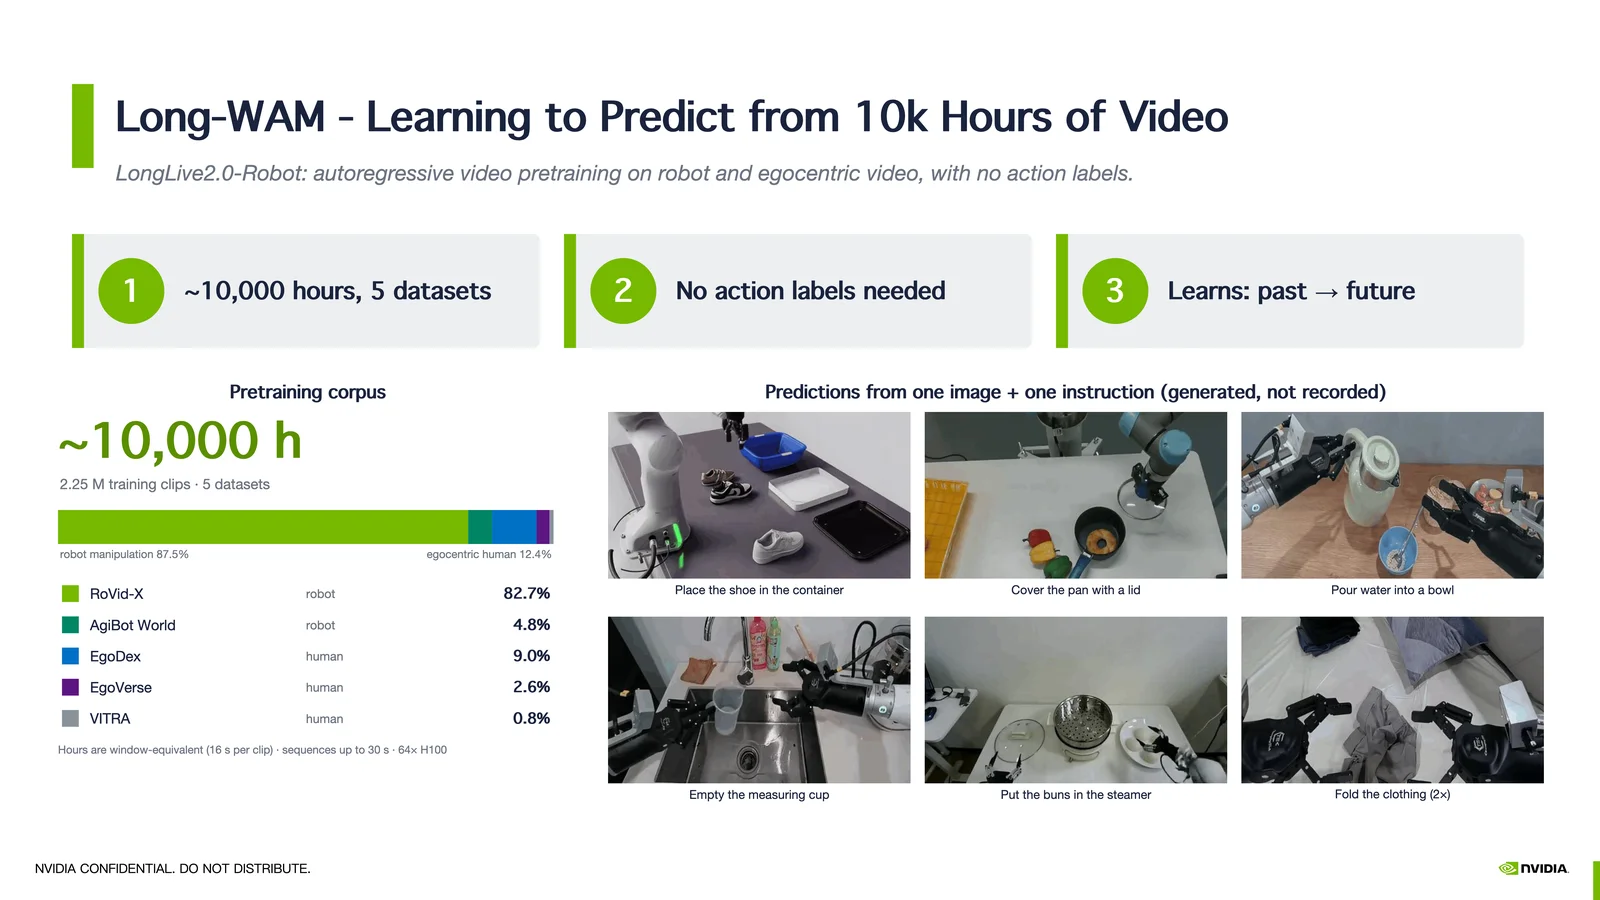
OK,那下一页 slide,我们还是从 Video Prediction 开始吧。这里我们一共构建了 10K Hours 的 Video Data,基本都是从开源 Data 里面找的,包括 RVD、AgiBot、COGVERSE、EgoDex 这类 Ego View 数据集,我们把它们整合到一起。在 LongLive 2.0 这个 Video Model 的基础上,我们采用 Teacher Forcing 的训练方式,同时配合 Sequence Parallel。这套 Training Infrastructure 也是继承自 LongLive 2.0。我们直接在这份数据上训练它的 AR Prediction 能力,实验效果很不错。
大家可以看这里的几个简单 Demo。比如任务是把鞋子放进蓝色 Bucket,模型可以准确定位鞋子并将其放入篮中,抓取动作、接触交互都非常 Smooth。还有右上角倒水的例子,可以看到水壶中的水持续流出,杯子里的水位慢慢上升,水面波动也符合物理规律。这也证明我们这个 AR Video Prediction Model 效果很好,可以在这份数据上学习机器人的运动模式,以及对未来运动状态的预判。原版 LongLive 2.0 是基于通用数据训练的,并没有在机器人专属数据上做训练,而我们在这一批机器人数据集上对它做了二次训练。
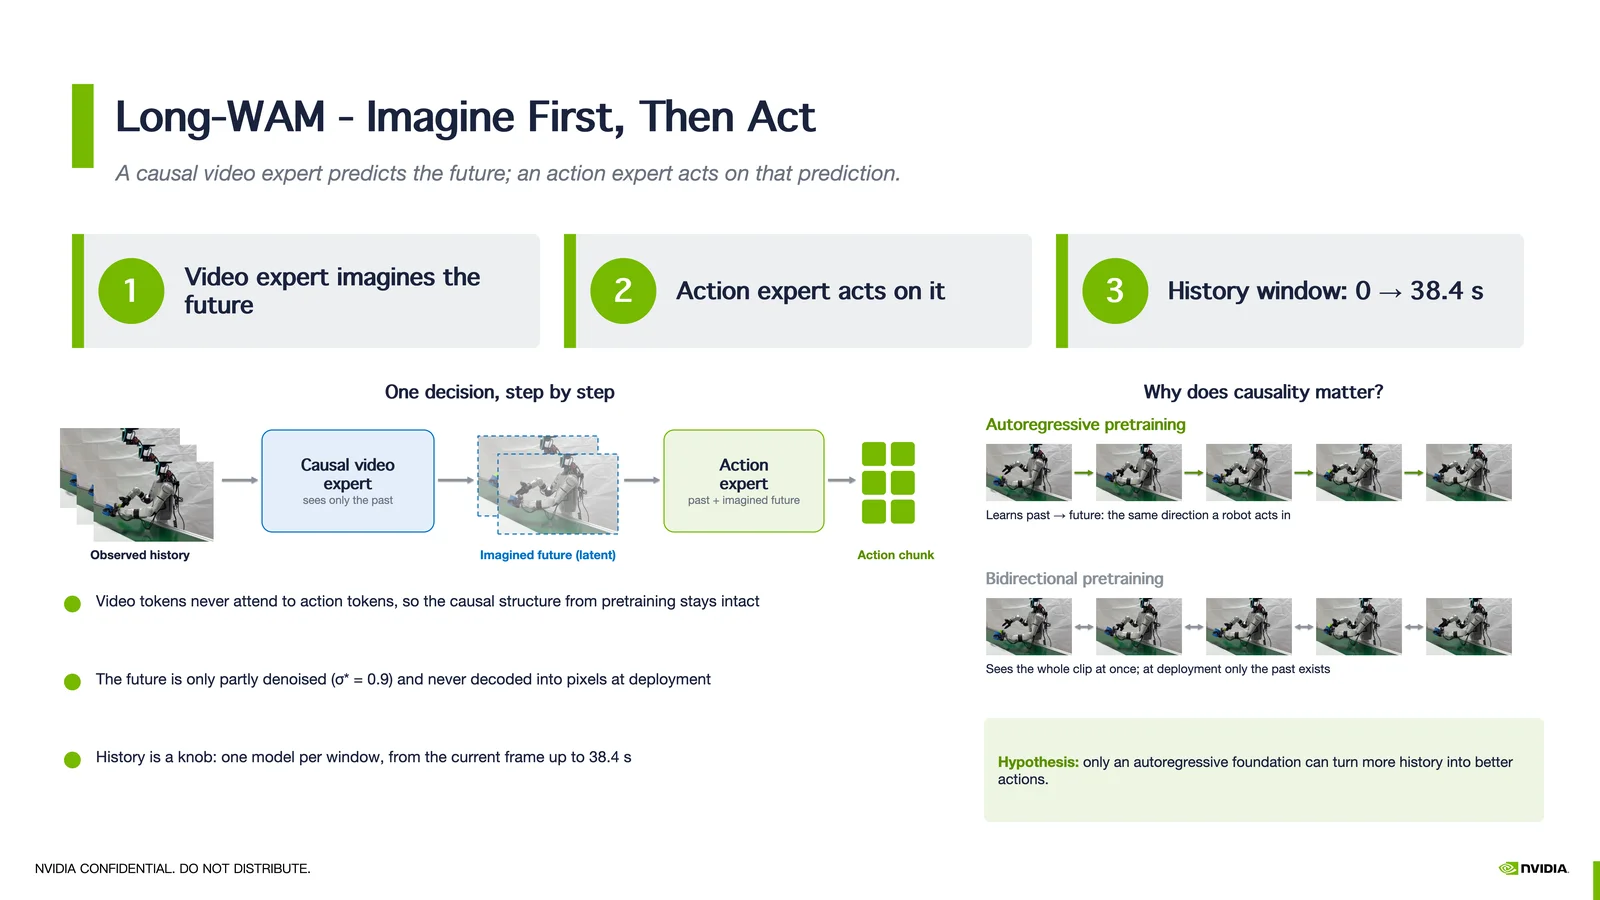
接下来是 Model Design,这部分我会快速过一下,没有太多额外的内容。我们基于预训练好的 LongLive 2.0 Robotics Model,接入一个初始化的 Video Expert,通过 Mixture of Transformer 的方式实现 Attention 共享,这也是现在主流 World Action Model 的通用做法。这样一来,这个 Expert 原生就具备 Causal Inference 能力,在之前的 AR 训练过程中,它已经学会依托多帧记忆预测未来运动,并且根据 Instruction 预判物体、机械臂抓取状态的变化。整体架构上,这一块并没有特别新颖的设计。
三、Infrastructure 设计
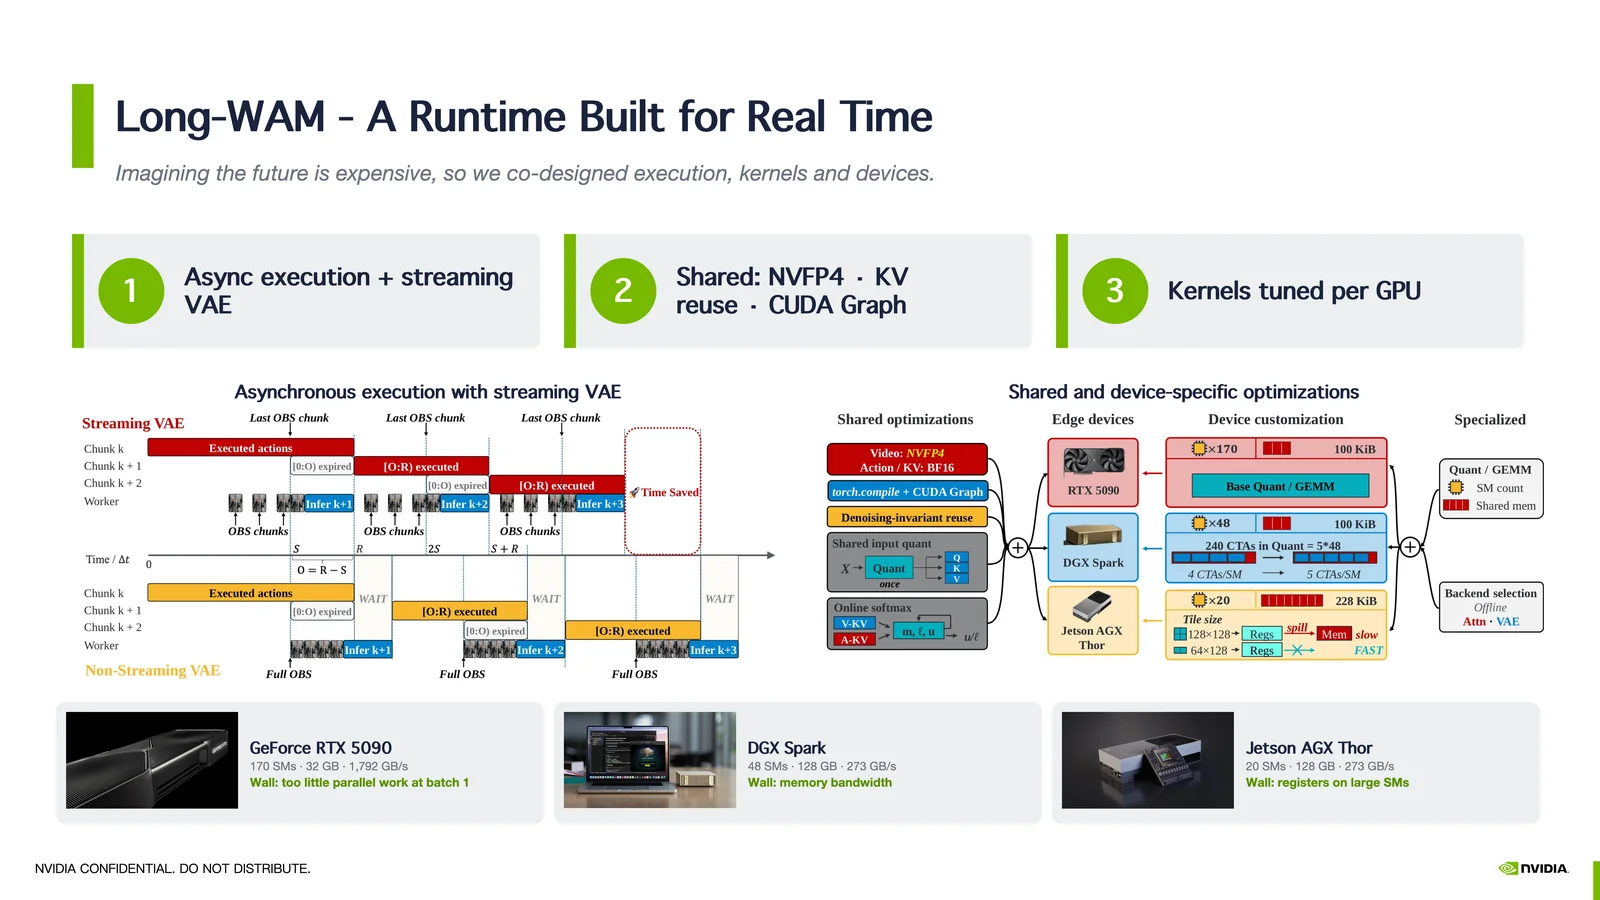
那第三部分,我们来讲 Infrastructure 的设计。因为 Long World Action Model 本身它有一些独特设计,它引入了 Context。这里的 Context 就是机器人的 Observation,可能是两个 camera,也可能三个 camera,甚至可能是四个 camera。我们需要对这些 Camera 采集到的 Frames 做实时处理,送入模型。在异步推理的场景下,引入 Context 之后会遇到一个关键问题:Context 一旦拉长,端到端推理速度会明显下降。因为在 World Action Model 的流程里,所有 Frame 都要先经过 VAE,之后还要交给 World Action Model 做 Loop Denoise,不管是 Video、Action 还是 Code Denoise,这部分计算开销很大,整体效率偏低。
针对异步推理,我们提出了 Streaming VAE。在 Camera 持续流式采集 Frame 的过程中,我们就逐帧通过 VAE 完成编码。这样在后续模型推理的时候,就不需要把全部 Context 一次性走一遍 VAE。在机器人上一轮动作执行的过程中新采集到的 Observation,不用等到推理时刻再一次性对全部 Context 跑 VAE,这会非常耗时。我们采用流式编码的方式,等到需要推理下一个 Chunk 时,可以直接复用已经编码好的 Latent Frame,直接进入推理流程。这套方案在真机与模型异步推理的链路下,可以带来很明显的速度提升。
除此之外,我们还做了大量 Infra 层面的优化,主要分成两块。第一块是 Shared Optimization,也叫 General Optimization,包含 NVFP4、长 Context 下的 KV Cache、KV Cache Reuse、CUDA Graph 这类业内通用优化手段。这部分优化是跨平台复用的,可以在不同硬件上生效,所以我们称之为 Shared Optimization。
第二块是 Kernel Tuning,面向不同型号的 GPU 做定制适配。不同端侧显卡的硬件架构差异很大,SM 的规格、数量、CUDA 生态都不一样。举个例子,RTX 5090 带宽更高、HBM 性能更强,而 DGX Spark、AGX 这类平台不具备这个优势;Hopper 架构的 SM Size 更大,但 SM 总数更少。我们寄存器上限固定为 256,当 SM Size 变大、SM 数量变少的时候,算子运行时容易出现寄存器不足,产生大量内存读写的开销,因此需要针对性调优。这部分工作由我们的共同一作张博涵同学完成,他是上海交大的本科生。最终我们在多款边缘显卡上都拿到了不错的加速效果,这也是我们工作的亮点之一。
四、实验结果与关键观察
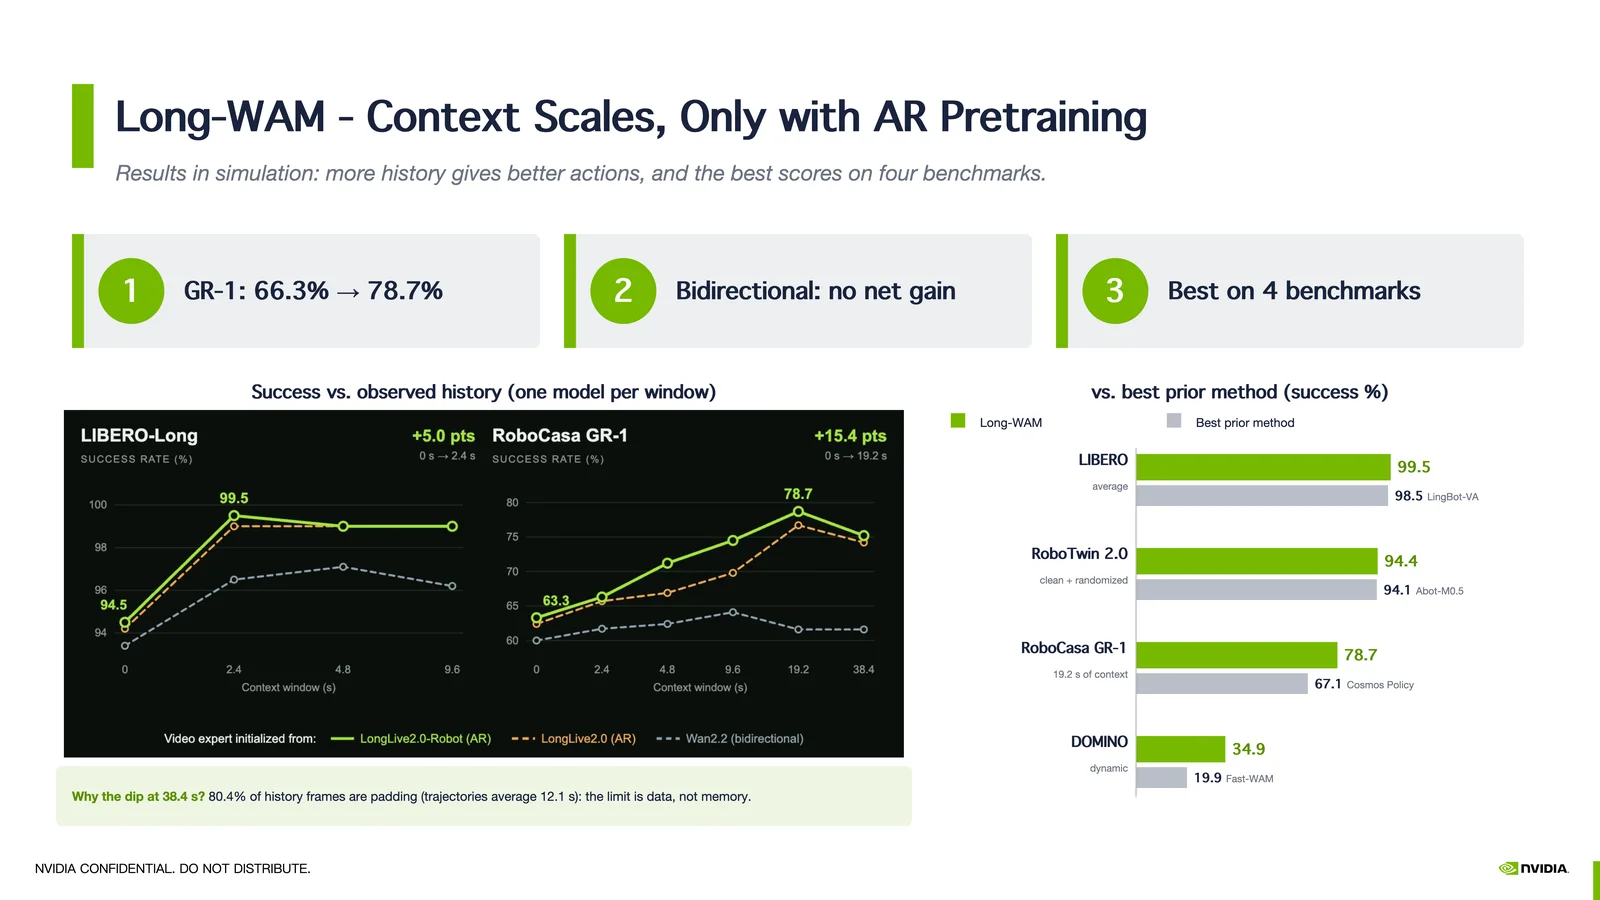
那前面做完概括之后,我们来看一些重要的实验观察。左边这张图是 LIBERO-Long 这个长上下文 LIBERO Benchmark 上的实验结果。右边是 RoboCasa G1,面向平均时长 20 到 30 秒的桌面长程任务,这条曲线很有代表性。
我先简单说明图里不同颜色曲线的含义。灰色曲线是以 Wan2.2 5B 这个 Bidirectional Video Generation Model 作为 Video Expert 初始化得到的 Long-WAM。橙色曲线是基于原版 LongLive 2.0 Model 训练得到的。绿色曲线是在 LongLive 2.0 的基础上,用前面提到的 10K Hours 机器人视频数据继续训练,得到的 LongLive 2.0 Robot Model。我们可以清晰看到,用 AR Video Generation Model 做初始化时,Context Scaling 带来的收益非常明显,指标稳定上升。当然 Bidirectional 模型在 LIBERO-Long 这类相对简单的任务上曲线也会上涨,但提升幅度更小,性能上限有限。
大家仔细观察还能发现,当 Context 拉长到 38.4 秒时,RoboCasa G1 上的指标出现一定回落,没有持续上涨。我们也分析了原因:RoboCasa G1 里每个 Episode 的平均长度只有 20–30 秒,训练到 38 秒 Context 的时候,大部分位置都是 Padding,数据集本身缺少足够的长时序有效信号支撑这么长的 T。所以我们判断,不是 Context Scaling 这条路走到头了,而是数据集限制了有效上下文的上限。
另外还有一点:虽然曲线证明 World Action Model 可以不断做 Context Scaling,借助相邻时序记忆提升性能,但在真机部署的时候,我们并不一定都要拉到这么长的窗口。举个例子,我们在 RoboCasa G1 真机实验里,只用 2.4 秒的短时记忆就足够捕捉传送带上运动的杯子,它推理速度是非常快的。Context 拉长本身会带来副作用:Latency 随之增加,需要处理的 Latent Frame 变多。所以大家需要根据自己的任务场景,在 Context 长度和 Inference Latency 之间找到合适的 Balance,后面还有图表会给出详细对比。
接下来是其他 Benchmark 的结果,包括 LIBERO、RoboCasa G1,还有 Domino。Domino 是一个很有意思的动态场景 Benchmark,里面全是移动、滚动的物体,要求机器人抓取动态目标。在 Domino 上,我们训练后的 Long-WAM 相比之前的 SOTA,得分差不多翻了一倍,这也印证了短时相邻 Context 对动态任务的巨大价值。
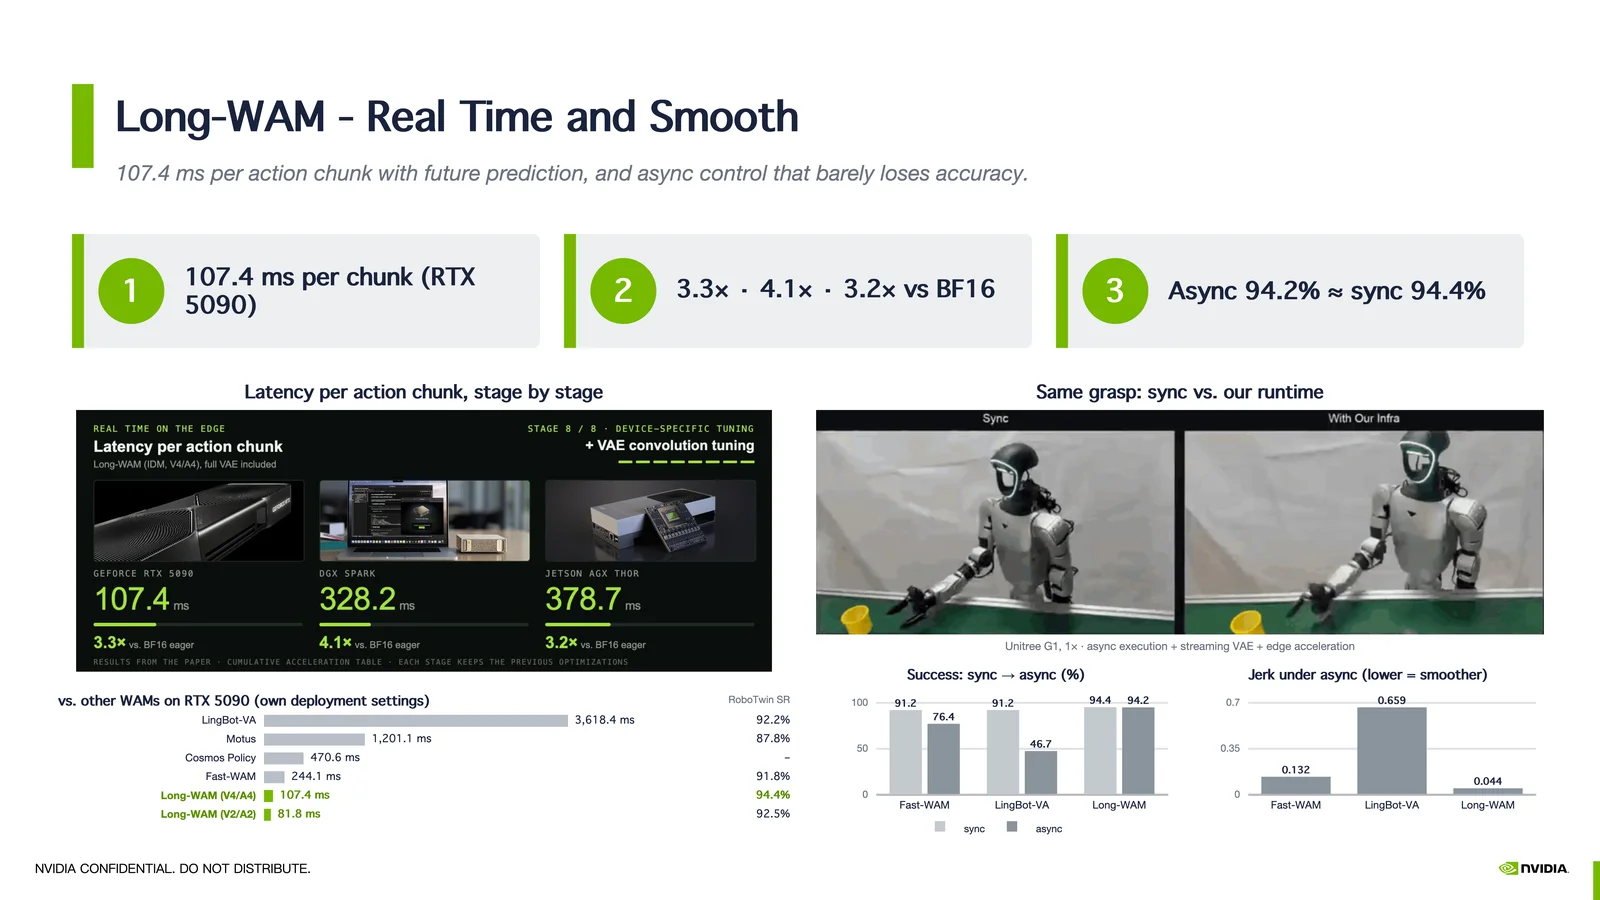
下面是真机和边缘设备部署对应的 Infra 实测数据。可以看到,在 RTX 5090、DGX Spark、AGX Thor 这些硬件上,把 Shared Optimization 和设备专属优化结合起来之后,Long World Action Model 的推理速度平均可以提升 3–4 倍。在 RTX 5090 上,我们可以稳定做到 10Hz N-to-N 推理,Chunk Size 设为 16 到 32,完全满足动态任务需求。我们还可以进一步下调 Video 和 Action Steps,比如降到 4 Steps 甚至 2 Steps,Benchmark 上指标掉得不多,但速度更快,端到端推理耗时可以控制在七八十毫秒,实时性很好。
右侧是抓取杯子任务的对比。可以看到开启异步推理后,Long-WAM 输出的动作轨迹非常 Smooth。我们也做了消融,验证这个平滑性的来源:我们没有针对 RTC 做额外的后训练去适配异步链路,平滑效果主要来自 Context。我们对比了其他 World Action Model 和 VLA,它们开启异步推理之后抖动会非常剧烈,相邻 Chunk 之间衔接很不自然。而 Long-WAM 依靠上下文,前后 Chunk 的推理衔接更顺滑,同时兼顾准确率、延迟和动作平滑度,这个结论很有意思。
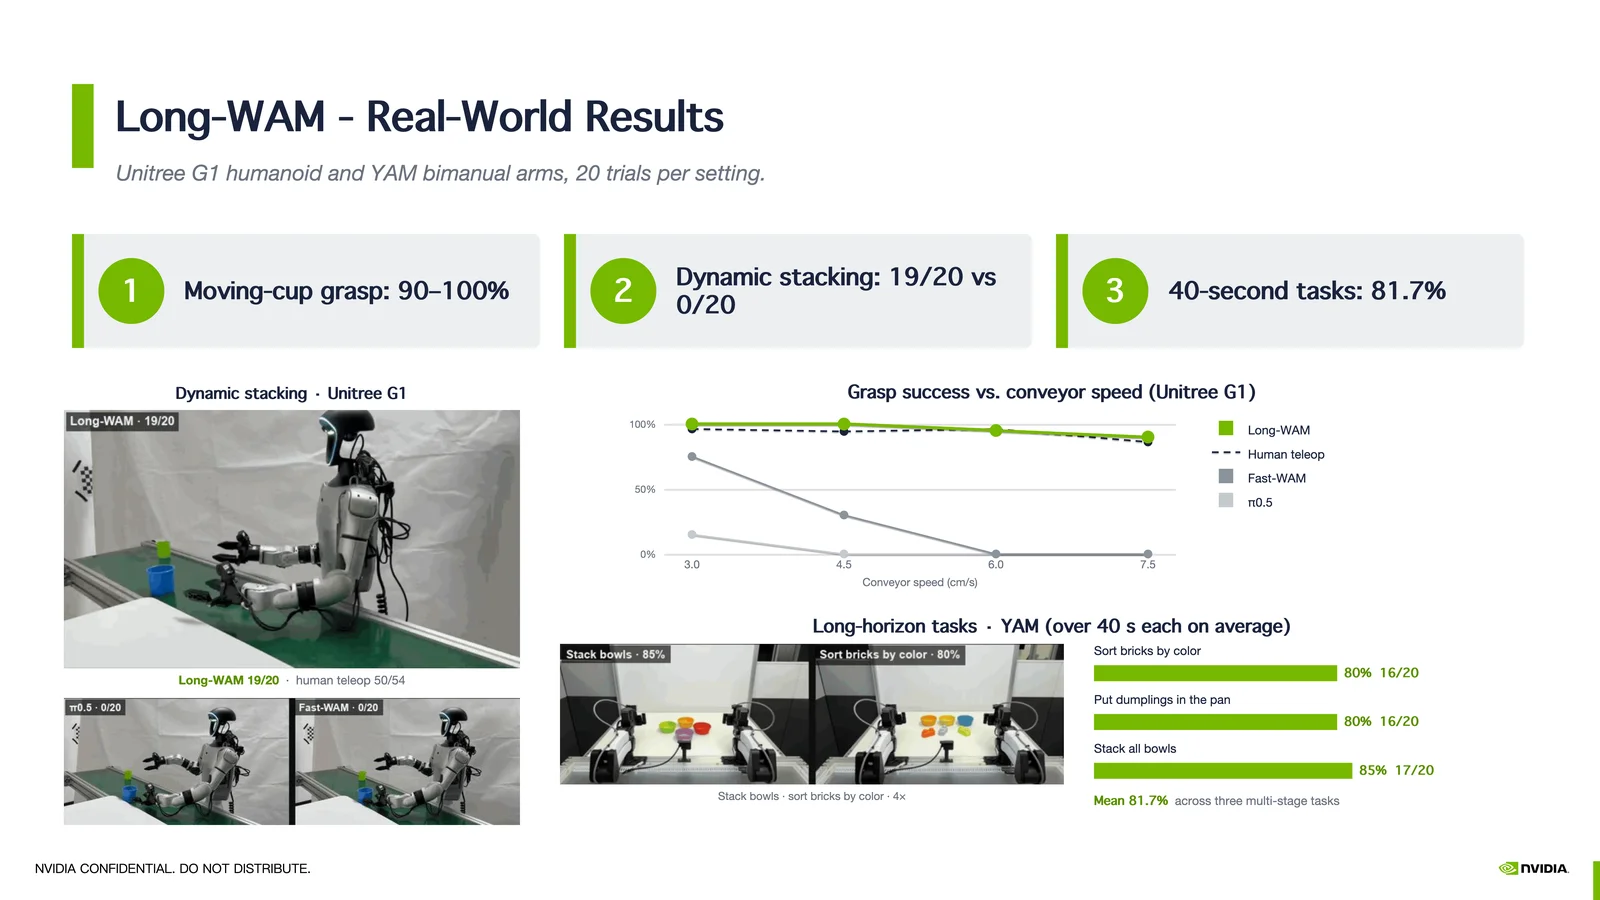
OK,接下来是真机部署的 GIF 图。第一个就是前面提到的抓取移动杯子。在这组消融里,传送带速度从 3 cm/s、4.5 cm/s,一直加到 6+、7.5 cm/s。Long-WAM 在 7.5 cm/s 的速度下依然可以成功抓取,而对比基线在更高速度下基本抓不到。我们还测试了一个更复杂的双杯任务:一个蓝色杯子、一个绿色杯子,需要依次抓起再叠放。蓝色杯子相对好接;绿色杯子口径很小,抓取难度更高,需要精准对齐它的运动位置。Long-WAM 在这个任务上的成功率达到 95%,这个结果我们当时也比较惊喜。我们还在桌面长程任务上用 YAM 双臂机械臂做了部署,任务平均时长超过 40 秒,包含堆叠、抓取等操作,整体成功率保持在 80% 以上。不管是动态抓取任务,还是偏长时序的桌面操纵任务,都取得了不错的效果。
五、与 GPT Astra 的结合
最后这组是项目临近收尾时补充的实验,契机就是当时 GPT-6 Astra 发布。大家发现直接使用 GPT-6 Astra 有着很强的泛化能力:它不依赖机器人本体,也不需要特定场景的数据,依靠自身多模态理解能力就可以解析相机画面、理解任务与意图;凭借 Agentic 能力和代码生成能力,它能够直接写代码调用机械臂执行器,一步步朝着目标完成任务,能力很强。但我们也尝试用 Astra 去做动态任务,结果并不理想,正如前面提到的,Astra 的响应速度太慢,根本无法抓取动态物体,很难适配这类高动态场景。
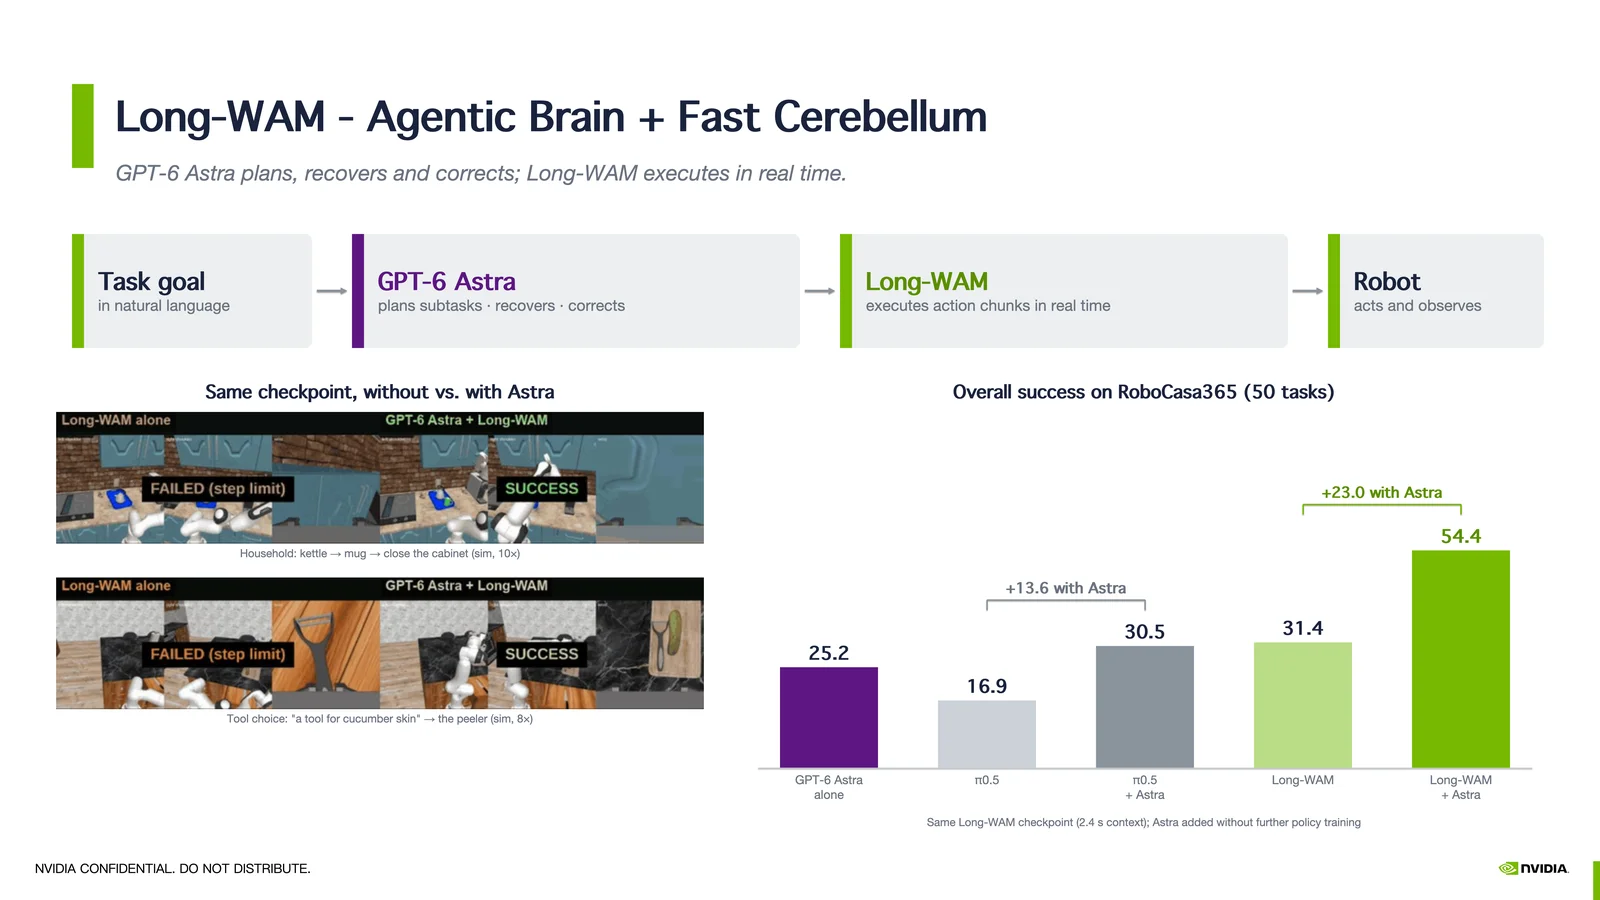
那我们该怎么扬长避短?我们希望充分发挥它的优势。这就是大家常说的 System One、System Two 双层架构:由一个 VLM 作为高层大脑,负责 Reasoning、Planning,Astra 额外承担错误恢复、校正这类能力;而执行原子动作的时候,我们依然使用 Long-WAM,也就是 World Action Model,当然也可以换成 VLA 或者其他 Policy。
我们在 RoboCasa 365 这个更复杂的 Benchmark 上开展测试。这个场景包含场景变化、Mobile Manipulation,不局限于桌面操作,我们代替地去做操作,它可能还是有 mobile 在里面,所以它任务复杂度更高,它可能需要一些 reasoning 在里面,需要一些 planning 在里面。接入 GPT-6 Astra 之后,整套系统的表现有明显提升。
这是我们第一版 Agent System,平均分大约 54 分;纯 GPT-6 Astra 在 RoboCasa 365 上大约只有 25 分。当然 25 分在榜单上面其实不高不低,属于中等水平,也已经有不少优秀的纯 Policy、VLA、World Action Model 工作在这个 Benchmark 上拿到很高分数。但 GPT Astra 的优势是无需额外训练,可以直接部署,大概是 25 分。把它和我们的 Policy 结合之后,发现分数提升到 54 分。我们也把 Astra 和 π0.5 做了组合,π0.5 本身平均分只有 16.9,接入 Astra 之后提升到 30.5,那它也同样优于单独使用 GPT。
这个结果也印证了:一个强大的 Agentic Brain,搭配作为小脑、执行器的 Policy,可以实现更好的效果。高层大脑负责 Reasoning、Planning、校正和错误恢复,Policy 负责精细抓取与快速响应。之所以选择 RoboCasa 365,一是它难度足够高,包含 Mobile Manipulation,动作类型丰富;二是里面有旋钮、按键这类精细操作。我们这个 Demo 的评估是非常公平的,我们只看 camera,不会额外读取 Benchmark 的内部状态信息,当然是不可能的。当我们有一个强大的 Agent 大脑搭配高性能 Policy 时,就会获得非常不错的效果。
同时这里还有一个结论:Policy 本身的底子同样很关键。Long-WAM 单独在 Benchmark 上大约 30 分,搭配 GPT-6 Astra 之后达到 54 分,提升幅度接近 24 分;而 π0.5 本身性能偏弱,接入之后涨幅更小,只上涨大约 4 分。在我们看来,优质 Policy 配合强大的高层大脑,是现阶段比较优的方案。
还有一个有意思的发现,表格里没有单独列出,就是 Astra 本身它不光是对我们的 common unseen,就是在没有见过的任务上面、common unseen 在 RoboCasa 365 的这样的一个 Benchmark 上面提升非常明显,它在 atomic 任务上面提升非常明显。我在这里大概报一个指标,我们 Long-WAM 本身的 Policy 在 Benchmark 上,它的 atomic 大概是六十七八分,接入 GPT-6 Astra 之后可以到八十多分。
它是怎么起到这个作用的?也是在社区里大家经常尝试一个方案,当 Policy 反复出错的时候,Astra 可以引导机器人回到之前的位置重新规划,也就是 Recovery 和 Correction。如果 Policy 输出的动作方向大体正确、只是精度不足,Astra 还可以参考 Policy 的输出,直接修正动作数值,让操作成功。所以它的 atomic 的任务可以从六十多分提升到八十多分。当然,我们希望 Astra 的介入频率越低越好,这样的话,它其实离落地会更近一点,如果介入频率高的话,其实它整个 System 的推理效率是非常慢的。
另外还有一点,GPT Astra 是比较费钱的,大家也知道跑一轮 benchmark,现在大家喜欢跑 robot,跑一轮可能大概要花很多钱的 API 了,基本上以万为单位就跑一轮刷一轮 benchmark,也是很贵的。未来我们怎么把这样的大脑和我们的小和我们 Policy model 结合在一起,是非常有趣的点,既能保证利用到两种模型之间的各自的特性,也能让它们更有机地协同,同时兼顾成本,让整套方案更加经济、高效,也是我们后续想要持续探索的方向。
OK,那下面就是 ask me anything 环节了,非常感谢大家的聆听。整体来说我们 Long World Action Model 的 Motivation 和实验结论都比较清晰。我们的代码已经开源在 NV Lab Long Team 的 LongLive 仓库,和我们之前的其他项目放在一起,大家可以自行下载。还有一个消息,我们的模型近期会合并进 LeRobot 仓库,之后大家可以直接通过 Hugging Face 上 LeRobot 的官方接口,完成 Long-WAM 的训练、评测和推理调用,方便大家在自己的场景里使用。
AMA 互动环节
Q1:Long-WAM 通过扩大视觉历史窗口提升机器人操作表现,如何区分这种收益来自更充分的任务状态估计、对过去动作的隐式记忆、对任务进度的识别?有没有实验能够证明长上下文学习到了短上下文无法获得的时序规律,而不只是减少了信息的缺失?
A1:我觉得是都有的。举个最简单的例子,我们在做 YAM 机械臂上的桌面任务时,这种 context 更多的是对任务状态的估计,比如把不同颜色的杯子做叠放抓取,context 里就包含了这些按部就班的顺序,它更多是一个任务状态的估计。而在动态场景里,它更多的是对物体的判断。所以它既有任务进度的识别,也有对物体运动信息的判断。我为什么选择动态物体抓取和桌面任务这两个例子做真机?也是因为它们刚好反映了 context 的这两个特点。
有没有证明长上下文学到了短上下文无法获得的时序规律,而不只是减少了信息缺失?时序规律这一点对我来说目前还很难讲,我们可能没有专门针对“到底是时序规律还是信息缺失”做观察。但至少从我们的观察来看,哪怕做一些十几二十秒的任务,机械臂的运动也会更加 smooth,我觉得这也算一种时序规律:每个 chunk 的 size 是固定的,多个 chunk 连起来,机械臂要做连续动作,动作本身变得更 smooth,这本身也是时序规律。另外,我的观察是短上下文、长上下文都能学到时序规律。做动态物体移动时,上下文其实比较短,整个任务大概 10 秒左右,不需要把 context 拉到 20 秒、30 秒,其实大概 2.4 秒的 context 就已经能很精准地判断前几秒的运动状态,以及未来夹爪要落在哪里闭合,短上下文也能学到时序规律。长上下文更多的可能是任务状态估计。当上下文越来越长的时候,这种时序规律长短都能学到。这可能是根据我们之前做的一些实验结果的总结。
Q2:如果自回归预训练比双向预训练更有利于长时序操作,这种优势究竟来自于时间顺序建模、未来状态预测预训练与目标生成动作目标之间的匹配?在控制模型规模、数据规模和训练预算后,结论是否依然成立?
A2:先看第一个问题,这种优势来源于哪里?首先时间顺序建模,我觉得是核心,因为我们的 AR 的 video generation model 本身就是 causal 的,所以它本身就是时间顺序建模。相比于 bidirectional,一些 bidirectional model 也有看 context 的能力,比如现在一些主流的双向模型本来就有 I2V 任务,还有一些补帧任务,可以有一些 context 让它去做生成,大家做短剧也是这样,context 可能拉到很长,但时序建模不够长。我觉得 AR 本身这种训练就是比较好的,这种 causal 的注意力机制本身就在学习时序因果关系,这是我觉得 AR 能 work 的一个原因。
在控制模型规模、数据规模和预训练预算后,结论是否依然成立?我觉得是成立的。因为我们最近也关注到,Cosmos 3 Simulation 是在 Cosmos 基础上做的一个世界模型,主要是大家传统想象中的世界模型,可以做仿真,根据 action 精准建模未来的动作和交互,它是纯 generation model,并不是做 action,它也是以 AR 的方式去做的。以 AR 方式去做,我们也可以关注到它做得非常好、非常准确,尤其当时间拉长到十几二十秒的时候,因果逻辑也做得比较好,所以我觉得 AR 在 scaling 情况下仍然有特性。当然可能 Long-WAM 大家觉得 data 量级没有 scaling 上去,Cosmos 的 scaling 是证明了这个事情。
另外还有一点,AR 这种 chunk by chunk 的 video generation 方式其实跟 world action model 也很匹配,我们的 action 也是 chunk by chunk 出的。在 world action model 里,不管是 IDM 也好,还是 joint denoise 也好,都是 chunk by chunk 出的。AR 本身的推理方式就是 chunk by chunk 的,上一个 chunk 在 KV cache 里面推,AR video generation 的推理方式跟 model 天然更匹配,也就是说它的上游 foundation model 和下游应用,我觉得推理方式是一个 match,这可能也是 AR work 的原因。
Q3:视频世界模型与物理世界模型之间还有多大的差距?
A3:这可能是放在世界模型里面了。如果大家关注,可以关注一下 Cosmos 这边的一些工作,我们做的一些 infra、还有一些 training 的东西也会放在 Cosmos 里面。可以关注到 Cosmos 做得越来越好了,其实它在逐渐减少这样的距离。Cosmos 这样的视频世界模型也能直接出非常准确的动作轨迹,也可以根据我们 input 的一些动作标定,生成非常逼真的视觉交互,包括柔性物体抓取的运动、褶皱都非常逼真,整个 action 的控制也非常 smooth,所以我觉得会越来越快。
从物理世界模型做好来看,我觉得未来对机器人的训练也是一个 speed up。我们现在大家虽然在做 world action model,从百万 hours scaling 到千万 hours 甚至上亿 hours 去 train 这样的 policy model,可能 scaling 速度是比较慢的,因为本体数据采集也是比较困难的,当然有 ego,这些还是比较慢的。当视频世界模型或者仿真世界模型做得比较好的时候,大家可以用 NVIDIA 的 Cosmos、Isaac 这样一系列平台,同时它既能提供准确的仿真,又能有很好的物理特性,它的 camera 视角、光流跟现实生活中都一模一样的时候,我觉得它就会变得非常实用,对机器人的训练会非常有帮助,特别是以后大家做强化学习,在真实场景中比如 real to sim to real,现在大家比较火,效果会越来越好,所以我觉得很快。
Q4:有什么办法能缓解 Astra 的推理实时性问题吗?
A4:其实挺难的,我不能代表 OpenAI 去解决这个问题。如果在 system 里面,我们更关注的是大小脑交互频率,也叫快慢系统交互频率。我们觉得 agentic model 本身它的交互频率要低一点。我经常举一个很简单的例子:比如你要进门,或者进一个房间去找钥匙,首先打开门,这些操作是下意识的,不需要大脑参与,不需要 actor 参与,你的 policy 做打开门,加上 mobile、navigation 走进去,这个动作很简单,不需要 reasoning、不需要 planning 就可以做到。当你到一个房间里面之后,要环顾四周,判断钥匙可能在哪个地方,这个时候才需要大脑去做 reasoning 和 planning,然后再去调用 policy。我觉得交互频率可能是一个比较重要的点,但现在大家用 actor 的交互频率都很高,动作动一下,Astra 推了一次,调一次 API 钱又贵、速度又慢。我们也关注到最近产业界有些工作会蒸馏到一个百 B、几十 B 的 VLM,把 LLaMA 本身在具身的能力尝试蒸馏过来,那也是一种尝试。
Q5:每一个部分的算力用了多久?
A5:我们 train LongLive 2.0 花的算力相对来说是比较多的,因为我们是纯 video 的训练,大概用了 128 张 GPU,训练了大概 20 天。大家也可以用 60 多张 GPU 训练,把天数拉长就可以,大概是这样。
这里我还要提一个点,我们在做 video 训练,其实很类似于现在大家在做 VLA model 预训练,我们没有把 action 一开始就训练进去,有两个原因。第一个原因是,我们当时没有找到很好的跨本体解决方案,不管是跨 head 也好,还是把所有 DoF 全部拼成一个长的维度去训练、去 padding 也好,这是当时看到的几种做法,但我们不确定哪种方法更有效,就不想把算力和时间浪费在最后验证哪种跨本体训练方式更有效上面,因为我们要做的是 scaling 这件事情,我们在小规模上肯定证明了。这也是当时为什么没有做跨本体预训练,只做 video 的一个原因。用的最久的肯定也是这部分。跨本体我们后面也会尝试,直接做跨本体的预训练,video AR 的 video 和 action 直接会一起训练,这部分当然会花更久的算力。下游任务的一些 world action model 训练相对来说不算太复杂,比如做真机的时候,在 G1 上面去采样一些 demo 去做训练,就跟大家做真机的 demo 是一样的,不是很多。
Q6:长上下文带来的收益是否存在规模规律?
A6:我觉得它一定是存在的。首先在我们的实验里面,机器 data 没有那么长,所以目前这个规模我们只能看到这几十秒,这是第一个点。当任务更长的时候,它更有收益,也有可能。另外一点,我觉得它的收益还来源于它的实际使用价值,它的 inference latency。比如说 10Hz 推理,大概 2.4 秒可以做到;拉到 4.8 秒的 context,基本上也可以做到实时;真把它拉到 30 秒、40 秒的时候,action model 推理本身就不够实时,可能也比大多数 world action model 快,但不满足我们想要做快速动态任务的需求,我觉得它收益还要考虑部署的速度。我个人 prefer 大概 2.4 秒到 4.8 秒这样的一个短期记忆。
为什么我觉得它有个短期记忆?我觉得这样短期记忆是根据 motion,或者我们做一些原子的抓取,哪怕是 10 秒的一个任务,我们一直往前抓,或者一直往前走 10 秒这种任务,它对自己的 motion 有一个记忆的判断。当然记忆还有另外一个层面就是长期记忆,你的人格、你的长期任务的拆解。长期记忆我觉得本身不是 policy 去做的,在这个时代,policy 的意义是它有对 motion 的理解,它有做 action、机器动作的能力,这种长期记忆可能我们交给 agent 就好了。大家有自己的 harness、有 skills、有这样的历史文件,Astra 本身也有 KV cache,长期记忆交给它就好。我 prefer 的一个观念是 policy 去做 second level 的记忆,days、hours 这样的 level 记忆是交给大脑去做的。
Q7:与其将所有的历史帧输入模型,是否可采用事件驱动、关键帧选择或者动作摘要,在相同计算预算下获得相近甚至更好的效果?对于常识与操作,你们认为上下文扩展和记忆的分界在哪里?
A7:这其实跟我刚刚说的点是非常类似的。我所说的临近记忆为什么是连续?因为你只有连续,你才知道杯子的运动轨迹、运动规律。当然,如果你要做一些非常长的任务,比如说要做个饭,要做几十分钟,不是 second level 的,可能切菜是一个记忆,那你切完菜之后,好像不需要存下来你切菜的过程,你只要有一个关键帧,知道你切了菜就可以。这个东西对你下一顿去颠勺做 whatever model,或者做 policy 有帮助吗?其实没有帮助。我觉得它更多的是一个任务状态的估计,它交给大脑是更合适的。所以您说的这些事件驱动、关键帧选取,更多的是和大脑去做,是对任务状态的一个估计,或者是你一个长期的一些记忆。我觉得上下文扩展的分界在于 policy,我支持 second level 的记忆,它既兼顾短期 motion 的观察、下意识的动作,还能兼顾 inference efficiency,然后更长的一种记忆,我觉得交给大脑是更合适的。
Q8:长程任务是怎么定义的?
A8:我在这里定义长程任务,可能是我们的一个通用的 common sense,大概有 2 点。第一是你做的单个原子任务比较长。原子任务也有很简单,抓个杯子可能 5 秒钟,当然你也可以把这个杯子抓到哪里,然后叠来叠去、动来动去,单个 episode 也会很长,这也是长程任务。另外还有复杂组合任务、mobile manipulation,还有各种复杂交互,多个任务中间有衔接点,比如说做饭,比如说 RoboCasa 365 里面的一些例子。这是我们对长程任务的一些定义。
Q9:怎么看接下来 agentic robot 场景下 WAM 作为 policy model 相比于 VLA 有哪些优势?
A9:这个其实是我一直在思考的一个问题,也不是最近,是之前一直在思考的问题。我觉得 Sergey Levine 说的一句话挺对的,VLA 也好、world action model 也好,本质上并不是在模型架构上面、在推理方式上面,不是它的核心,本质上是怎么利用数据。VLA 我觉得它本身的一个优势,它继承了 vision 和 language 能力,它有很强的多模态的语义能力和理解能力,语义能力是非常强的。World action model 对这种 language 理解能力相对来说偏弱一点,world action model 有大量的视频数据训练,它对动作的变化、未来的预测,特别是 motion 的理解能力、对 motion 变化的预测会更强。
在我的观察里面,world action model 做一些精细动作抓取会更强,但是做一些需要有语义理解的任务,举个简单例子,RoboCasa 365 我觉得 world action model 其实理论上就很难做过 VLA,因为 VLA 它有一部分语义能力,它需要做任务的拆解、reasoning,这部分它就很强。World action model 的 reasoning 可能是对于一个短期动作、对一个状态的预测,它不是 reasoning 这种能力,所以我觉得这是它俩本质的差别。当然如果有 agent 大脑之后,world action model 没有 reasoning 能力也可以,这个能力交给它了,我们只需要把精细的操作、manipulation 原子动作做好就可以。所以这是我觉得 world action model 好的原因。大家也可以类似于派一样,把 video 的 training 和 VLA 结合在一起,这样就可以兼顾 motion 预测,也兼顾语义理解能力,有这样一个超强 policy,也是可以的。我觉得这是他俩的一个区别。
Q10:你们是否比较过联合生成潜在未来预测和动作直接生成?在什么条件下前者的收益足以抵消额外的计算成本?
A10:这个我们是比较过,大家在 paper 里面其实可以看到,联合生成也好、IDM 也好,还是直接生成也好,我们直接生成 action 也好,我们都做了。直接生成 action 的话,整体的推理方式跟 Fast-WAM 是比较像的,整体来说它会稍微低一点,它的学习能力就会相对差一点。我们的实验证明还是 IDM 要比 code denoise 的效果要好一点,对 action 的建模会更精准一点,大概是这样的。点数差距也不大,在 benchmark 上观察至少是类似的。
在我们的一些特定场景,我们的一些 demo 场景都非常特定,没有很强的泛化性的真实世界应用,因为 Long-WAM 本身不是作为一个 foundation model 去做的,然后我们也没有对比过,但是在这些特定场景中基本上 code 也好、IDM 也好,没有什么太大的区别。在我们的 infra 下,大家都能做到适合的 N to N 的推理,我们之前有个 efficiency 的对比,code 差不多是七八十毫秒、80 毫秒左右,IDM 差不多是 100 零几毫秒,所以基本上都接近 10Hz,基本上都可以满足大家使用。
Q11:WAM 的长上下文长度是否存在 scaling law?
A11:在 second level 级别,我们觉得至少是观察到了一个 scaling law,这是我们在 Long-WAM 在 AR 的 model 里面观察到的。当然比如说 LIBERO-Long 那个曲线上面,在 bidirectional 也能观察到一个上下,这是我们的观察。另外我们在和其他一些非常优秀的工作做 research 交流的时候,他们也观察到类似的结果,包括一些学术界的机构,还有工业界的机构,包括 VPP 的 team,他们都观察到了,当 context 上升的时候,基本上都可以提升 performance。可能我们是把 context 切得更细,不同粒度 context 对比了一下,基本上也存在一个 scaling law。
Q12:下一步可以往哪些方向研究?
A12:这个还比较机密了。我感觉现在知识都是共享的,大家能想到在具身智能领域有哪些痛点,我们也会想到那些痛点,我们就会解决这些痛点,包括 infra,包括 agent system 和 policy 的配合,这些都是痛点。
Q13:WAM 是否可以跨机器人平台复用,降低部署成本?
A13:这个是可以的,大家可以参考一下现在工业界大家做得非常好的这些 pretrain model,大家都是跨本体的预训练,基本上单臂、双臂,latent action 的维度也比较大,基本把所有的自由度都囊括进去了,基本上都可以跨本体。大家预训练都是这样做,大家也可以期待一下 NVIDIA 马上发布的 GRIT 2.0,也是类似这样的。其他工作都做得非常好,我觉得这个问题可能不是我来回答的,大家已经回答过了。
Q14:同等算力下,WAM 相比于 VLA 的优势有多大?
A14:我感觉我也解释了,WAM 的优势就在于它对 motion 和精细动作的准确建模,然后 VLA 它更多的是有 language 的语义理解能力。在同等算力下,我觉得 data 是关键,怎么利用、怎么学习到不同种类 data 是关键,模型架构不关键。目前来看,这是 VLA 的研究。大家 video prediction 或者 video data 相对来说还不太好吃,WAM 本身 video data 是非常好的,scaling 能力也很好,就 video data scaling 上面,所以我觉得它就挺有优势的。当然 scaling 这个 video 的 data 它对 3D 要求也很高。
Q15:长记忆和 scaling law 哪个更值钱?
A15:这个问题我没有 get 到,长期记忆和 scaling law 哪个更值钱?scaling law 可能指的是 model parameter 参数 size 的 scaling law,记忆可能是我们说的 context scaling law,我觉得都重要。哪个更值钱,我可能很难判断。从 model efficiency 角度更重要,但是我觉得 policy 本身大家不需要 scaling 太大吧,我觉得目前大家坚持的 7 到 14B,或者是 2 到 14B 或者 2 到 7B 这样的 size 是够的,因为它足够快,它能够满足在边缘设备上的 fast inference。大家把 world action model scaling 到 100B,我觉得也没有必要,它出动的速度也很慢。
Q16:为什么长任务会是 VLA 难做的部分?
A16:按照我前面那个例子,RoboCasa 365 上面 VLA 会比 world action model 强,因为它有 language 的一些 reasoning 和 planning 的能力在里面,它会强。我觉得它难会难在做一些精细的 atomic 任务上不如 world action model,所以相对难一点。我觉得这样理解是更合适的。
Q17:怎么看 GPT-6 Astra?VLA 和 world action model 会被淘汰吗?
A17:按照我的理解是不会的。正如我的例子,GPT-6 Astra 能不能做这样的动态抓取?我觉得未来都不可以,因为 GPT Astra 这样的多模态泛化能力,第一来源于它 model 的 scaling,第二来源于它有很多 agentic 的数据训练,它本身就是一个 reason + tool calling 这样的工作。另外还有之前有很多 3D Blender 的 data,还有一些 computer use 这样的 data,它不是拿专门的 robotic data train 出来的能力的,这些能力让它本身就有了一个多模态的理解能力,还有 3D 理解能力,所以它能放在机器人里面。它本身还是 agentic 的一个 model,那就需要 agentic 多轮 call,跟你机器人看到 camera 然后调整动作、看到 camera 调整动作,多轮的交互其实是一模一样的。所以是这两点带来的。然后我觉得这种推理方式是做不了我前面说的动态任务。我觉得 VLA 和 world action model 还会存在。我前面说的进到一个门里面,有哪些是你下意识往前走、开门的动作,哪些是你需要判断思考,或者是你需要矫正你的动作,它其实有不同的职能。我觉得大脑也比较 agentic,大脑也有必要存在,然后 policy 也有必要存在。
Q18:如何看待事件级动作或者 subtask 的做法?Long-WAM 的收益如何?
A18:我觉得收益是非常显著的,就在 RoboCasa 365 上,我们就观察到拆 subtask、用 agentic 去拆 subtask,它的收益就非常明显。因为 world action model 本身我觉得跨 subtask 的任务的效果还不是很好,它在单 task 这种 atomic 的动作执行上会非常的准确,然后哪怕有个短期的 scaling 之后,它做这些任务也会做得更准。比如说打开门,把一个壶抓起来放到某个位置,单 task 这样的任务它会做得比较准确。拆解肯定是更好的。
Q19:不生成未来视频,只保留潜在视觉状态,能否达到同效果?
A19:我们在各个 benchmark 上对比,它会稍微低一点,整体得分会低一点。但是在真机上,我们没有观察到特别明显的区别。如果我们把每个 benchmark 都去对比,确实会低一点。然后 inference 上它又领先一点,所以我觉得各有优势吧。
Q20:Long-WAM 本身提供了哪些 checkpoint?主要汇报哪一种?
A20:Long-WAM 本身每个 checkpoint 都提供了 code denoise 也好、IDM 也好,我们主要汇报 IDM,是因为我们的速度可以做到 IDM 也可以实时推理,所以我们是这么想的。
Q21:你觉得 VLA 会取代 WAM 吗?
A21:我还是引用 Sergey Levine 的观点,关键是我们怎么利用数据,那我觉得 VLA 和 WAM 合并也是可以的,派本身也就是这么做的。
Q22:Long-WAM 的提升究竟来自于上下文还是自回归视频预训练?
A22:都有。我们那个 curve 其实 ablation 挺详细的,没有自回归预训练和有的也有 curve 的对比,然后上下文长短也做了对比,大家可以观察一下,我觉得是都有的。
Q23:机器人只看人类视频就能学习操作,那还需要机器人数据吗?
A23:这个问题还挺关键的,我觉得还是需要的,我只能站在我的观点去讲,也不一定对,因为我们也没有做大规模的跨本体这样的操作和 ego view 的 data 的一些研究,能给大家一些经验。首先人类数据采集是很方便的,不管是中国也好、东南亚也好,最早在东南亚,家政、家庭妇女、工厂的工人,还有大街小巷一些人头上戴一个摄像头就能采数据,把自己手机挂在头上、买一个绷带就可以采数据了,它是非常便宜、非常能快 scaling 的一个方式。然后 ego view 的 data 本身是一个五指的 data,换成 skeleton 跟未来大家要做灵巧手也是比较类似的,其实很有帮助的。现在很多做夹爪,可能灵巧手和夹爪相比在指尖级别的动作可能还没那么有帮助,在灵巧手上我觉得还是有帮助的。当然如果能学好之后,未来还要牵扯到一个跨本体的问题,不同本体、不同硬件的机械频率、机械特点都不一样,所以还是差距很大的。我觉得也是需要有机器人数据的,就跟大家自己去看视频学游泳一样,我们可能看视频就能学会游泳的动作,你看视频就能学会打乒乓球的动作,可能你要自己再用你自己人再去打才能打得更好、才能游得更好,我觉得还是需要的。
Q24:视频数据集是专门采集的机器人操作数据吗?
A24:我们用的开源数据集,数据集基本上都是公开的,大家可以从 paper 里面找到,也可以从这些开源数据集的工作里面去下载。它有机器人操作数据集,也有 ego view 的 data,都有的。我们用的数据量级还很小,大家要真想做 foundation 的话、做 pretrain 的话,其实 data 来源能更多,基本上现在大家都能做到百万 hours 的这样的 pretrain。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册