作者:Mind Lab
原文:https://www.mindlab.im/updates/adapting-causal-encoder-decoder-models-with-lora
摘要
新架构改变了 LoRA 该放的位置
DeepSeek-V4.1-Flash 是因果编码器–解码器:共享 KV 缓存的大部分由编码器的 20 层写入,再由解码器的 20 层读取。
LoRA 在这个模型上照样能训练,但挂满每一层就用不上这种结构:适配器放在哪里,决定了多个适配器能否共用一份缓存。
只训解码器就够了
在解码器的 20 层上挂秩为 16 的 LoRA,验证集损失接近挂满 40 层的 LoRA,三个种子的均值为 0.296 对 0.293,适配器参数只有一半;
与同样大小、挂在编码器上的 LoRA 相比,每个种子上的验证集损失都低 0.036 到 0.058。再冻结第 20 层的 KV 写入投影也没有代价,还能让多个这样的适配器在推理时共用一份压缩 KV 缓存。
少挂模块、冻结 ViT、把 Engram 留在 CPU
在完整的全线性层秩 16 设置下,压缩器、查询上投影、分组输出投影和路由专家的 down 投影都不需要 LoRA。
冻结 ViT 和对齐器时,四个配置中有三个的验证集损失持平或更低,峰值显存降低 5.2 GB;两张 Engram 表留在 CPU 上,每张卡省 22.9 GB。
训练支持已提交上游
我们向 Megatron-LM、Megatron-Bridge、vLLM 和 veRL 提交了六个 PR,让这个模型可以训练,并打通 LoRA 适配器从训练到采样的链路。
已经落地
Mint Recursive 现已支持 DeepSeek-V4.1-Flash;在一家客户的专有业务基准上,经过后训练的模型比官方 API 高 5.96%。
什么是因果编码器–解码器
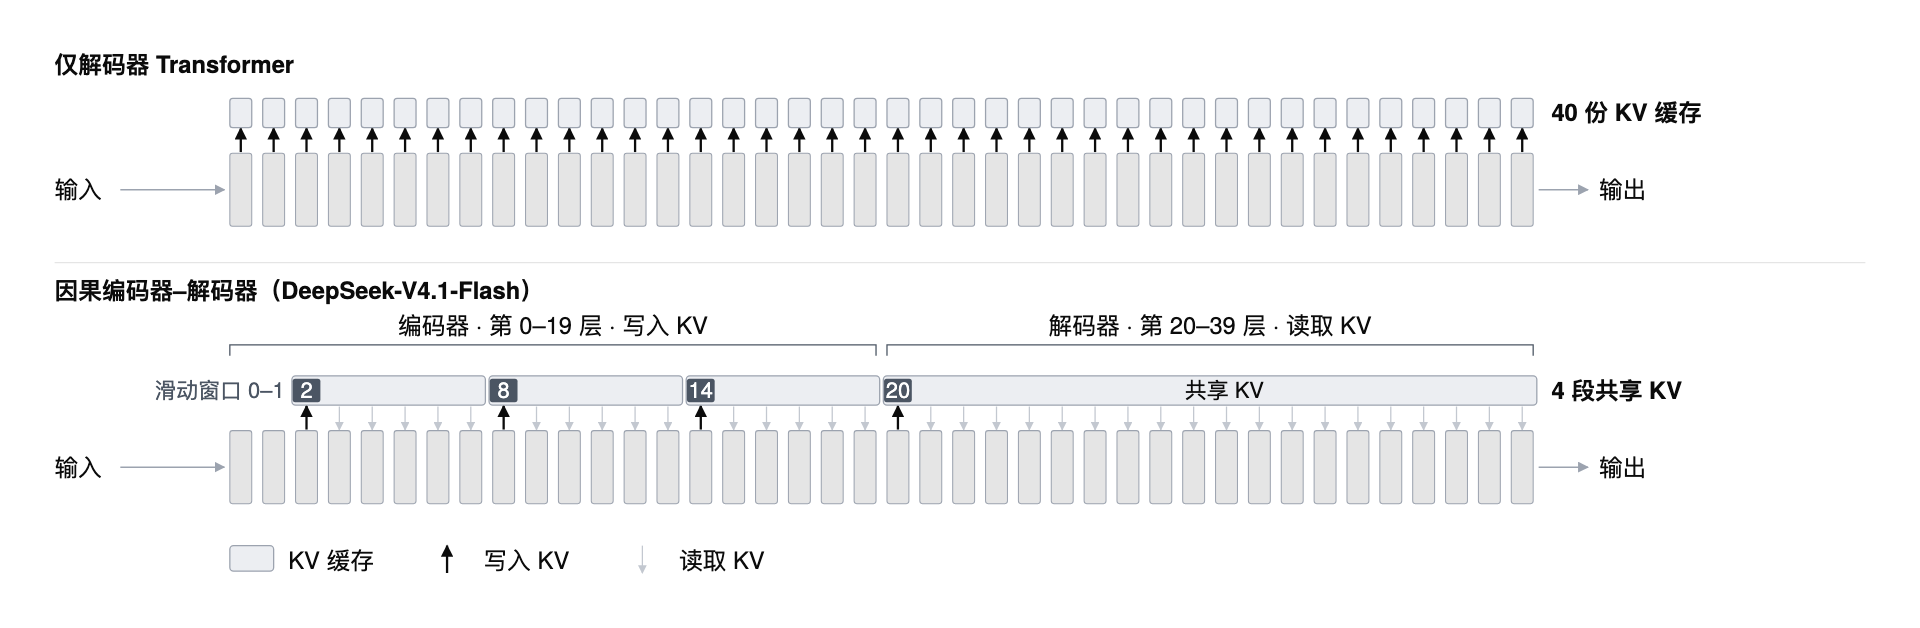
DeepSeek-V4.1-Flash 采用了一种新的模型架构 。常见的仅解码器 Transformer 是一摞相同的层,每一层都为见过的每个 token 保存自己的键和值(KV),所以 40 层的模型要缓存 40 份。DeepSeek-V4.1-Flash 仍然是逐个预测下一个 token 的因果语言模型,但它把 40 层分成职责不同的两半:
- 编码器是第 0–19 层,负责读取输入,并通过压缩稀疏注意力 2(CSA2)写入压缩全局 KV 缓存中的大部分内容。
- 解码器是第 20–39 层,主要负责读取这份缓存并生成输出。
这份缓存是多层共享的。只有第 2、8、14 和 20 这四个 kv_source 层写入它,之后的层都复用前面离自己最近的那个 kv_source 层写的 KV;第 0 和 1 层只用滑动窗口注意力。
原本每层一份、共 40 份的缓存,就这样变成了 4 段共享缓存(图 1),此外每层还保留自己最近 128 个 token 的滑动窗口。
第 20 层是两半之间的枢纽。它既是解码器的第一层,又是最后一个 kv_source 层:它的压缩器把编码器末层的隐藏状态转成 KV,供包括它自己在内的解码器全部 20 层读取。
第 20 层写的就是解码器看到的全部编码器信息,所以它的 KV 写入投影决定了多个适配器能否共用缓存。
除此之外,模型还有带图像专属偏置的 MoE 路由器、带对齐器的 ViT、流形约束超连接(mHC),以及两张各约 3.84 亿行的 Engram 查找表,分别在第 1 和 14 层读取;权重采用 FP8 和打包的 MXFP4 格式(图 2)。

对 LoRA 来说变了什么
LoRA 本身可以照搬。让训练栈支持 DeepSeek-V4.1-Flash 是任何微调都需要的一步,放在文末介绍;做到之后,挂在每一层上的适配器就能像在以往模型上一样训练。只是这样做,就用不上这种架构在推理上的优势。
在仅解码器模型上,适配器默认挂在每一层,每个适配器本来就需要自己的一份 KV 缓存。而在这里,适配器放在哪里,决定了它的推理成本。
编码器上的适配器会改变后面每一层都要读的共享 KV,每个适配器就得有自己的一份缓存;解码器上的适配器只改变怎么读这份 KV,以及每层自己 128 个 token 的窗口。
冻结第 20 层的 KV 写入投影后,共享的压缩缓存仍是基座模型的那份,多个适配器可以共用。我们的混合 LoRA 服务正依赖这种共享 。
这就是本文的核心问题:适配器放在哪里,才能训得好、成本低?
解码器正是便宜的位置:只占一半的层,还能共用缓存;关键在于挂在那里的适配器能否学得和挂满所有层一样好。
这也关系到我们如何践行“从真实经验中学习”:每个从真实交互中训练出来的专家,都是同一个基座上多出的一个适配器;
适配器的训练和推理成本越低,模型就能越频繁地吸收新的经验。下面先回答适配器该放在哪里,再介绍让这个模型能训练起来的工程工作。
适配器该放在哪里
实验设置
我们在 Geometry3K 上比较了四种适配器配置(表 1),每种配置都在给 ViT 和对齐器挂 LoRA、不挂 LoRA 两种情况下,各用三个种子训练。无论挂不挂,模型都照常看到每张图,区别只在于是否适配 ViT 和对齐器的权重。
所有实验使用相同的数据顺序、优化器和并行设置:4 个节点、每节点 8 张 H20,BF16,上下文并行 2、专家并行 16,均匀分块的全量重计算,优化器 CPU 卸载,秩为 r 时 LoRA \alpha = 2r,merge=False,最大长度 4,096 个 token,动态批处理。
训练使用 Geometry3K 训练集的 1,472 道题,验证使用其验证集的 224 道题;图在其他划分中也出现过的题目都已剔除。我们报告的验证集损失是第 50、70 和 100 步三次评测的平均。
所有实验都训练 100 步,学习率取 5e-5,依据是平台期的表现。2e-4 前期下降更快,第 10 步时已是 0.42 到 0.54,而 5e-5 为 1.1 到 1.5,所以从 1e-5 到 2e-4 的 8 步学习率扫描偏向了它;训满 100 步后,5e-5 的平台期在四个配置上都比 2e-4 低 0.006 到 0.044。
| 配置 | 挂 LoRA 的层 | 秩 / α | 可训练参数 | fp32 主权重(GB) | 峰值显存(GB) | 每步时间中位数(秒) |
|---|---|---|---|---|---|---|
| 全线性层秩 16 | 0–39 | 16 / 32 | 1.87B | 7.49 | 87.82 | 9.16 |
| 编码器半边(秩 16) | 0–19(编码器) | 16 / 32 | 0.94B | 3.76 | 87.23 | 8.37 |
| 解码器半边(秩 16) | 20–39(解码器) | 16 / 32 | 0.94B | 3.76 | 87.23 | 8.38 |
| 全线性层秩 8 | 0–39 | 8 / 16 | 0.94B | 3.74 | 87.2 | 8.6 |
表 1. 各适配器配置,以及挂 ViT 适配器训练 100 步时的开销。可训练参数为 fp32 主权重字节数除以 4。秩 8 配置在所有位置都把秩减半,ViT 也不例外。
无论减半深度还是减半秩,fp32 主权重都会少一半,但峰值显存只变化 0.6 GB:在优化器卸载下,主权重和 Adam 的一阶、二阶矩都放在主机内存里,所以省下的主要是主机内存。实测的每步时间中位数,半深度适配器缩短 0.78 到 0.79 秒,秩 8 缩短 0.56 秒。
只训解码器就够了
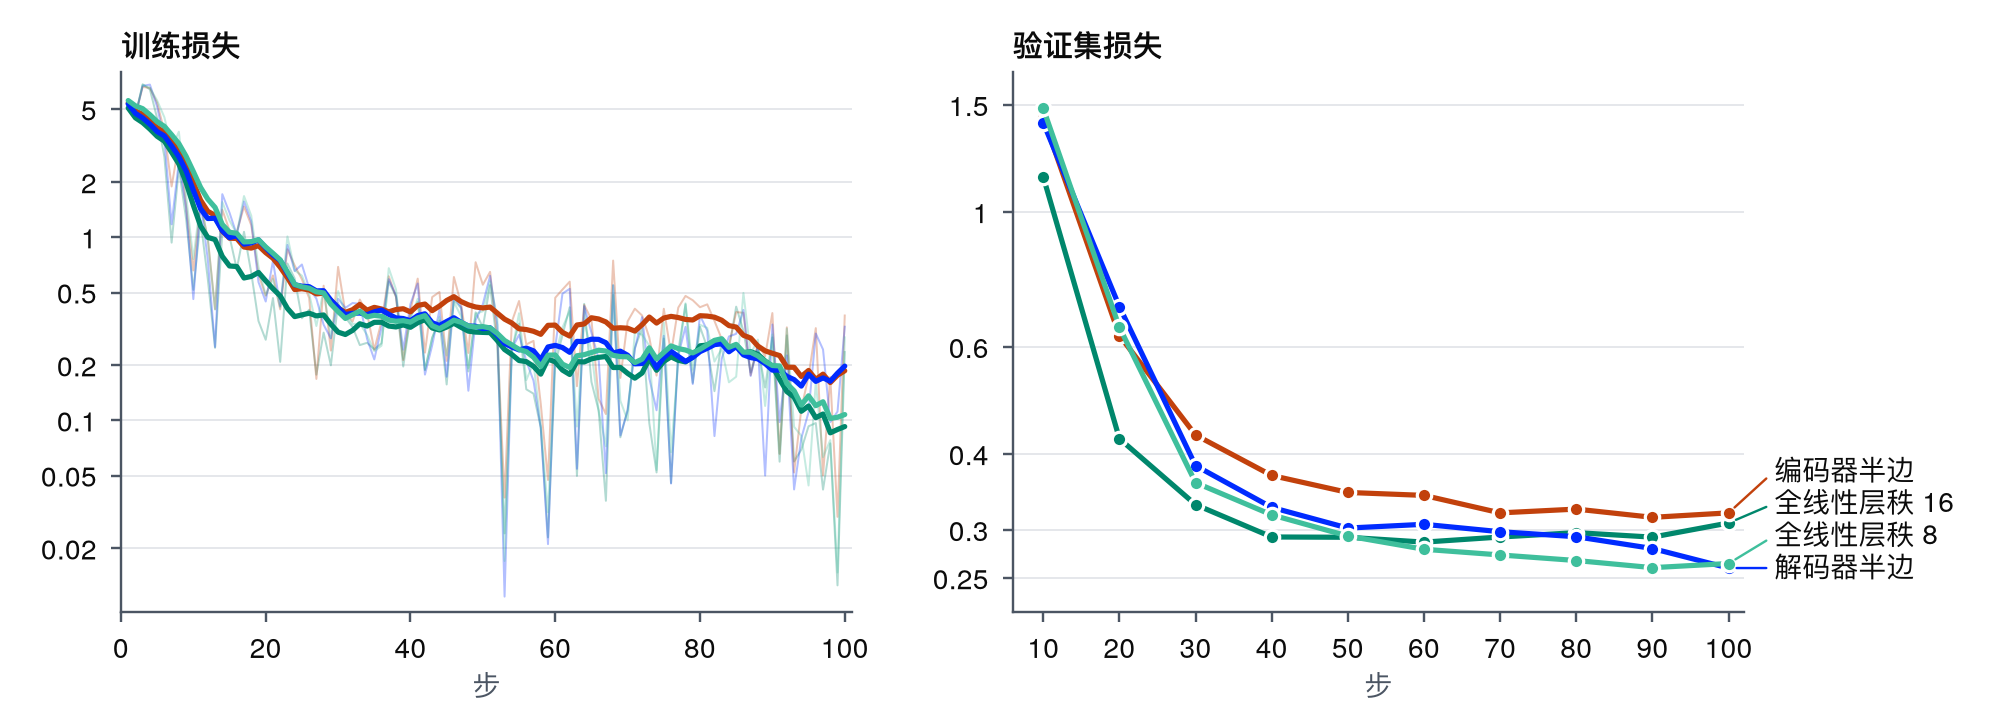
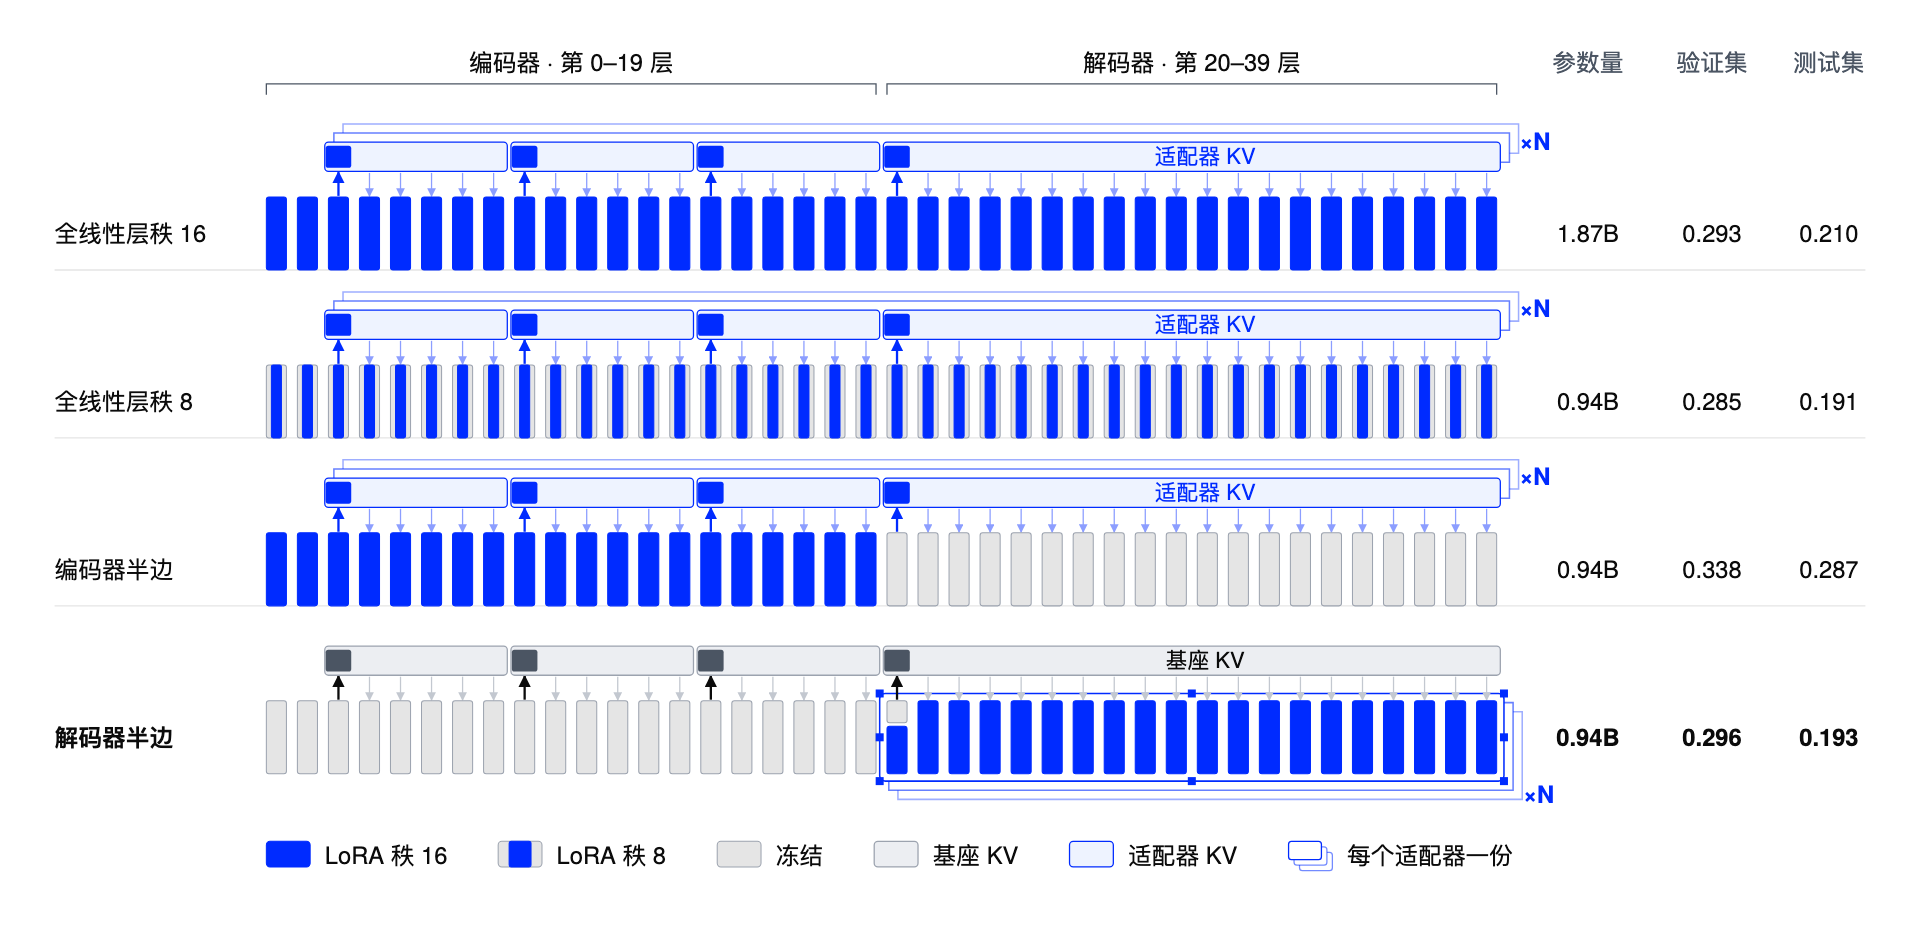
四次训练的损失都先快速下降,随后进入平台期:验证集损失到第 30 步时约为 0.33 到 0.43(图 3 右)。全线性层秩 16 早期下降最快,训练损失最后也最低(图 3 左),这正是它多出的容量该带来的;但在验证集的平台期,解码器半边的适配器只用一半的可训练参数就追上了它(表 2、图 4)。
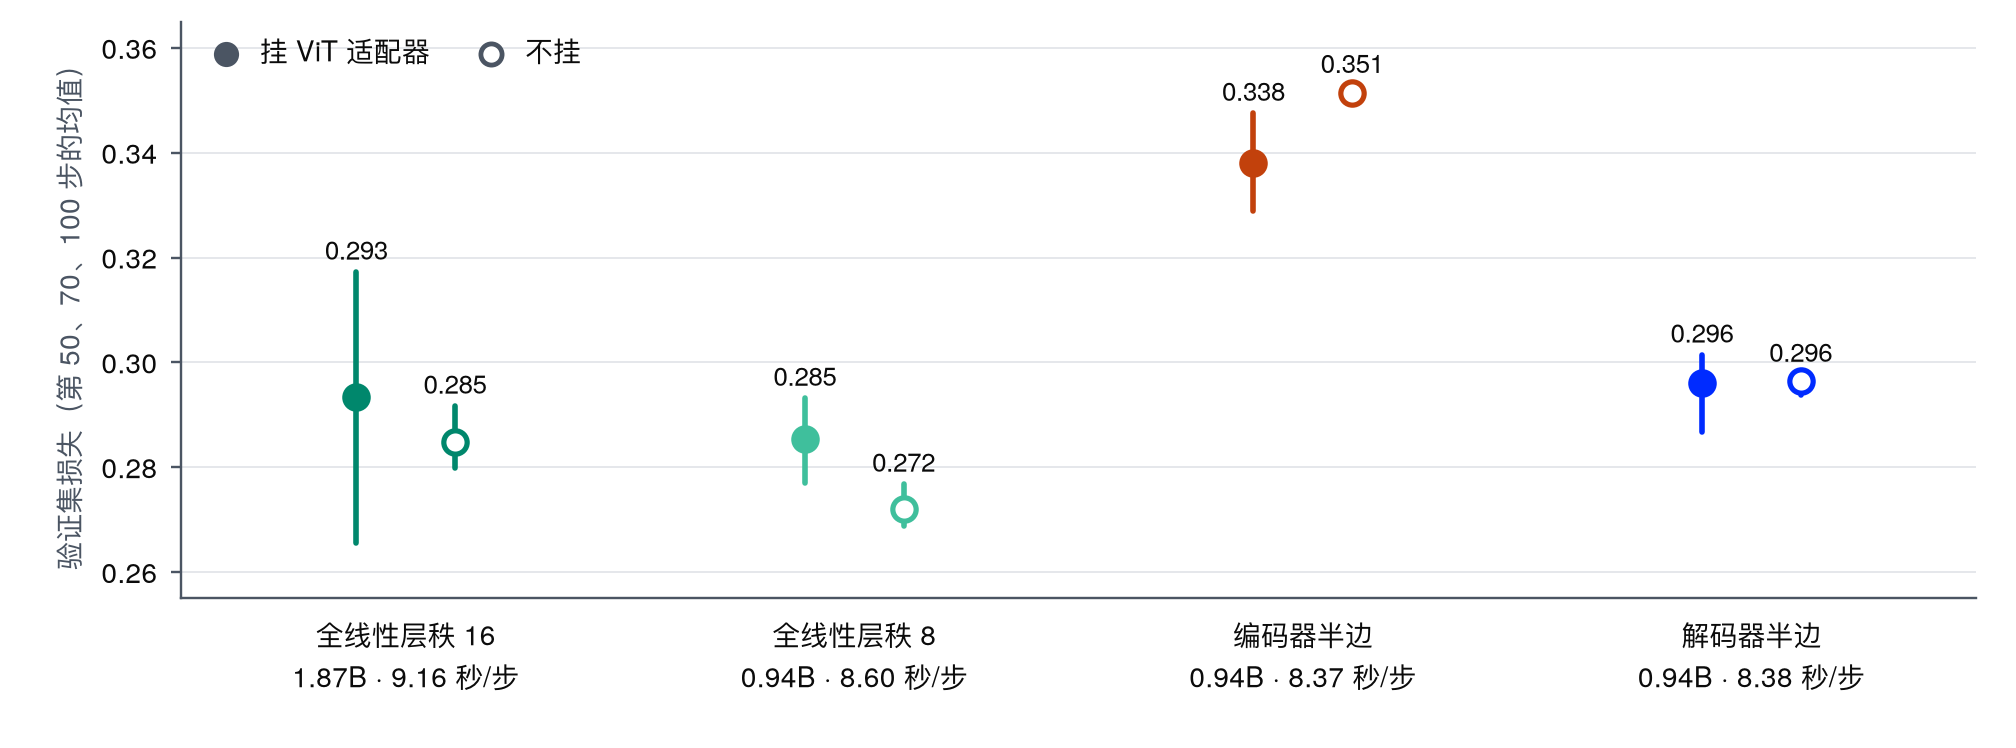
全线性层秩 8 是另一种减半预算的方式,同样做到了这一点。开销相同时,解码器半边在每个种子上都优于编码器半边(图 5):挂 ViT 适配器时低 0.036 到 0.048,不挂时低 0.052 到 0.058。适配器放在哪一半,比它有多大更重要。
| 配置 | 挂 ViT 适配器 | 不挂 ViT 适配器 |
|---|---|---|
| 全线性层秩 16 | 0.293(0.266–0.317) | 0.285(0.280–0.292) |
| 编码器半边(秩 16) | 0.338(0.329–0.348) | 0.351(0.350–0.353) |
| 解码器半边(秩 16) | 0.296(0.287–0.302) | 0.296(0.294–0.298) |
| 全线性层秩 8 | 0.285(0.277–0.293) | 0.272(0.269–0.277) |
表 2. 第 50、70 和 100 步三次评测的平均验证集损失:三个种子的均值,括号内为种子间的范围。
除了 100 步的验证集平台期,我们还从三个方面做了检验:
- 留出测试集。 在 601 道完全没参与调参的测试题上,每个配置重新训练一个种子,解码器半边的损失比全线性层秩 16 更低:不挂 ViT 适配器时为 0.190 对 0.201,挂上时为 0.193 对 0.210。秩 8 为 0.183 和 0.191,编码器半边为 0.312 和 0.287。
- 训得更久。 不挂 ViT 适配器、用一个种子训到 300 步,每个配置都在第 90 到 180 步之间达到最低点;此后秩 8 和解码器半边的过拟合比完整适配器轻。在各自的最低点,秩 8 为 0.246、全线性层秩 16 为 0.249、解码器半边为 0.253,相差在 0.007 以内,编码器半边为 0.330。这次训练自身的 100 步平台期比这些最低点高 0.02 到 0.05,排序相同。
- 另一个任务。 A2UI 是我们 Macaron 智能体的一个纯文本任务,回复由自然语言和用来渲染界面组件的 JSON 组成,每步的 token 数约为 Geometry3K 的二十倍。在这个任务上,我们用一个种子、不挂 ViT 适配器训练,全线性层秩 16 的平台期验证集损失为 0.189,秩 8 为 0.193,解码器半边为 0.192。
为什么是解码器
有两点和实测吻合。
第一,因果编码器–解码器的记忆集中在编码器:四个写压缩 KV 的层有三个在编码器里,第四个是第 20 层,它用编码器的输出生成解码器读的 KV。编码器上的适配器会扰动整个模型共享的这份记忆,而解码器上的适配器主要改变的是怎么读取它。
第二,剪枝研究发现,预训练语言模型中深层比浅层更冗余 ,这让深层有余地承接新任务,浅层存储的内容也得以保留。此外,解码器各层离损失最近,梯度经过的雅可比链最短。
这个排序不受编码器学习率的影响。以梯度范数的平方和衡量,编码器半边拿到的梯度能量更大;把编码器的学习率减半或按层衰减后,排序依然不变。
要让解码器半边的多个适配器共用一份缓存,还需要冻结第 20 层的 K/V 投影和压缩器投影;这样做没有代价:三个种子的平台期损失分别只变化了 −0.001、−0.008 和 −0.002。
ViT 可以保持冻结
去掉 ViT 和对齐器的适配器后,两个全线性层适配器的验证集损失都降低了,解码器半边不变,只有编码器半边变高(表 2)。训练也更便宜:每步快 3% 到 9%,每个配置的峰值显存都少了 5.2 GB,从 87.2–87.8 GB 降到 82.0–82.6 GB。
省下的开销来自反向传播:ViT 和对齐器里没有可训练参数后,梯度传到语言模型就停下,不必再保存 ViT 的激活,每一步也省掉了 ViT 的反向和重计算(图 6)。至于 ViT 和对齐器上那 9M 个适配器参数,本身微不足道。
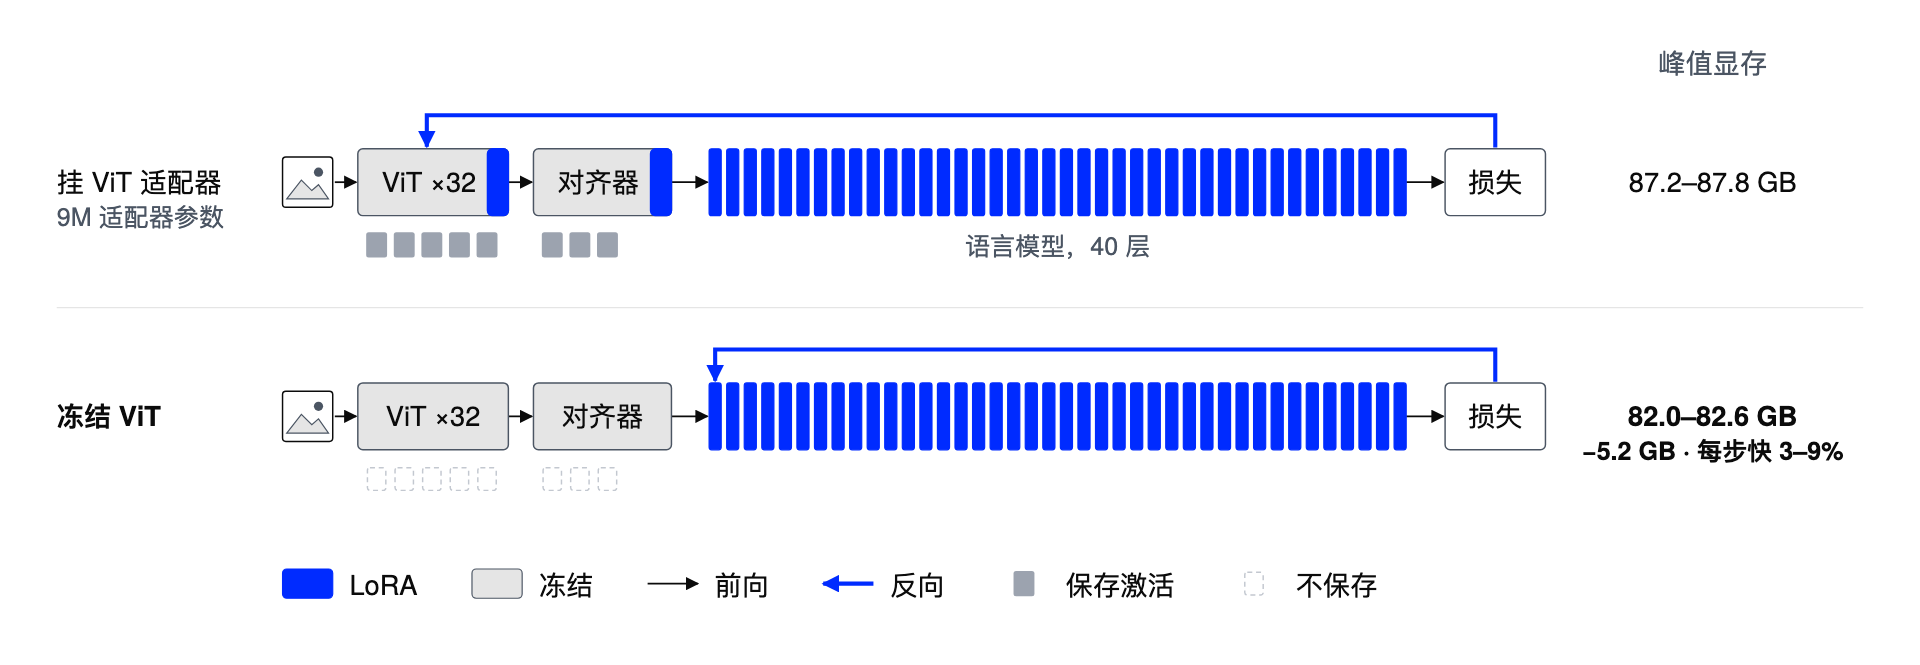
ViT 也冻结后,解码器半边需要的计算比表 1 显示的还少:第 20 层之前没有可训练参数,反向传播可以在这里停下。不论是否开启重计算,编码器的激活都可以丢掉,反向只需经过解码器的 20 层,计算量随之减半。
流水线并行时,后面阶段收到的输入总是需要梯度;Megatron-LM #8664 让这种情况下反向传播也能提前停下。
冻结 ViT 还让结果更稳定:不挂 ViT 适配器时平台期损失在种子间相差 0.003 到 0.012,挂上时为 0.015 到 0.052。
给 ViT 适配器十分之一的学习率可以补上大部分差距:在全线性层秩 16 上,第 100 步的验证集损失均值为 0.273、范围 0.022;共享学习率下为 0.289 和 0.054,冻结 ViT 时为 0.274 和 0.014(图 7)。这与共享学习率对它们偏大相符,原因见下一节;而冻结能以更低的开销达到同样的损失。
即使冻结了 ViT,模型照样读取图像。训满 100 步后,给每道验证题换上另一道题的图,全线性层秩 16 无论挂不挂 ViT 适配器,验证集损失都上升 0.66,其他配置上升 0.51 到 0.63;而基座模型几乎不受影响,只变化了 −0.06。以上每个配置都只用一个种子。语言侧的适配器学会了读取冻结的图像特征。
哪些模块需要 LoRA
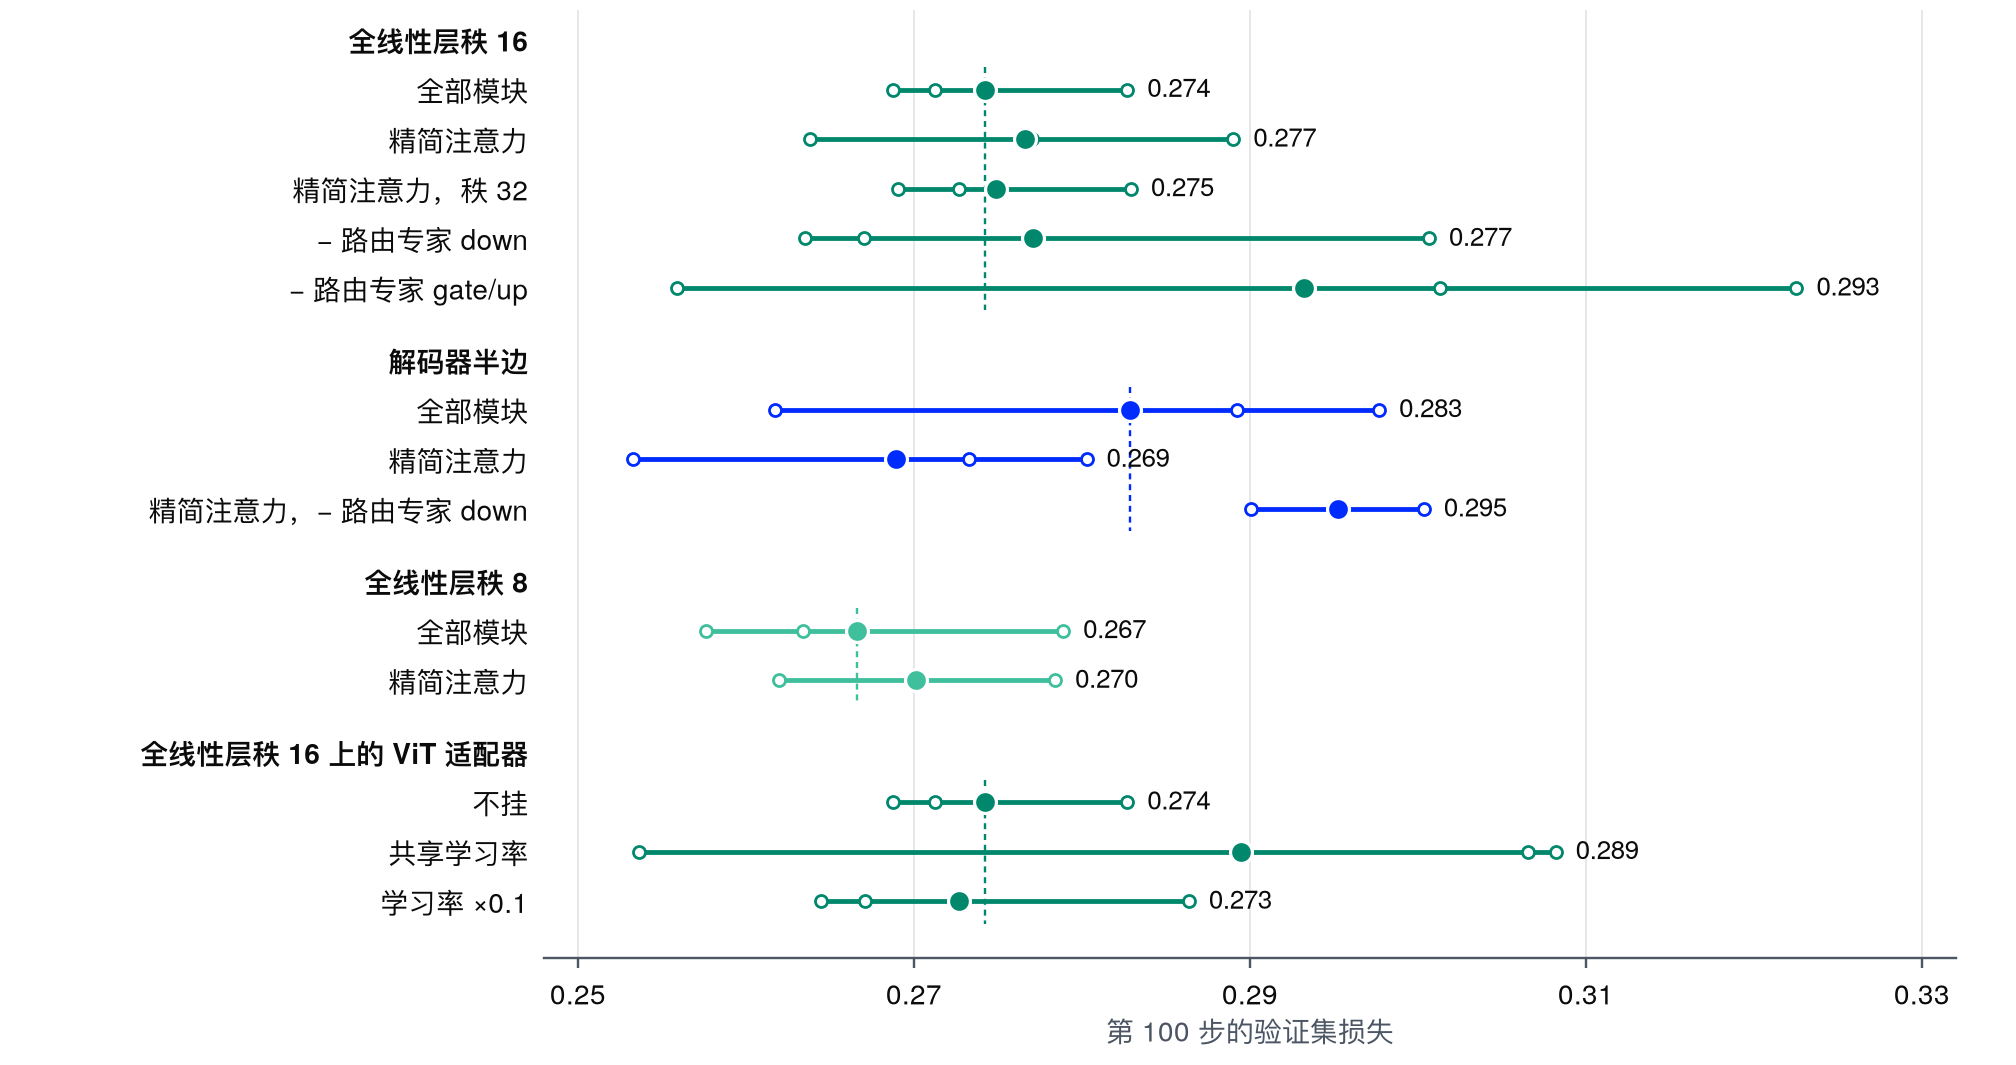
我们研究了几种只挂部分线性模块的 LoRA 组合,都不挂 ViT 适配器;正文引用的是平台期均值,图 7 画的是第 100 步的值。
索引器不需要适配器:top-k 选择不会给它传梯度,挂在那里的适配器始终为零。
第一种组合去掉三个注意力侧模块:查询上投影 wq_b、分组输出投影 wo_a 和压缩器。查询和输出投影都分两步计算:先 wq_a 再 wq_b,先分组的 wo_a 再 wo_b。在每对中的一步上挂适配器,就能影响整个投影;压缩器只存在于四个 kv_source 层中。
此外,wo_a 和压缩器这两个投影直接调用 GEMM,需要在 vLLM 里新写适配器代码。这种精简注意力组合无论用秩 16,还是秩 32、\alpha = 32,都与全线性层秩 16 持平:平台期损失为 0.277 和 0.279,对照为 0.285。
这三个模块占 1.6% 的参数,结果说明压缩器不需要适配器。在解码器半边上,精简组合略好,0.290 对 0.296;在预算最小的全线性层秩 8 上,全模块组合领先,0.272 对 0.281。
路由专家占适配器的 96%,它的两个投影表现截然不同。去掉 down 投影(占 33% 的参数、8 步训练中 58% 的梯度能量)后,适配器少了三分之一(按保存的适配器文件计,从 1.77B 降到 1.20B 个参数;表 1 按 fp32 主权重计),却没有代价(0.280 对 0.285);省下的是优化器状态,显存和每步时间基本不变。
解码器半边在精简注意力组合的基础上再去掉 down 投影,损失为 0.302,在种子波动范围内与全模块的 0.296 持平,只比单用精简组合的 0.290 略高。gate/up 投影占 63% 的参数、5% 的梯度能量,它才是该保留的:挂上它时第 100 步的损失为 0.274、种子间范围 0.014,去掉后为 0.293 和 0.067。
注意力和共享专家的适配器,参数只占约 3%,学到的内容却占了很大一部分。在同样的层上,挂全模块的适配器比只挂路由专家的适配器平台期损失低:同时挂 gate/up 和 down 时低 0.05,只挂 gate/up 时低 0.07,只挂 down 时低 0.18。
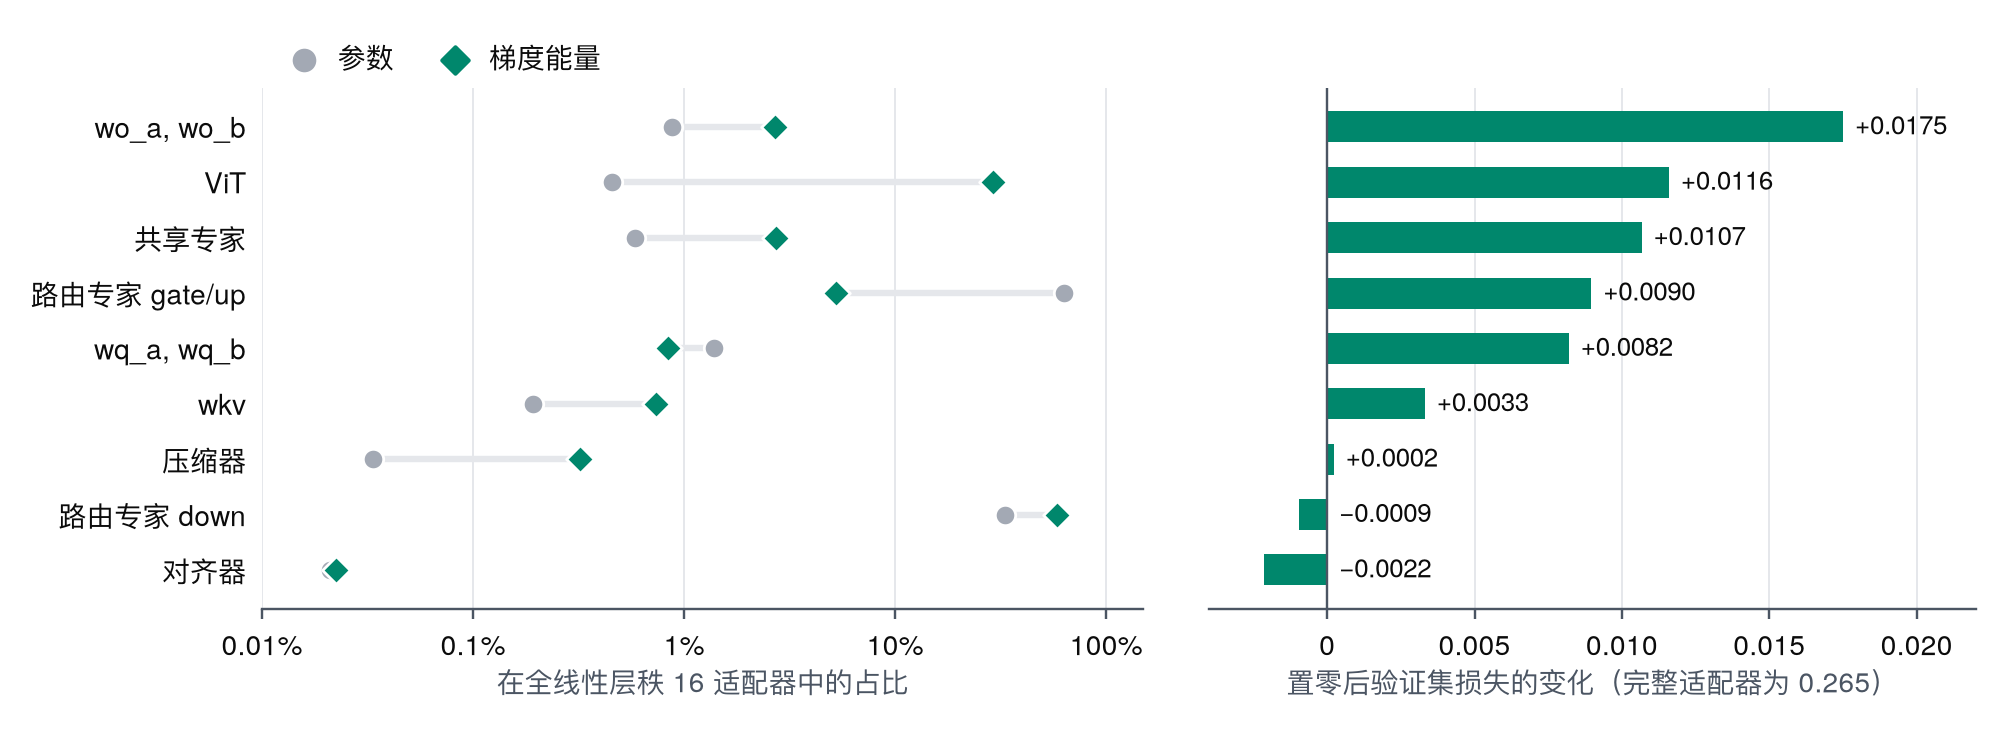
逐个模块组置零,可以直接看出训练好的适配器依赖哪些模块(图 8)。我们另外训练了一个全线性层秩 16 适配器(挂 ViT 适配器,100 步,种子 0,验证集损失 0.265),每次把其中一个模块组的 LoRA 置零后重新跑验证:注意力输出投影只占 0.9% 的参数,影响最大,为 +0.018;路由专家的 down 投影占了 58% 的梯度能量,置零后损失几乎不变,为 −0.001。
梯度占比和重要性在这里是两回事,因为 Adam 会对每个参数的更新做归一化。单独置零任何一组,损失的变化都在 0.018 以内,而全部置零则回到基座模型的 6.14:适配器学到的东西分散在各个模块中,某个模块不训时,其他模块能补上;精简注意力组合不训分组输出投影,就是一个例子。
不过,梯度能量除以模块的参数占比,衡量的是一个经过 Adam 归一化后依然保留的量:
其中 G_c/G 和 n_c/n 分别是模块 c 在梯度能量和参数中的占比,因此 \rho_c 即模块 c 中每个参数的平均梯度平方相对整个适配器的倍数。
如果某个模块的输出对其权重的敏感度是平均的 \kappa 倍,它的梯度就大 \kappa 倍、曲率大 \kappa^2 倍,最优步长随之缩小到平均值的 1/\kappa,而 Adam 的步长仍在学习率附近。
于是对这个模块来说,共享学习率是合适值的 \kappa \approx \sqrt{\rho_c} 倍;LoRA+ 给 LoRA 的两个矩阵设不同学习率、muP 按层缩放学习率,都是同样的道理。
ViT 格外突出,\rho_c 约为 63,相当于有效步长是平均的 8 倍左右;把它的学习率降到十分之一后,效果正如预期。
语言模型中各模块的比值都在 7 左右或以下,只有压缩器的 KV 投影为 17,而它本来就不需要适配器。这个比值可以用来找出需要更小学习率的模块。
对语言模型来说,5e-5 在这个任务上已经接近可用范围的上限,所以各个模块共用一个学习率就够了。共享学习率的损失为 0.285;LoRA+ 把上投影 B 的学习率设为下投影 A 的 4 倍和 16 倍时,损失分别升到 0.301 和 0.344;把 A 的学习率降到 1.25e-5 时,与共享学习率持平。
让 DeepSeek-V4.1-Flash 可以训练
下面这些工作大多适用于对 DeepSeek-V4.1-Flash 的任何微调,与是否用 LoRA 无关。这个模型打破了训练栈里几条默认成立的假设:重计算只涉及单层、填充无害、所有参数都该放在 GPU 上、发布的检查点可以直接加载。
LoRA 特有的部分,是让推理引擎在训练器挂了适配器的每个地方都应用它。相关改动分布在六个上游 PR 中(图 9)。
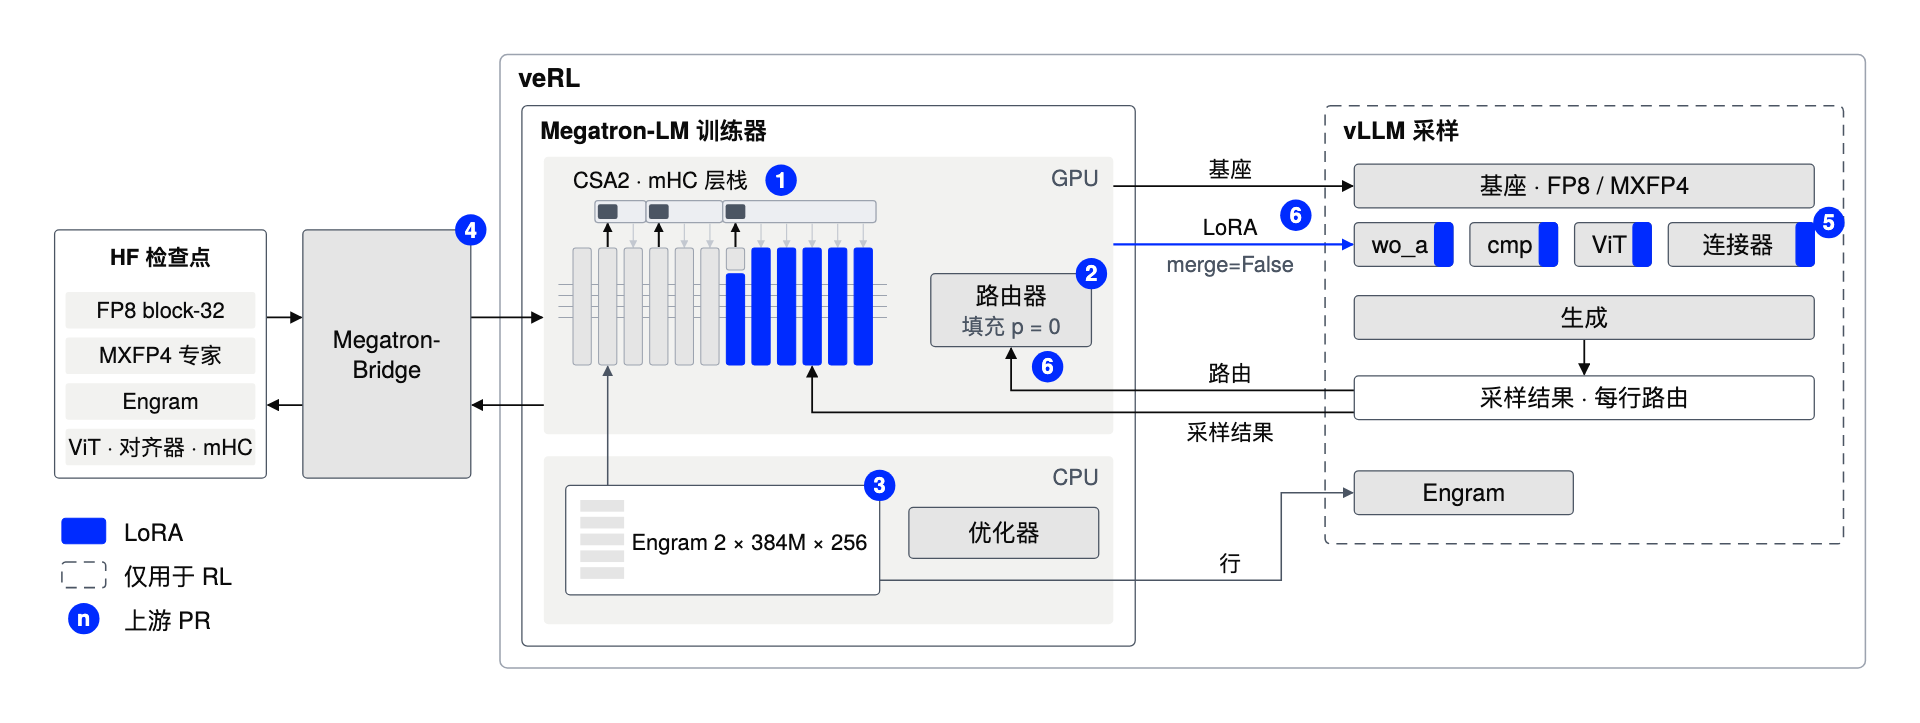
CSA2 的状态跨层传递,重计算也得带上它
CSA2 层会读取一份后续各层依赖的压缩全局 KV,kv_source 层还会写入它:
其中 h_l 是进入第 l 层的隐藏状态,s_l 是该层读取的 CSA2 状态,包括共享 KV、索引和候选块,T_l 是该层对状态的更新,F_l 是该层的其余计算。
逐层的激活检查点假设重跑第 l 层只需要它的输入 h_l。在 CSA2 下还需要 s_l,所以检查点一旦丢掉状态,重计算就会出错。Megatron-LM #8018 在 Megatron 的混合层栈里加入了一个带状态的 CSA2 封装层,让共享 KV、索引、候选块和 mHC 状态在全量重计算中一起传递。
同一个 PR 让 CSA2 支持打包序列和上下文并行。压缩分组、有效性掩码和旋转位置都由逻辑序列布局决定,因此填充始终不参与压缩和稀疏选择。上下文并行时,每个 rank 在分区交界处交换一段边界区、只压缩自己负责的区间,每个全局 KV 块都只有一个归属 rank(图 10)。
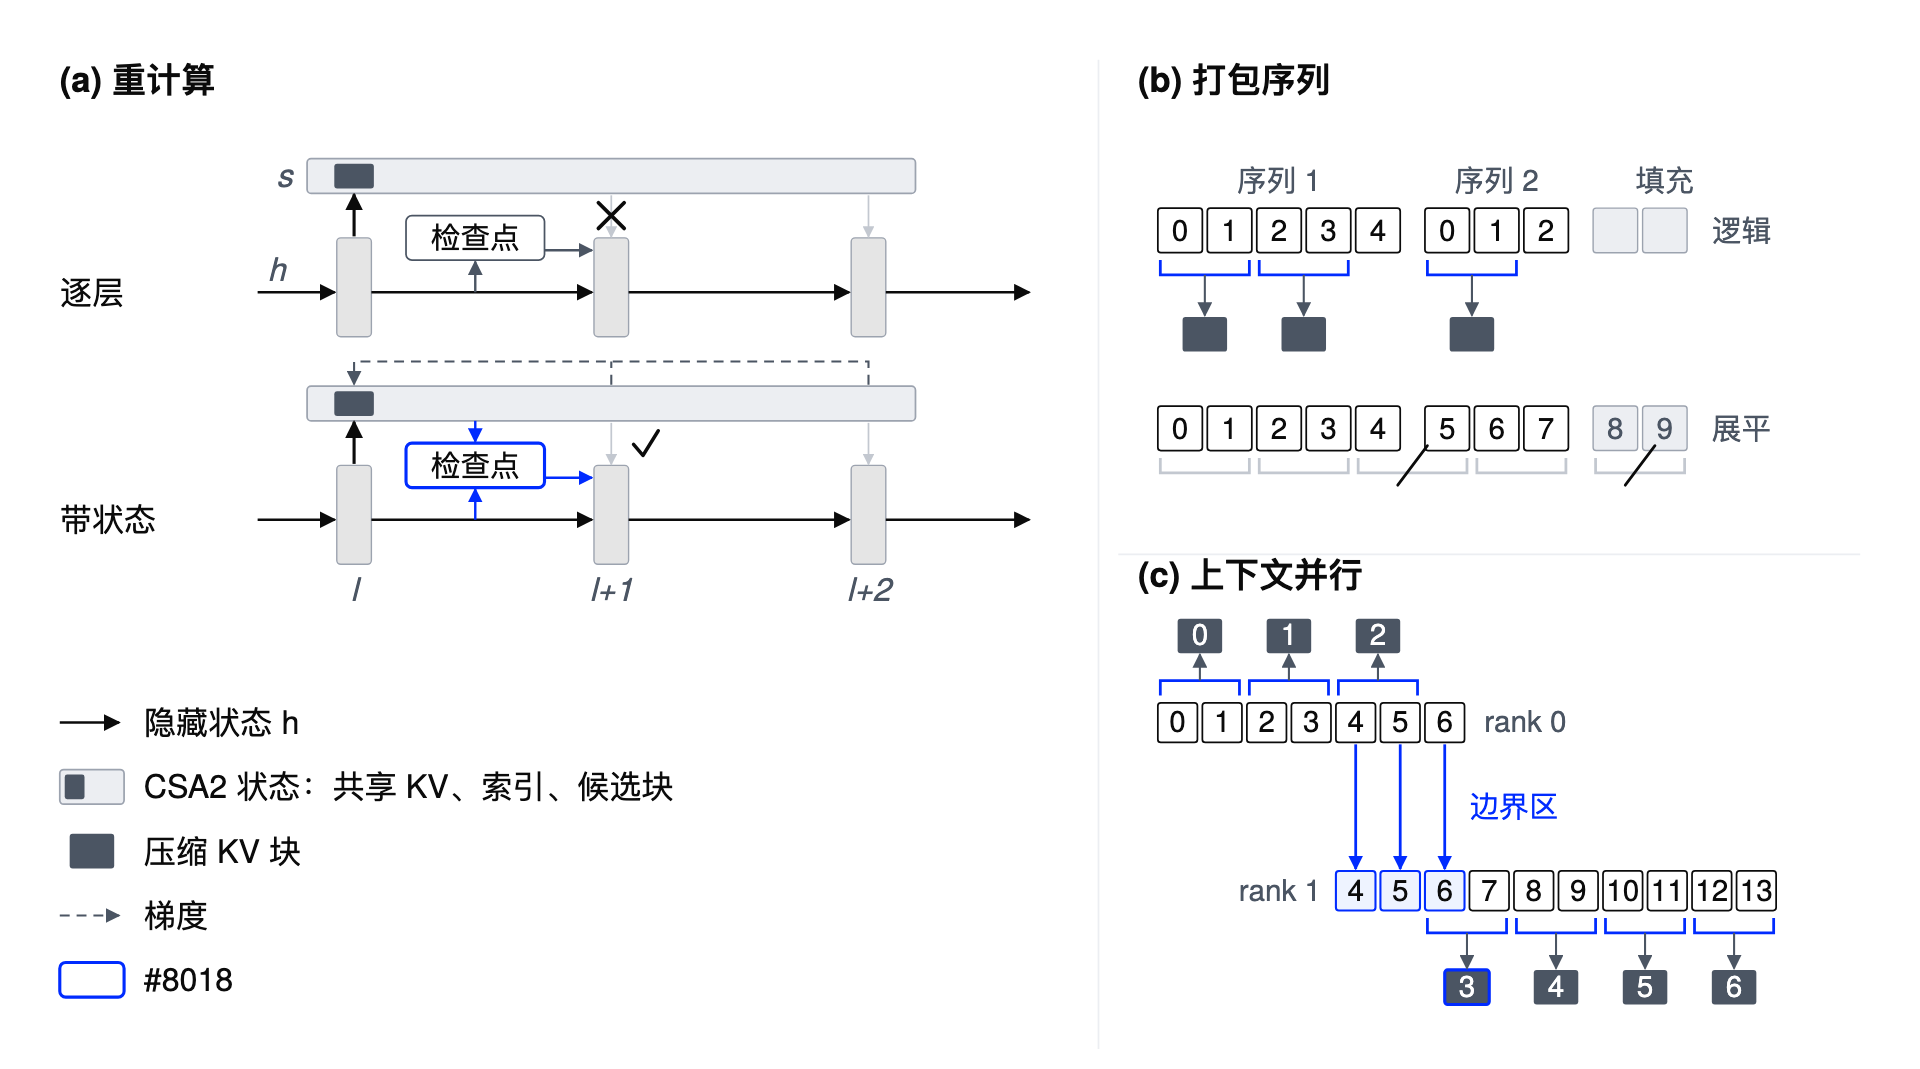
图 10. CSA2 状态必须和隐藏状态一起传递,对应 Megatron-LM #8018:(a) 重计算时;(b) 打包序列中,压缩分组按各条序列划分;(c) 上下文并行时,rank 1 收到一段边界区。图中尺寸为示意。
模态路由要丢掉填充,同时保持形状固定
V4.1-Flash 的文本和图像 token 共用一个路由器,但专家偏置不同:
微调时我们冻结两组偏置,让采样和训练使用相同的偏置项。问题在于填充行:它们既不该贡献路由概率,也不该计入负载均衡统计,但分发器要求每一行都被路由。Megatron-LM #7763 为填充 token 保留分发器中的行,同时把它们的路由概率置零,也不计入负载均衡计数,从而保持张量形状不变。
Engram 留在 CPU 上
两张 Engram 表分别在第 1 和 14 层读取,各约 3.84 亿行、每行 256 维。它们在 LoRA 训练中是冻结的,只通过稀疏查表访问,所以我们把它们放在 CPU 的锁页内存里,每个微批次只取需要的行。
与放在 GPU 上相比,每张卡的峰值显存省下 22.9 GB,从 106.8 GB 降到 83.9 GB,每步时间不变;这是在短学习率扫描中的半深度适配器上测得的。
真正要做的,是让它们一直留在 CPU 上:DDP 参数同步这类通用训练代码默认每个参数都在 GPU 上。Megatron-LM #7762 加入了锁页内存上的按行查表路径,并让 DDP 参数同步跳过这些常驻 CPU 的参数,查表用的路由元数据仍留在 GPU 上。
发布的检查点要能来回转换
Megatron-Bridge #6199 把发布的 Hugging Face 检查点映射到原生的 Megatron-Core 模型上,包括超连接、ViT、对齐器和 Engram 表。
导入时它解码按 32 分块量化的 FP8 权重和打包的 MXFP4 专家,导出时恢复这两种布局。Engram 表的导入和导出都按行分块流式进行:从 SafeTensors 直接送到各自的 rank,再从这些 rank 送给 vLLM,全程不拼出整张表。
该 PR 还让 LoRA 可以挂在分组输出投影上:这个投影在模型里是一个裸参数,有了这一改动,挂在上面的适配器能和其他适配器一样训练和导出。
采样必须用上训练器正在更新的适配器
RL 中,训练器以 merge=False 的方式分别把基座权重和适配器推送给 vLLM,所以 vLLM 必须在训练器挂了适配器的每个地方都应用它。
为此需要补上三处:多模态封装要注册 LoRA;分组注意力输出投影和压缩器直接调用各自的 GEMM,要为它们加上适配器路径。vLLM #57245 为分组输出投影和压缩器加上 LoRA,前者支持 BF16 和 FP8 的基座权重;它还注册了 ViT 及其连接器,即对齐器,并让适配器状态按每张图像隔离。
veRL #7483 则让这种不合并的同步本身正确无误:它会探测目标模型的加载器如何命名被封装的基座权重,还会拆掉 LoRA 套在 MXFP4 MoE 方法外面的量化封装,让加载后的重新打包照常执行。
路由回放要跳过图像行
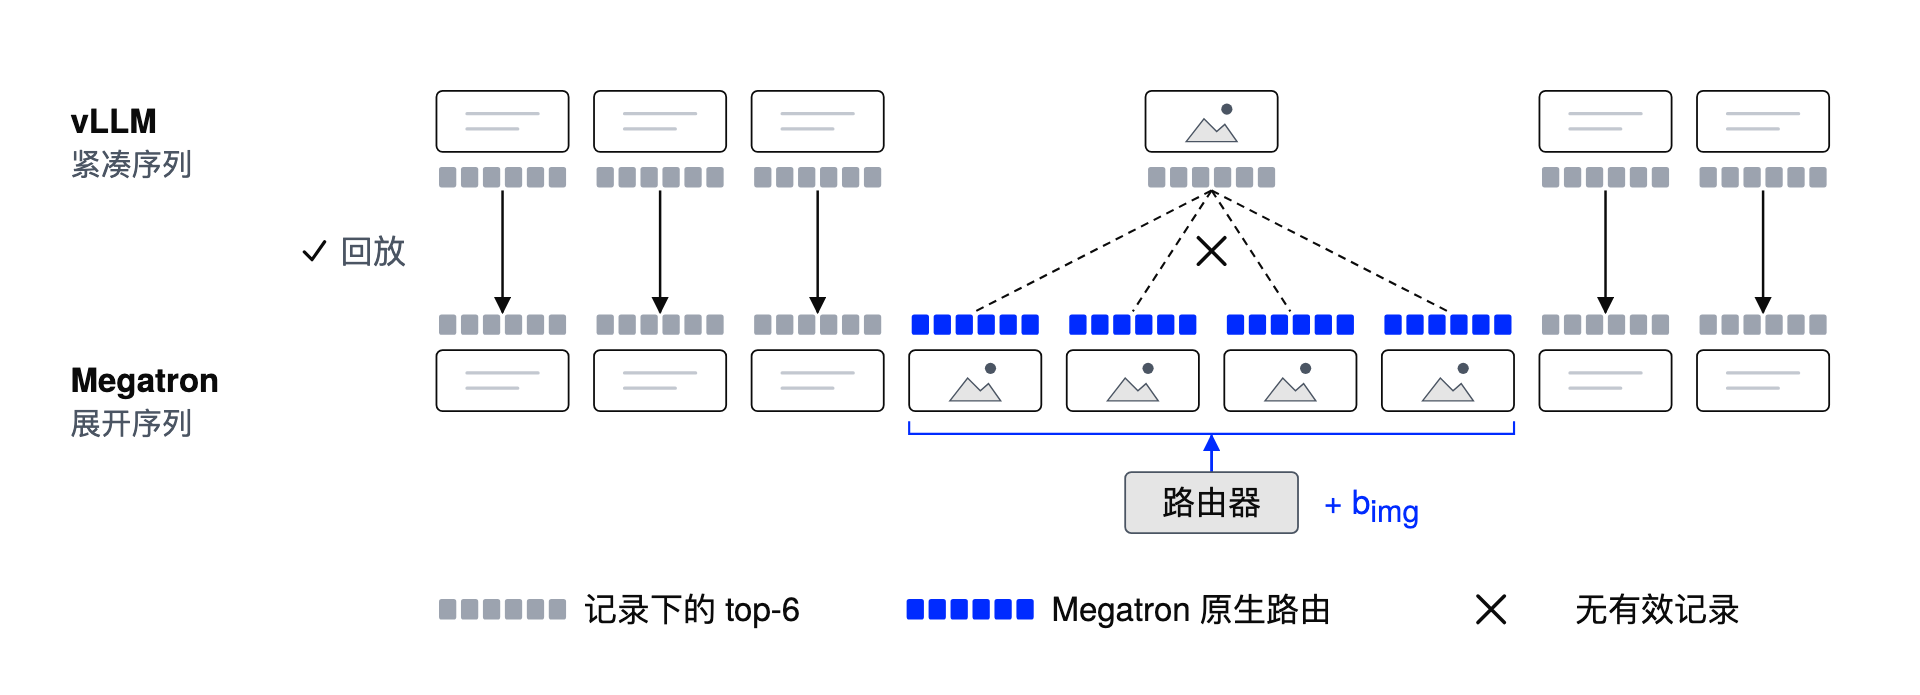
RL 中,vLLM 用自己的路由器完成采样,Megatron 再用另一个路由器重算一遍。采样路由回放在 Megatron 的前向中回放 vLLM 的专家选择;它的通用修复我们在之前的文章中介绍过。
V4.1-Flash 在多模态上多了一个问题:vLLM 在紧凑序列上记录路由,一张图像只占一个占位符,而 Megatron 运行在展开图像后的序列上,路由器还会加上图像专属的偏置。
因此,在占位符处记录的路由对展开后的图像 token 无效;我们只回放文本行,图像行则走原生路由,见图 11 和 veRL #7483。
结论
实验给出了答案:只训解码器就够了。在解码器的第 20–39 层上挂秩为 16 的 LoRA,验证集损失为 0.296,与挂满 40 层的 0.293 只差 0.003,适配器参数只有一半;
与同样大小、挂在编码器上的 LoRA 相比,每个种子上的验证集损失都低 0.036 到 0.058;再冻结第 20 层的 KV 写入投影也没有代价。
无论是留出的测试题、训到 300 步,还是另一个纯文本任务,这个结论都成立。
这样做,适配器便宜到可以大规模使用。 实践中:
- 只适配解码器。 冻结第 20 层的 KV 写入投影,让所有适配器共用一份压缩 KV 缓存。全线性层秩 8 是另一种同样站得住的半预算方案。
- 冻结 ViT 和对齐器。 去掉它们的适配器后,四个配置中有三个的验证集损失持平或更低,每步快 3% 到 9%,峰值显存省 5.2 GB,模型照样读图。如果要训,就给它们十分之一的学习率。
- 用消融结果决定裁剪。 在完整的全线性层秩 16 设置下,压缩器、查询上投影、分组输出投影和路由专家的 down 投影,合计三分之一的参数,都可以去掉。保留路由专家的 gate/up 投影,以及注意力和共享专家上参数很少的适配器。
- 按主机内存做预算。 在优化器卸载下,适配器的大小体现在主机内存和优化器那一步的时间上,峰值显存几乎不变。把 Engram 表也留在 CPU 上。
这几点合在一起,让适配器便宜到足以服务于经验智能:新的经验可以化为许多小的解码器侧适配器,共用同一个基座和同一份缓存,每一个的成本都远低于重新训练。
Mint Recursive 现已支持 DeepSeek-V4.1-Flash
Mint Recursive 是 Mind Lab 的无服务器自动化模型训练平台,现已支持 DeepSeek-V4.1-Flash。我们基于它为金融客户提供这个模型的后训练服务:在一家客户的专有业务基准上,经过后训练的模型比 DeepSeek-V4.1-Flash 官方 API 高 5.96%。
Mind Lab 持续招聘 Infra Research 的人才(全职、实习生)。如果你对后训练的 RL infra 感兴趣,欢迎投递简历到 hr@mindlab.ltd。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册