
上下文越长,KV Cache 越大,这是推理服务里最熟的一笔账。
线性注意力换了个算法:把 KV Cache 换成固定大小的循环状态(Recurrent State),序列再长,状态也不涨。Qwen3.8-27B、Kimi-Linear-48B-A3B-Instruct 这类混合模型,就是用 gated Delta-rule 的循环记忆加上标准注意力,来平衡效率和效果。
来自浙江大学、清华大学、中科院自动化所、香港城市大学等机构的团队提出 STEPQuant:把循环状态压到低比特,6-bit 下接近 FP32 的精度,状态显存压缩超过 5 倍,整机服务显存最多降 68.7%,代码已经开源。
但显存这笔账,没有就此结束。
从 KV Cache 到 Recurrent State:线性注意力带来了什么变化?
标准注意力的问题在于,KV Cache 随序列长度线性增长,上下文越长越吃显存。
线性注意力把过去的信息压进一个固定大小的循环状态,长度不再是变量。换成服务视角看,这个状态是每个请求各自持有一份的,而且要常驻:并发一多,状态池就跟着涨,连短上下文也躲不掉。
SGLang 的官方部署里,Qwen 的 FP32 状态池在 70 个并发请求时就超过了 BF16 权重的显存占用。
也就是说,循环状态从“省显存”的方案,变成了新的显存瓶颈。要压的正是它。
高并发场景下的显存困境,以及低比特量化的难点
最直接的想法是量化。但循环状态不能当普通权重来压。
每一次 Delta 更新,都是在一个近似的状态上算,算完再重新量化。误差不会停在原地,它会跟着解码一步一步往下传。把状态直接量化,问题就暴露了:4-bit 和 6-bit 下,两个模型的平均准确率都掉得厉害,到 8-bit 仍有明显差距。
误差为什么这么难缠,要看两个维度。
时间上,状态被反复更新、反复量化,寿命长的单元会把误差一直带下去;门控保留得越久,误差积得越多。按寿命排序,Qwen 有 52.5% 的累计平方误差集中在最长的 25% 单元里,KDA 是 78.8%。

图:左边是两种模型的状态误差在长寿单元上的集中程度,右边是同一比特下不同 key row 的影响差异。来源:arXiv:2609.38169
空间上,误差落在哪一行,后果也不一样。同样大小的误差,不同 key row 对输出的影响可以差到 117 倍(Qwen)和 35 倍(KDA);而且状态本身在行和列两个方向上的幅值差别很大,离群值还会在解码过程中一直存在。
单轴缩放,装不下这两种分布。

图:key row 对困惑度的影响、状态在行列两个方向上的离群值,以及这些离群通道在解码中的持续性。来源:arXiv:2609.38169
STEPQuant 核心设计:误差生命周期与 Key-Row 双轴量化
STEPQuant 把这两个维度分别做成了设计。
时间维度是寿命感知的比特分配。它同时看两件事:每个单元在不同比特下的量化误差,以及这个单元能活多久(门控半衰期)。在固定的显存预算下,误差大、活得久的单元分到更高精度,其余压得更狠。
空间维度是 Key-Row 双轴量化拟合。它给 key row 和 value column 分别配尺度:行尺度同时考虑这一行的当前幅值和它对输出误差的实测影响,列尺度在拟合时给“影响大”的行更高权重。
这样一套下来,状态的形状可以被两个轴同时接住,而不是用一个全局尺度硬套。

图:Qwen 与 KDA 的状态在行列方向上的分布形态。来源:arXiv:2609.38169
还有一点对部署很关键:寿命排序在换成 C4、LiveCodeBench 这些文本来源之后基本不变(Qwen ρ=0.989/0.985,KDA ρ=0.991/0.982),所以校准出来的精度分配不会因为换了任务就失效。

图:寿命排序在不同文本来源下基本一致。来源:arXiv:2609.38169
6-bit 如何逼近 FP32?量化精度与模型性能的平衡
评测用了两个模型:Qwen3.8-27B(GDN)和 Kimi-Linear-48B-A3B-Instruct(KDA),七个长生成推理任务加六个短生成任务。
长生成上,6-bit STEPQuant 在 Qwen 上的平均准确率是 80.59%,Kimi 是 61.47%;同样 6-bit 的均匀量化,只有 45.04% 和 45.70%。
短生成上,4-bit STEPQuant 距离 FP32 只差 0.15 个点(Qwen)和 0.25 个点(Kimi);均匀 INT4 已经掉得很厉害,有些任务甚至给不出合法答案。
更接近部署的是 W4 权重那组:权重先做 4-bit AWQ,状态再上 6-bit,七任务平均 79.27%(Qwen)和 58.62%(Kimi),比各自的 FP32 状态基线只低 0.05 和 0.33 个点。4-bit 状态下,STEPQuant 也仍然压过均匀 INT8。
从状态压缩到高效服务:方法边界与未来优化方向
把 kernel 接进 SGLang 之后,收益落到服务上。
在 A800 上,batch size 512、W4 权重时,Qwen 的整机显存从 419.73 GiB 降到 131.18 GiB,少了 68.7%;循环状态显存降 80.1%(5.03 倍压缩),状态更新时间快 2.91 倍(降 65.6%)。Kimi 的状态压缩是 5.08 倍,整机显存降 53.7%。
边界也清楚。
寿命权重是用门控衰减来近似误差持续性的,没有完整建模随时间和 key 变化的转移;4-bit 配 BF16 权重时,KDA 在长生成上会掉精度,Qwen 则会出现输出变长;评测只覆盖两个 GDN/KDA 模型,固定硬件与负载,换成别的架构,或者动态变化的真实服务负载,还需要再验证。
对做推理服务的人来说,这些边界比 68.7% 更有参考价值:循环状态量化能不能用,取决于你的模型、权重精度和负载形态。
论文:STEPQuant: When and Where Errors Matter in Delta-Rule Recurrent State Quantization
链接:https://arxiv.org/abs/2609.38169
代码:https://github.com/Dreamer-Toby/STEPQuant
团队:Bingchen Yao、Haobo Xu、Haokun Lin、Yichen Wu、Ziyu Guo、Renrui Zhang、Zhichao Lu、Zhenan Sun、Ying Wei
机构:浙江大学、清华大学、中科院自动化所(NLPR & MAIS)、香港城市大学、哈佛大学、香港中文大学
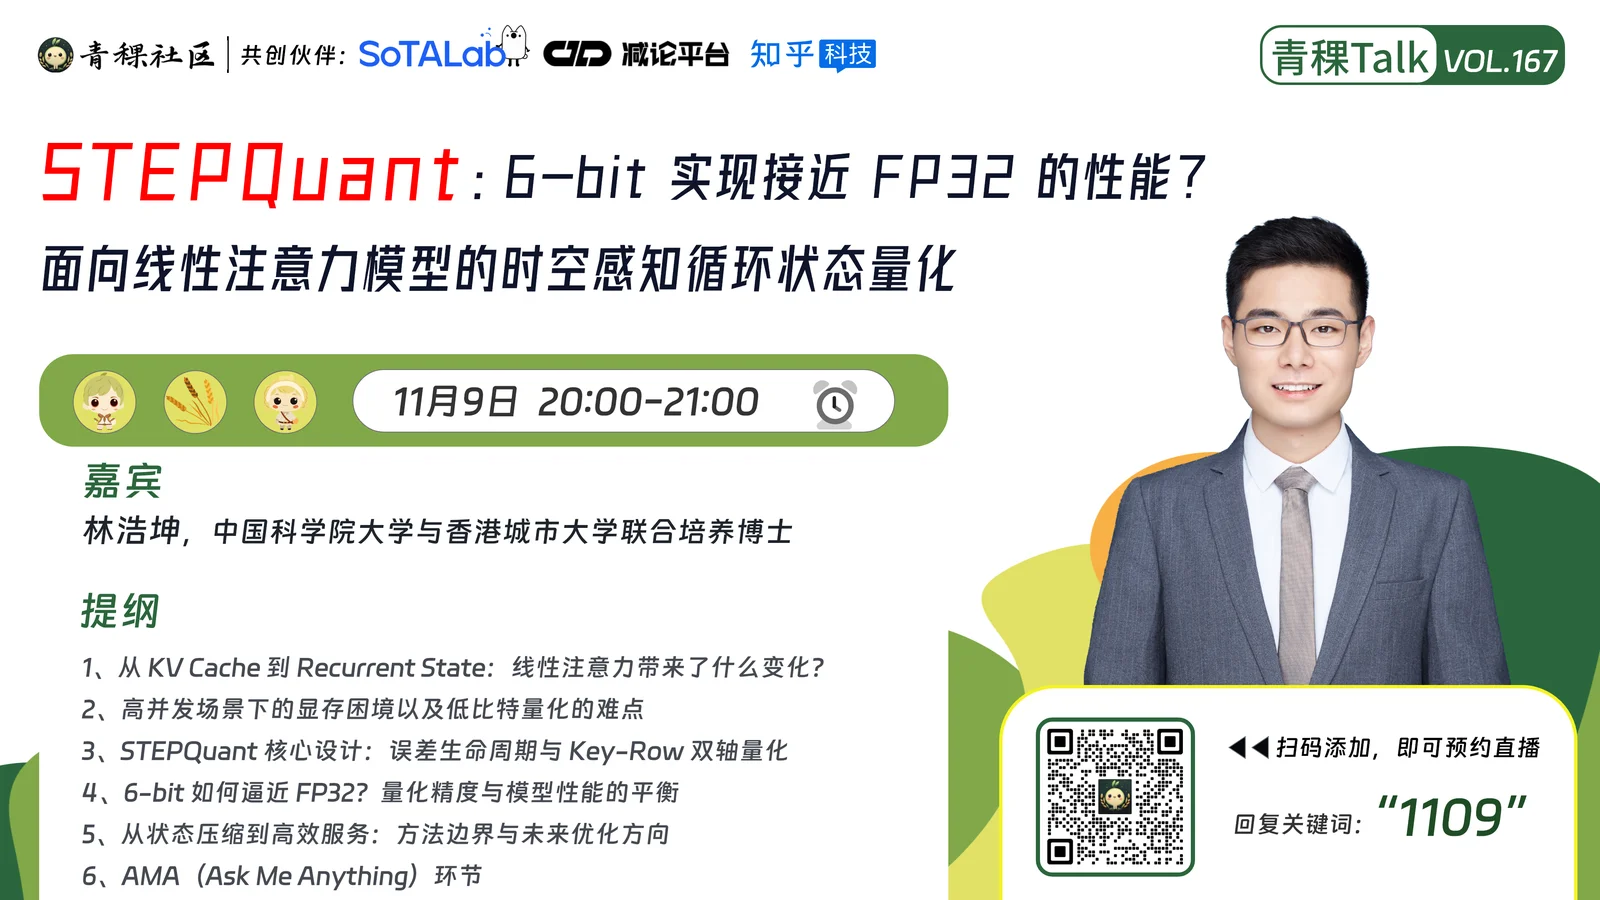
11月9日(周一)晚8点,青稞Talk 第167期,青稞社区邀请到 STEPQuant 项目负责人、中国科学院大学与香港城市大学联合培养博士林浩坤,分享《STEPQuant:面向线性注意力模型的时空感知循环状态量化》。
分享内容
STEPQuant:线性注意力的低比特量化
面向线性注意力模型的时空感知循环状态量化
1、从 KV Cache 到 Recurrent State:线性注意力带来了什么变化?
2、高并发场景下的显存困境以及低比特量化的难点
3、STEPQuant 核心设计:误差生命周期与 Key-Row 双轴量化
4、6-bit 如何逼近 FP32?量化精度与模型性能的平衡
5、从状态压缩到高效服务:方法边界与未来优化方向
6、AMA(Ask Me Anything)环节
嘉宾介绍
林浩坤,中国科学院大学与香港城市大学联合培养博士,研究方向为大模型高效计算,主要聚焦模型压缩、低比特量化与高效推理。相关研究成果发表于 NeurIPS、CVPR、ICLR 等国际人工智能顶级会议。其中,一作论文 DuQuant 入选 NeurIPS 2024 Oral,并曾获 NeurIPS 2024 Top Reviewer、中国科学院院长奖、国家奖学金等荣誉。
直播时间
11月9日(周一)20:00 - 21:00
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册