清华大学车辆学院与人工智能学院团队提出最新研究成果《Self-Adjoint Flow Policy Optimization》,构建了面向在线强化学习的自伴随生成式策略 SAFLOW。论文已被 NeurIPS 2026 接收。OpenReview 评审评分为 5 / 5 / 5 / 4(6 分制)。
论文链接:https://openreview.net/forum?id=V4bnZAJAx7#discussion
第一作者:占国建,清华大学 2021 级直博生
生成式策略正在成为具身智能的重要动作接口。它能够表达复杂、多峰的动作分布,却给在线强化学习带来一个容易被忽视的问题:策略不仅要生成动作,还必须准确回答——这个动作在当前策略下有多大概率?
针对这一问题,SAFLOW 受保辛积分保结构思想启发,重新设计了流匹配策略的离散路径。研究团队以 Verlet 对称分裂构造自伴随策略流,使动作采样与似然评估在数值上保持一致,并将这种二阶一致性进一步传递至策略比率和优化目标。在 8 项 Isaac Lab 连续控制任务上,SAFLOW 均取得最高平均回报,并展现出更快、更稳定的学习过程。
一、生成式策略的“似然盲区”:动作能生成,概率怎么算?
在人形机器人行走、机械臂抓取和灵巧手操作等具身任务中,同一状态往往对应多种合理的控制方式。PPO、TRPO 等经典算法在连续控制中通常采用高斯策略,动作概率密度容易计算,便于开展策略优化;但高斯分布通常只能刻画单一模式,难以充分表达复杂任务中的多种可行动作。
相比之下,扩散模型和流匹配模型能够描述更加复杂、多峰的动作分布,为具身智能提供更丰富的策略表达能力。
围绕这一方向,Google DeepMind、斯坦福大学、加州大学伯克利分校、麻省理工学院、哥伦比亚大学以及丰田研究院等机构持续开展研究,推动生成式模型在机器人动作生成、灵巧操作和复杂轨迹建模中的应用。
以流匹配策略为例,模型学习的不是一个“一次前向计算即可输出动作”的映射,而是一个随时间变化的速度场。生成时,策略从 (t=0) 的简单噪声出发,通过求解常微分方程沿速度场连续演化,直到 (t=1) 得到动作。
实际计算无法直接求得这条连续轨迹,通常需要将 ([0,1]) 时域切分为 (K) 个离散步;一种常用的基础方案是显式欧拉法,即根据当前位置的速度向前推进一步。
问题在于,以 PPO 为代表的在线策略优化方法依赖新旧策略的动作概率比。对于上述流策略,相应的似然评估涉及基础噪声的逆向恢复,以及流变换雅可比行列式的计算。
现有工作常用的显式欧拉法采用一阶、非时间对称的离散更新,直接反转步长通常无法严格撤销正向更新。由这种前后向不一致产生的数值偏差,会继续传递至对数似然、策略比率和优化目标。
生成式策略走向在线强化学习,因而需要同时满足三项要求:
- (1)能够表达复杂的动作分布
- (2)能够准确计算动作似然
- (3)能够支撑稳定的在线优化。
如何让动作采样与似然评估沿同一条数值路径往返,正是 SAFLOW 的研究切入点。
二、从保辛思想到自伴随策略流:同一套规则贯通生成、求逆与优化
2.1 从保辛开始:将生成式动力系统的结构保留在离散计算中
SAFLOW 的灵感来自几何数值计算中的一个经典思想:让离散算法保留连续动力系统的内在结构,使长期计算保持可靠的整体行为。
在哈密顿系统中,这种思想集中体现为保辛(symplecticity preservation)。一些普通数值方法会在反复迭代中逐渐扭曲相空间,使轨迹向内收缩或向外漂移;辛积分器(symplectic integrator) 通过保持相空间的辛几何结构,改善长时间演化中的数值表现。Verlet 方法正是其中具有代表性的方案。
1984 年,中国科学院院士冯康先生提出基于辛几何的哈密顿系统算法,从动力系统的几何结构出发构造数值方法。这一工作推动了结构保持算法的发展,并在天体力学、分子动力学等领域的长期模拟中展现出重要价值。
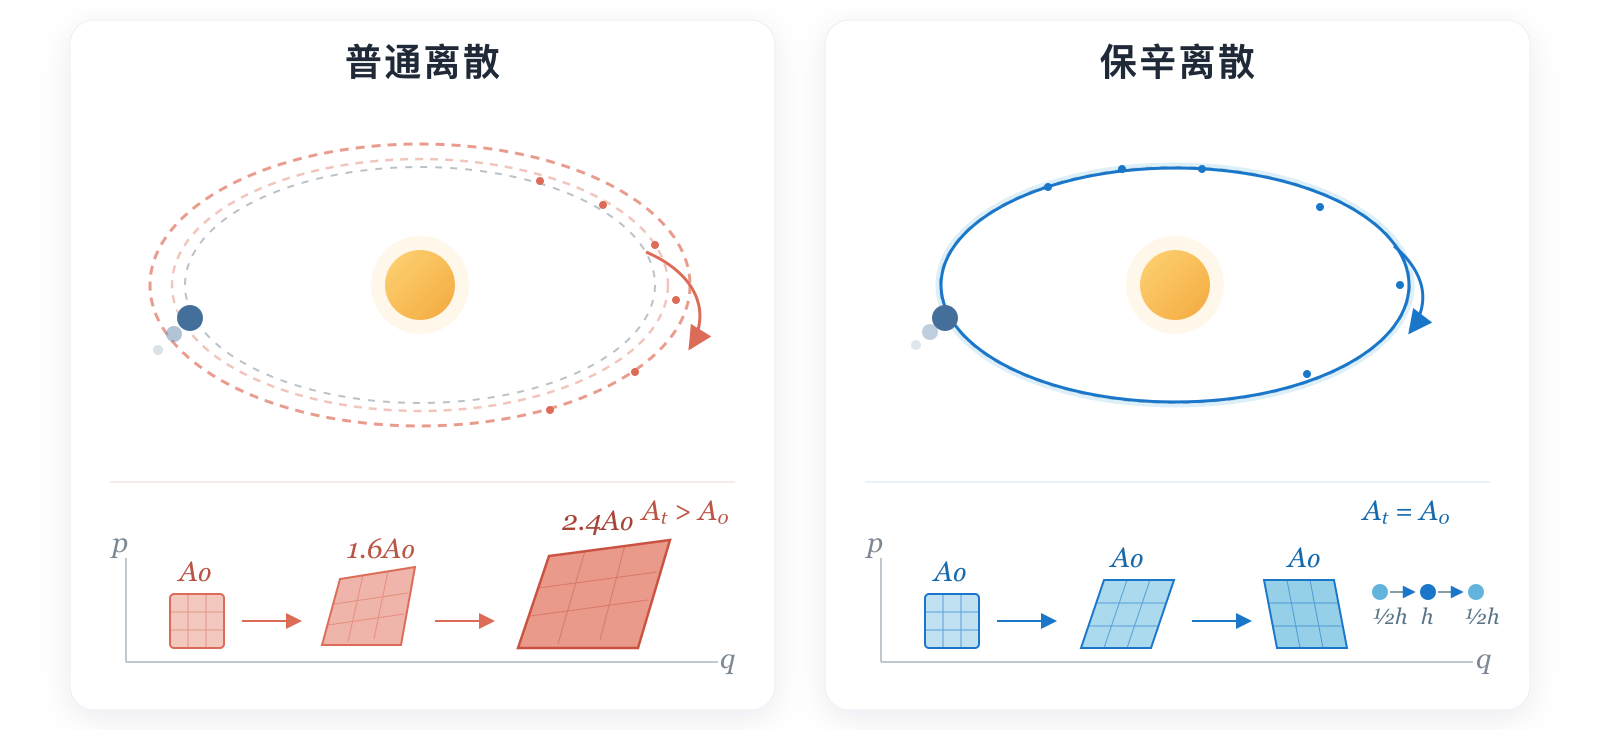
图 1:长时域轨道模拟示意。左侧,普通离散的误差逐步累积,数值轨道向外漂移,相空间小单元的面积逐渐放大;右侧,保辛离散在网格发生剪切变形的同时保持面积不变,较好地维持了轨道的长期几何形态。
理解这种长期数值行为,可以借助 shadow Hamiltonian(影子哈密顿量,也称修正哈密顿量):数值轨迹可以看作沿着一个与原系统非常接近的“影子系统”演化。这个修正系统保留了哈密顿结构,为理解辛积分方法的长期稳定性提供了直观视角。
SAFLOW 将这一结构保持思想引入生成式策略,把动作生成视为一个逐步演化的动力系统,并让离散映射本身具备时间对称性与精确可逆性。离散规则由此成为连接策略表达与在线优化的核心环节。
2.2 Verlet 式自伴随流:正向生成动作,反向计算似然
SAFLOW 将原本 (d) 维的动作空间扩展为由一对虚拟变量 ((x,y)) 构成的 (2d) 维表示,其中两个分量各为 (d) 维。两个分量通过交替耦合完成动作生成,随后再映射为环境实际执行的动作。
每一步流变换采用 Verlet 风格的 kick-drift-kick 对称组合:先对 (x) 推进半步,再对 (y) 推进整步,最后对 (x) 推进半步。正向生成使用步长 (h);逆向计算按相反的时间顺序,以步长 (-h) 执行同一套规则,即可得到对应的精确逆映射。
这一性质称为自伴随(self-adjoint)。它带来的关键结果是:在离散数值层面,初始高斯噪声与最终生成的扩展动作之间形成精确可逆的一一对应。对于任意一个由策略生成的动作,沿同一套 Verlet 规则反向计算,都可以恢复出对应的初始噪声;而初始噪声服从密度已知的高斯分布,因此只需结合各步流变换,通过变量替换公式便可得到该动作在当前策略下的似然概率。
这条可逆路径避免了额外使用近似的逆向求解器:用于计算似然的反向轨迹,就是生成动作时正向轨迹的数值逆过程。由此,动作采样与概率评估对应同一个离散策略,为后续构造可靠的新旧策略比率提供了基础。
具体来看,SAFLOW 将动作生成与似然计算组织为四个连续环节:
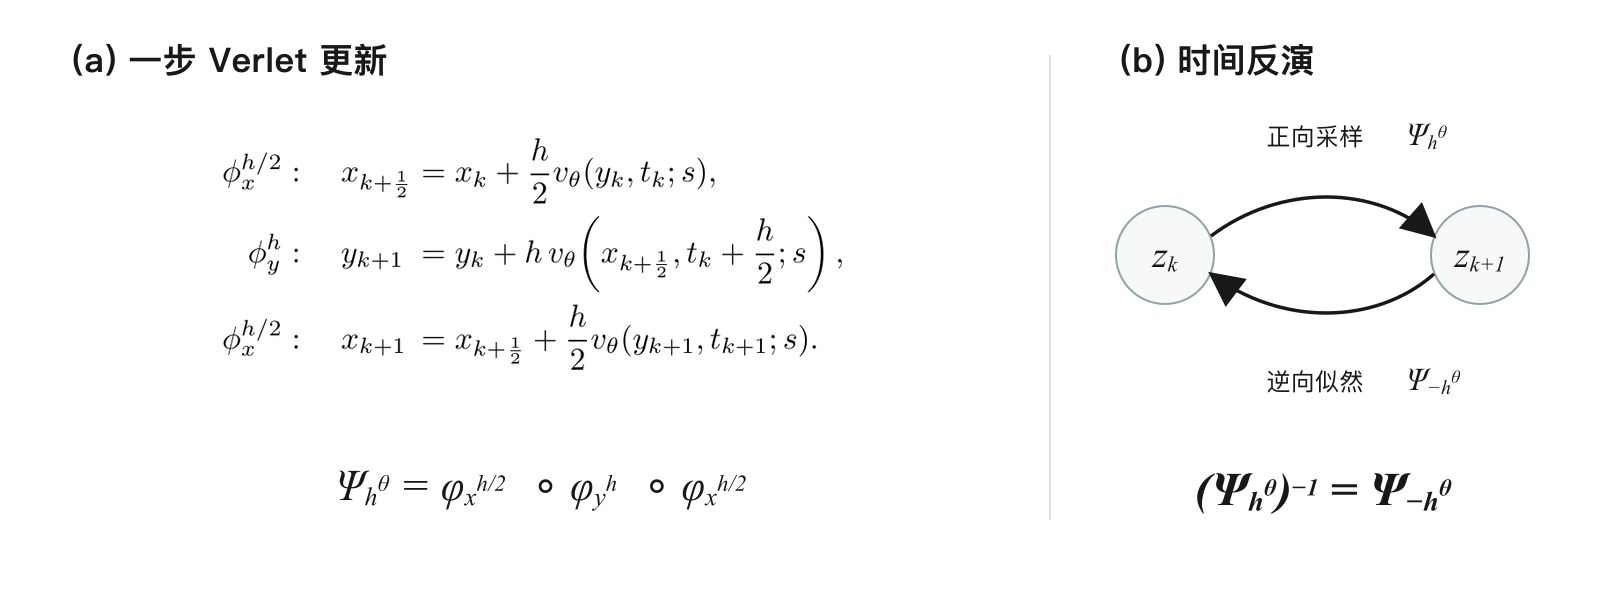
图 2:左侧为一步 Verlet 的“半步—整步—半步”更新,右侧展示通过反转步长得到的逆向计算。
- 正向采样: 从高斯噪声出发,逐步生成能够表达多峰分布的扩展动作。
- 逆向求解: 沿正向计算的精确逆过程,从扩展动作恢复与之对应的基础噪声。
- 似然评估: 结合基础高斯密度与沿途雅可比行列式,计算扩展策略的动作似然。
- 策略优化: 由新旧策略的似然构成策略比率,进入在线优化目标。
2.3 从可逆映射到优化目标:二阶一致性如何层层传递
将 (d) 维动作扩展到 (2d) 维,是构造对称流的关键一步,但也随之带来一个直接问题:在更高维空间中学习策略,会不会偏离原本的控制任务? SAFLOW 通过压缩正则项约束两个虚拟分量之间的偏离,使它们在获得建模自由度的同时保持协调。论文进一步建立了原始策略与扩展策略之间的对应关系,并证明扩展表述不会改变原控制问题的最优值。换言之,升维只是为自伴随流搭起一座“计算脚手架”,而不是重新定义任务。
在此基础上,自伴随结构的作用便不再局限于“能够原路返回”。由于 Verlet 的半步—整步—半步更新具有时间对称性,正向生成与逆向求解共享同一套离散规则,主要的一阶误差项能够相互抵消。理论分析表明,其相比于理想连续流的全局误差仅为 (O(h^2)),而一阶交替更新的全局误差仍有 (O(h))。
更重要的是,这种精度优势不会停留在动作轨迹本身。逆向恢复过程涉及流变换的雅可比矩阵,其行列式进入对数似然;新旧策略的对数似然进一步构成策略比率,最终影响策略优化目标。于是,一条清晰的传递链条形成了:更一致的离散映射 → 更准确的似然评估 → 更可靠的策略比率 → 更稳定的在线优化。 这也解释了为什么 SAFLOW 的“保结构”设计能够真正适合强化学习策略优化。
三、实验结果
3.1 八项任务全部取得最高平均回报
论文在 NVIDIA Isaac Lab 的 8 项连续控制任务上开展实验,包括 Ant、Humanoid、Franka Arm、Shadow Hand、Anymal-D、Unitree-Go2、Unitree-H1 和 Quadcopter。对比方法包括采用经典高斯策略的 PPO、TRPO,以及生成式策略方法 FPO、GenPO。
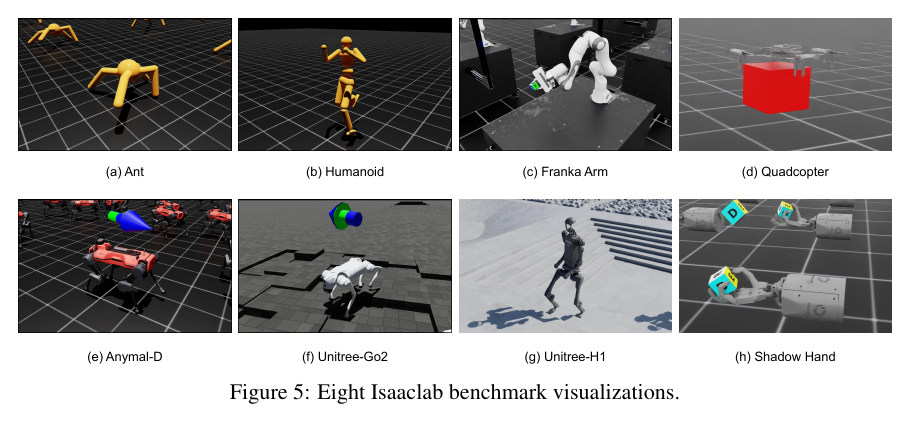
图 3:本文采用的 8 项 Isaac Lab 连续控制任务,覆盖经典控制、机械臂与灵巧手操作、四足与人形机器人运动以及四旋翼控制。
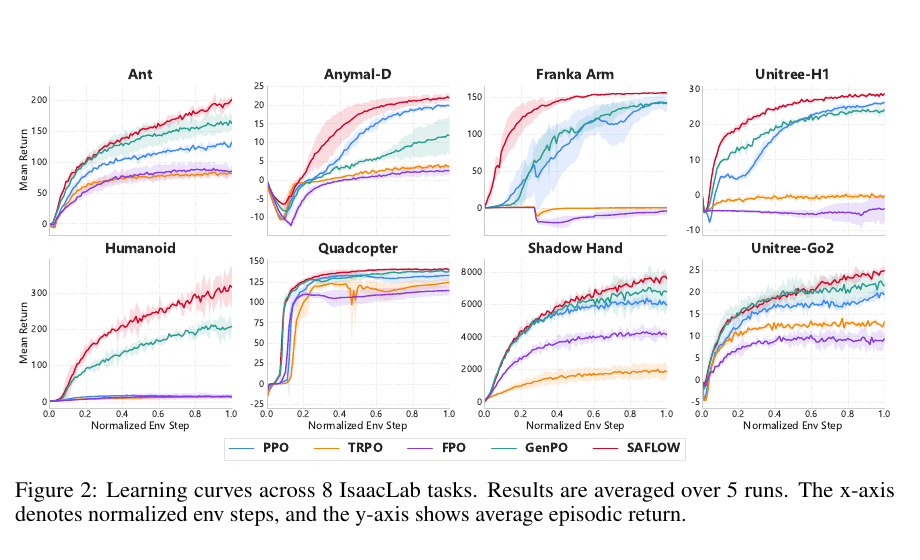
图 4:8 项任务的学习曲线。红色为 SAFLOW,阴影表示 5 次运行的波动范围。
主要实验结果如下:
- 八项任务全部领先。 SAFLOW 在所有环境中均取得最高平均回报,覆盖多种机器人形态与控制需求。
- 人形控制取得突出提升。 Humanoid 的平均回报从最佳基线的 218.44 提升至 329.60,相对提升约 50.9%;Unitree-H1 从 26.36 提升至 29.21。
- 机械臂与灵巧手任务同步受益。 高维度的 Shadow Hand 的平均回报从 7188.21 提升至 7984.18,Franka Arm 从 143.53 提升至 155.57。
- 学习速度与稳定性同时改善。 SAFLOW 在多个任务中更快达到较高回报,学习曲线的波动范围也更小。
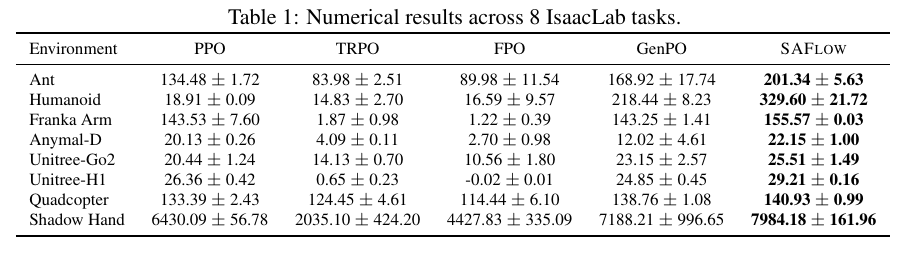
表 1:8 项任务的最终回报,结果由 5 个随机种子统计得到。
3.2 大规模并行采样下的优势更突出
论文在 Ant 任务上,将 GPU 并行环境数量从 128 扩展至 4096。结果显示,当并行环境数量达到 1024 及以上时,SAFLOW 相比 PPO 和 GenPO 的优势更加明显;随着并行规模继续扩大,性能收益进一步增长。
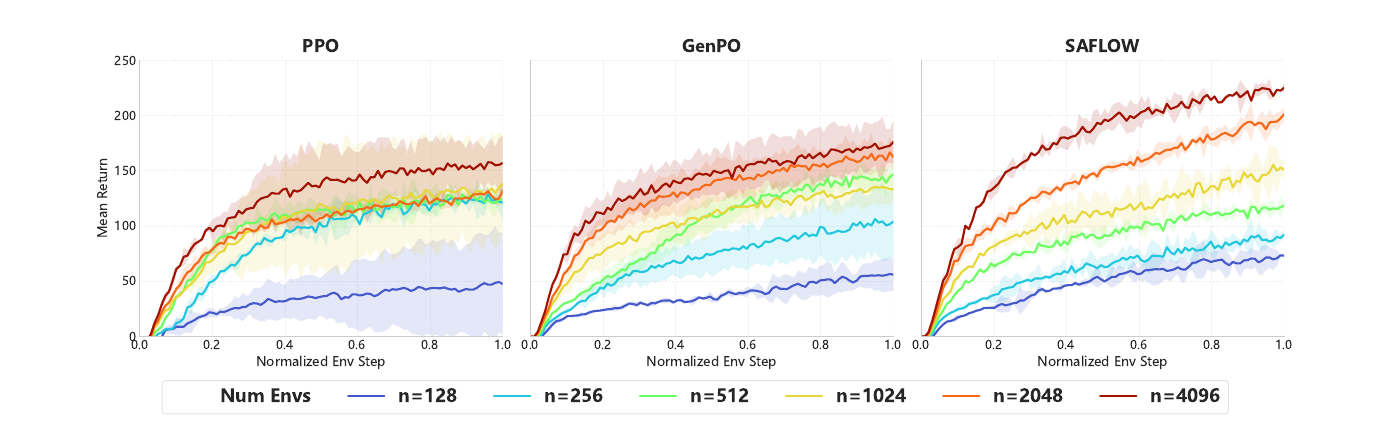
图 5:PPO、GenPO 与 SAFLOW 在 Ant 任务上的并行扩展实验,GPU 并行环境数量从 128 增加至 4096。
这一扩展能力为依托 GPU 并行仿真开展大规模具身控制训练提供了支持。
3.3 消融实验:自伴随积分结构带来持续收益
论文在统一的 SAFLOW 框架内,比较了一阶交替更新与二阶自伴随更新,两组实验采用相同的网络结构和辅助模块。
结果显示,二阶自伴随版本持续取得更高回报,体现出时间对称的 Verlet 式积分结构对策略学习的直接贡献。
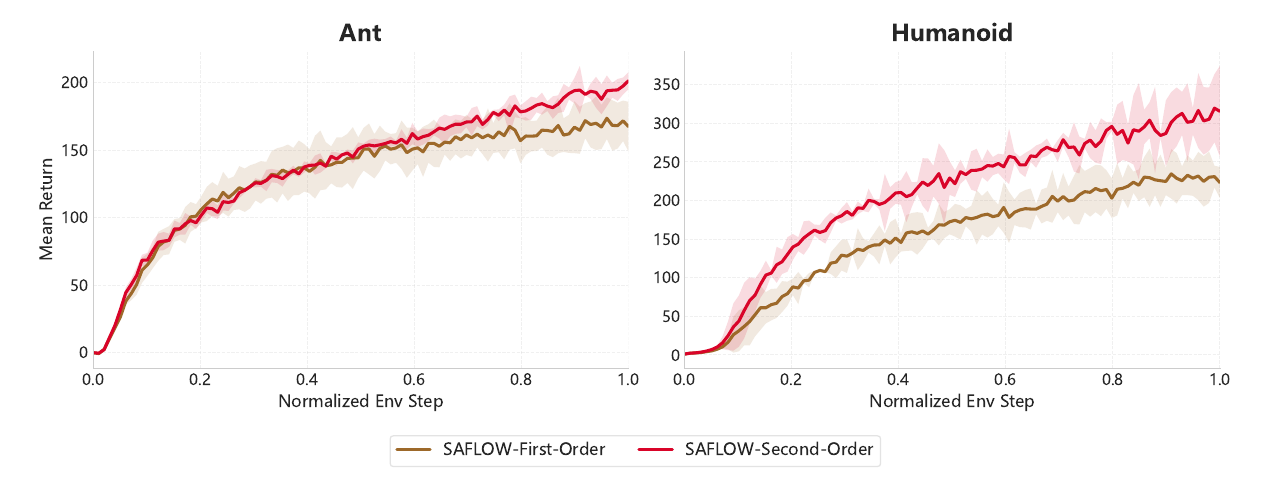
图 6:在相同网络结构和辅助模块下,一阶交替更新(棕色)与二阶自伴随更新(红色)的消融对比。
四、从“会生成”到“可优化”:面向具身智能的结构化动作接口
具身智能的动作模型,不能只会“给出一个动作”。它还要覆盖多种合理选择,知道每个动作的概率,并能在与环境交互后继续学习。
SAFLOW 的优势就在这里:
- 相比高斯策略,它可以表达更复杂、多峰的动作分布;
- 相比采用普通离散方式的生成式策略,它通过自伴随映射,让初始噪声与生成动作精确可逆,从而更准确地计算动作似然和策略比率;
- 二阶一致性则进一步延伸到策略优化目标。
8 项任务全部领先,以及并行规模扩大后更加明显的性能优势,也验证了这种结构设计对在线学习的实际价值。
这也让 SAFLOW 很适合作为视觉—语言—动作(VLA)模型的连续动作头,把高层语义和规划结果转化为机器人可以执行的动作。
结合 GPU 并行仿真、真实机器人交互和人类反馈,它还可以进一步用于具身智能模型的在线后训练,并探索机械臂、灵巧手、四足和人形机器人之间的跨任务、跨本体控制。
当上层模型回答“要做什么”时,SAFLOW 继续解决“动作怎么生成、概率怎么算、策略怎么越练越好”——让生成式策略从动作生成器,走向一个能评估、能训练、能持续优化的具身智能动作接口。
作者介绍
论文第一作者占国建为清华大学车辆学院、人工智能学院 2021 级直博生,研究方向包括强化学习、多模态大模型与具身智能。截至目前,他已以第一作者或共同第一作者身份发表或录用 CCF-A 类论文 10 余篇,曾获博士生国家奖学金等荣誉。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册