大模型的 RL 后训练里,有一个常被忽略、却可能让训练悄悄跑偏的隐患。
Rollout 与 Training 往往由两套不同的引擎执行。即使模型、权重、token 完全相同,两边的 LogP 也可能对不上——浮点归约顺序、并行分片、通信合并树、精度转换边界,任何一处不同,都会在数值上分叉。
一个直观的例子:因为有 0.1 + 0.2 + 0.3 = 1,而 0.3 + 0.1 + 0.2 在有限精度下可能等于 0。训练为反向传播、打包序列与多卡并行而优化,推理为 prefill、decode、动态批处理与 paged KV cache 而优化——同样的计算,两边未必走同一条浮点路径。
这不是小问题。
在 PPO/GRPO 里,importance ratio 直接用 rollout 端与训练端的 logprob 计算。偏差一旦非零,就相当于在策略更新之外,又叠加了一层"数值意义上的策略偏移",并沿着 KL 诊断与 clipping 一路传播。训练越久,越容易表现为不稳定。
RL-Kernel 团队与 vime 团队把问题拆成了两半:
- vime 负责对齐"时间线":哪个 token batch 属于哪一步、由哪个权重版本生成、何时把新权重同步给 vLLM;
- RL-Kernel 负责对齐"数值执行":哪些数值参与计算、归约域如何切分、部分结果按什么顺序合并、用何种中间精度、在哪一步舍入。
两者合起来,就是让训练引擎与推理引擎,在计算 logprob 时遵循同一份"数值执行契约"。

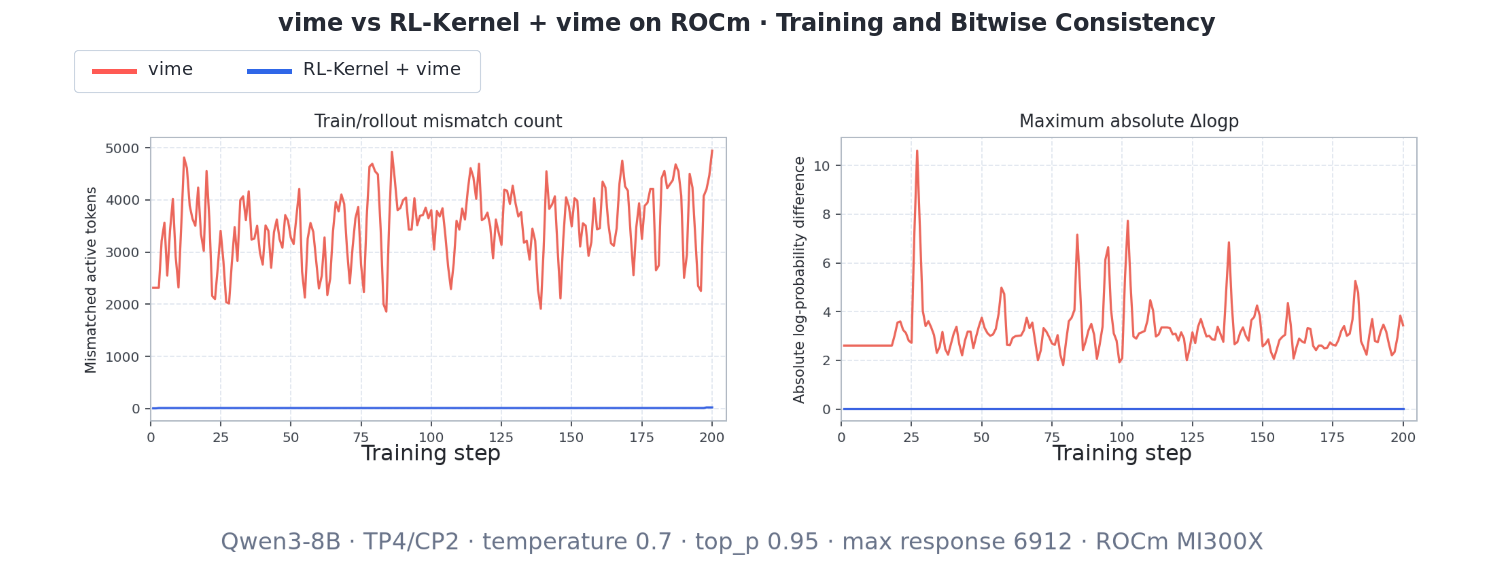
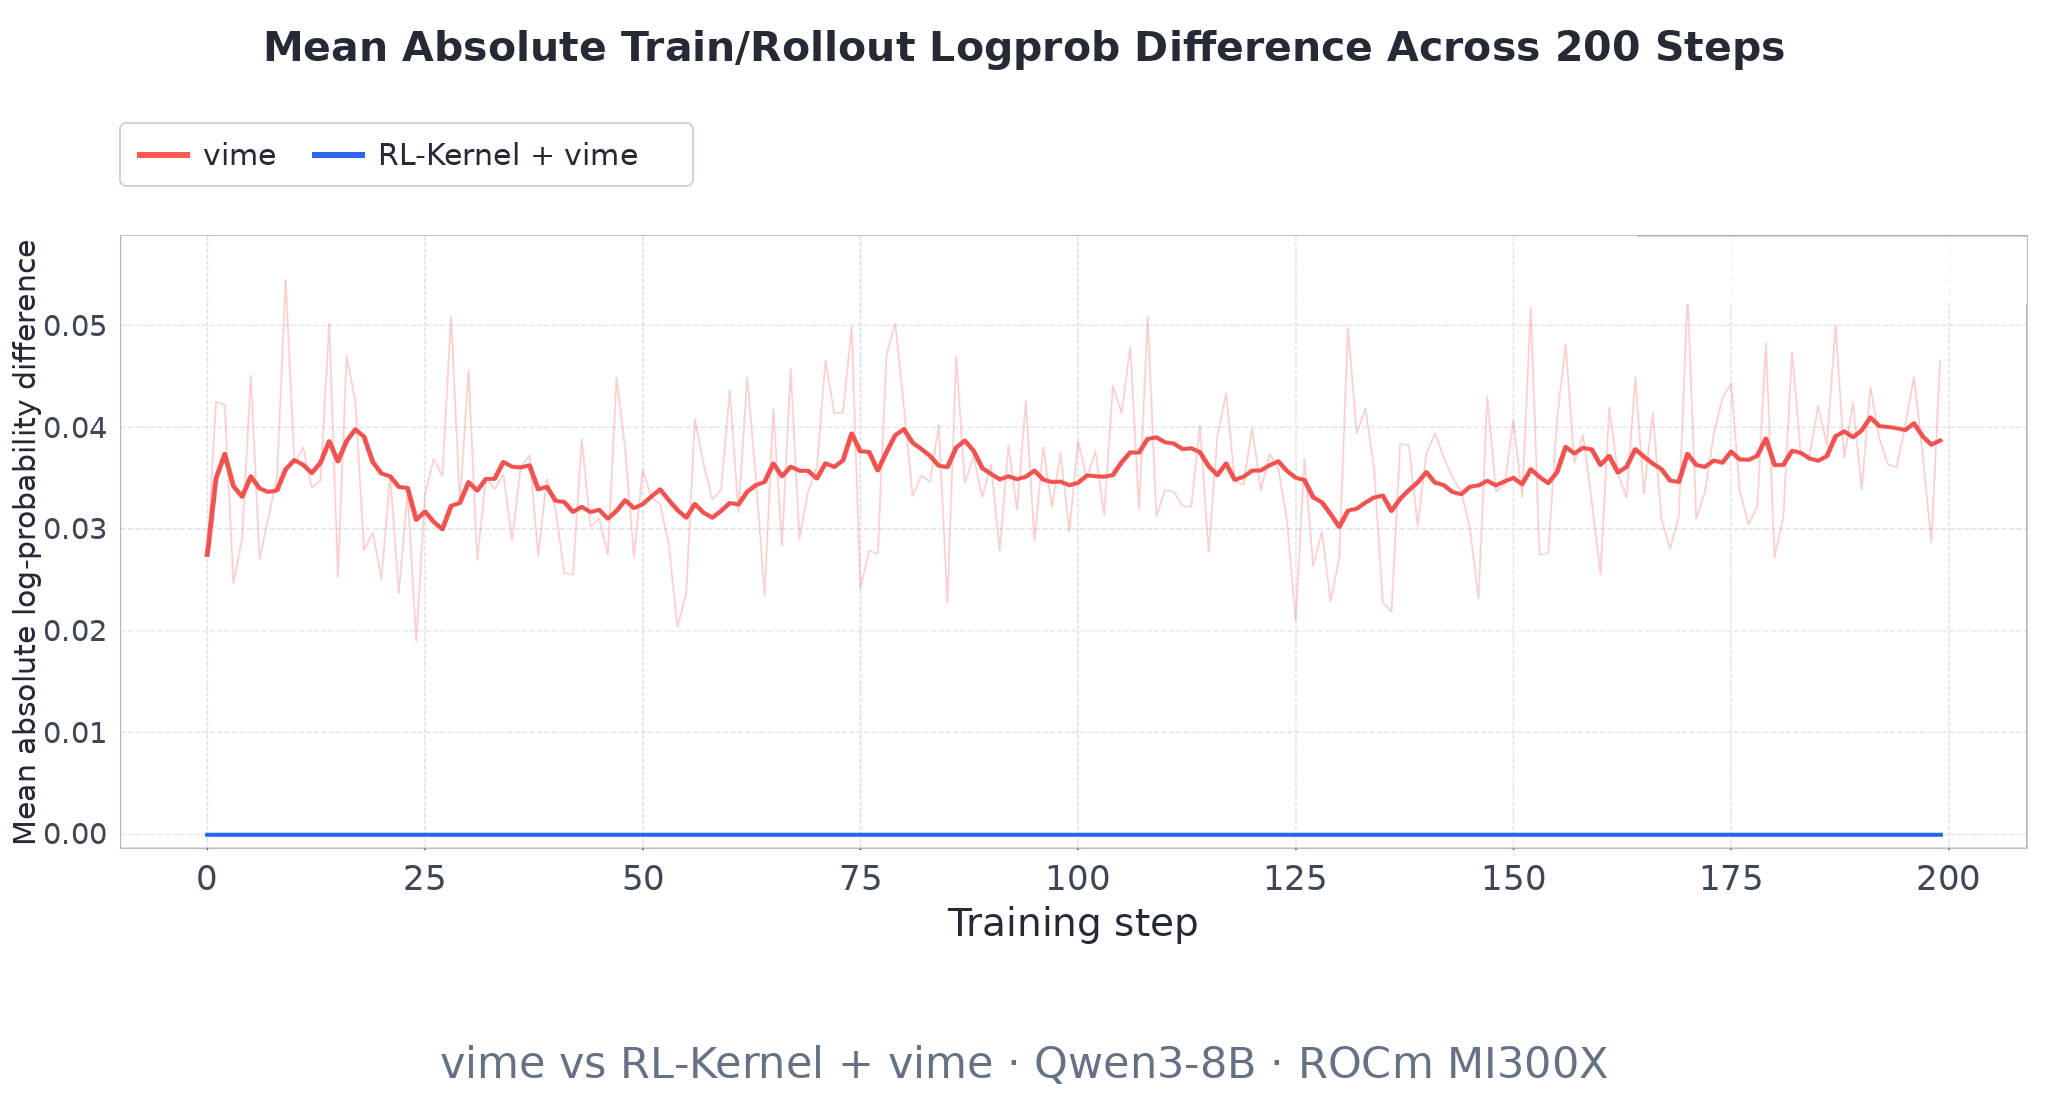
结果如何?在 AMD Instinct MI300X 上,8 卡 Qwen3-8B GRPO 的端到端实验连续跑满 200 步,mismatch_count = 0、max_abs_diff = 0——训练端与 rollout 端的 logprob 全程比特级一致。
这背后是对 Attention、FFN、logprob 与通信路径的逐项对齐,以及在 ROCm 上新增确定性 MFMA GEMM kernel、vocabulary reduction、HIP IPC 通信等一整套工作。
RL-Kernel 博客:https://rl-align.github.io/RL-Kernel/blog/
vLLM 博客:https://vllm.ai/blog/2026-09-14-rl-kernel-v0-1-0-train-rollout-bitwise-consistency
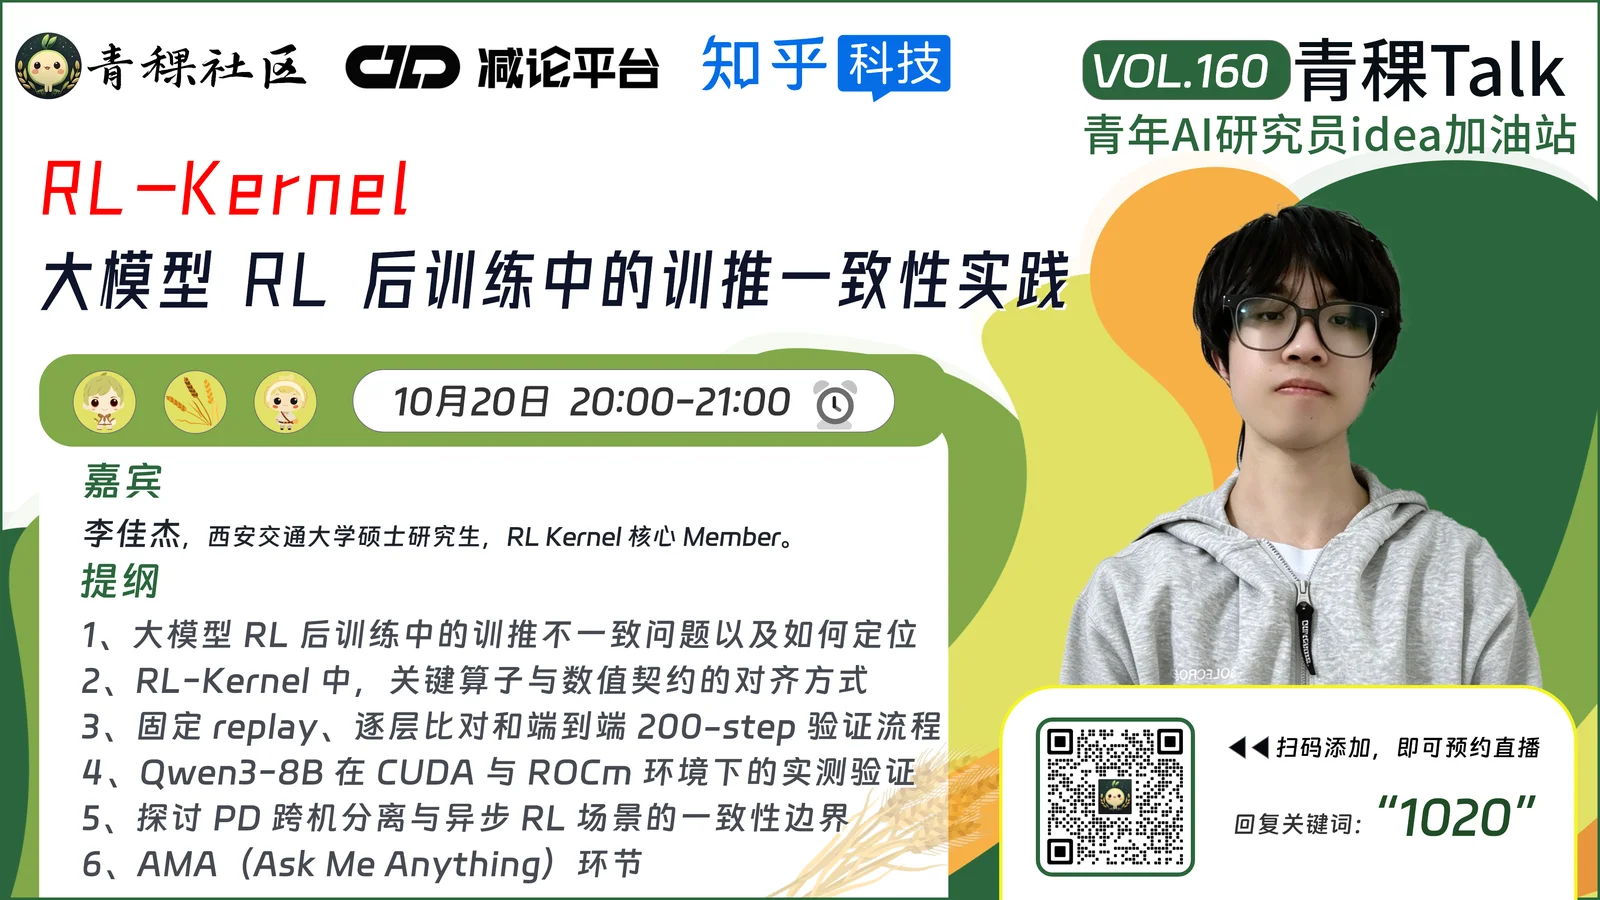
10月20日(周二)晚8点,青稞Talk 第160期,青稞社区邀请到 RL-Kernel 核心 Member、西安交通大学硕士研究生李佳杰,以 RL-Kernel v0.1.0 为例,介绍训推差异的定位方法、关键算子与数值契约的对齐方式,以及固定 replay、逐层比对和端到端 200-step 验证流程,并展示 Qwen3-8B 在 CUDA 与 ROCm 环境下的验证结果。最后讨论 PD 跨机分离与异步 RL 场景的一致性边界和后续接入计划。
主题提纲
RL-Kernel:大模型 RL 后训练中的训推一致性实践
1、大模型 RL 后训练中的训推不一致问题以及如何定位
2、RL-Kernel 中,关键算子与数值契约的对齐方式
3、固定 replay、逐层比对和端到端 200-step 验证流程
4、Qwen3-8B 在 CUDA 与 ROCm 环境下的实测验证
5、探讨 PD 跨机分离与异步 RL 场景的一致性边界
6、AMA(Ask Me Anything)环节
直播时间
10月20日(周二)20:00 - 21:00
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册