作者:YuhongChou
https://zhuanlan.zhihu.com/p/2098440900758205913
青稞社区为科研人员提供成果宣传支持,投稿联系:aiFreeCode
论文:Orthros: Phase-Aware Heterogeneous Attention for Efficient Transformers
链接:https://arxiv.org/html/2610.13735
我们构建了 Orthros Attention:同一套参数、同一个 Attention Module,可以在不同阶段切换计算模式——Linear Prefilling,Full Attention Decoding。
TL;DR
过去的 Efficient Transformer,通常在“哪些层用 Full Attention、哪些层用 Linear Attention”上做文章。
Orthros 换了一个维度:不是按层分配计算,而是按阶段分配计算。
- 在 Prefilling 阶段,大部分 token 只运行 Sliding Window Attention,让长输入的处理复杂度保持线性;
- 在 Decoding 阶段,每个输出 token 都通过 Full Cross-Attention 访问完整 KV Cache,保留 Full Attention 的全局检索能力;
- 两种模式共享同一套 Attention 参数,不需要把模型拆成两个 Decoder,也不需要压缩或丢弃历史 KV;
- 在 8B 模型上,Orthros 的 Prefilling 获得 21.9× speedup,同时在 128K Needle-in-a-Haystack 上接近满分。
一句话概括:
输入可以便宜地读,输出仍然认真地想。
背景:Efficient Attention 的“不可能三角”
长上下文正在从特殊需求变成默认需求。多模态理解、代码仓库分析、Agentic Workflow,输入动辄几十万甚至上百万 token。
问题是,标准 Full Attention 的计算量会随序列长度平方增长。上下文越长,Prefilling 越容易成为系统瓶颈。
Linear Attention 和 Sliding Window Attention 可以把复杂度降到线性,但通常要付出一个代价:In-Context Recall 下降。状态压缩会损失信息,有限窗口又可能直接看不到远处的关键 token。
工业界常见的补救方案是 Hybrid Transformer:部分层使用高效 Attention,部分层保留 Full Attention。它确实有效,但只要模型中还存在 Full Attention 层,长序列 Prefilling 的整体复杂度就仍然是 quadratic。得到的更多是 常数倍的加速,而不是渐进复杂度层面的改变。
我们因此重新审视了一个更基本的问题:
Prefilling 和 Decoding,真的应该使用完全相同的计算方式吗?
Prefilling 一次吞入大量 prompt token,通常是 compute-bound;Decoding 每一步只处理很少的 token,却要反复读取庞大的模型权重,通常是 memory I/O-bound。
既然两个阶段的任务和硬件瓶颈都不同,最合适的 Attention 也未必相同。
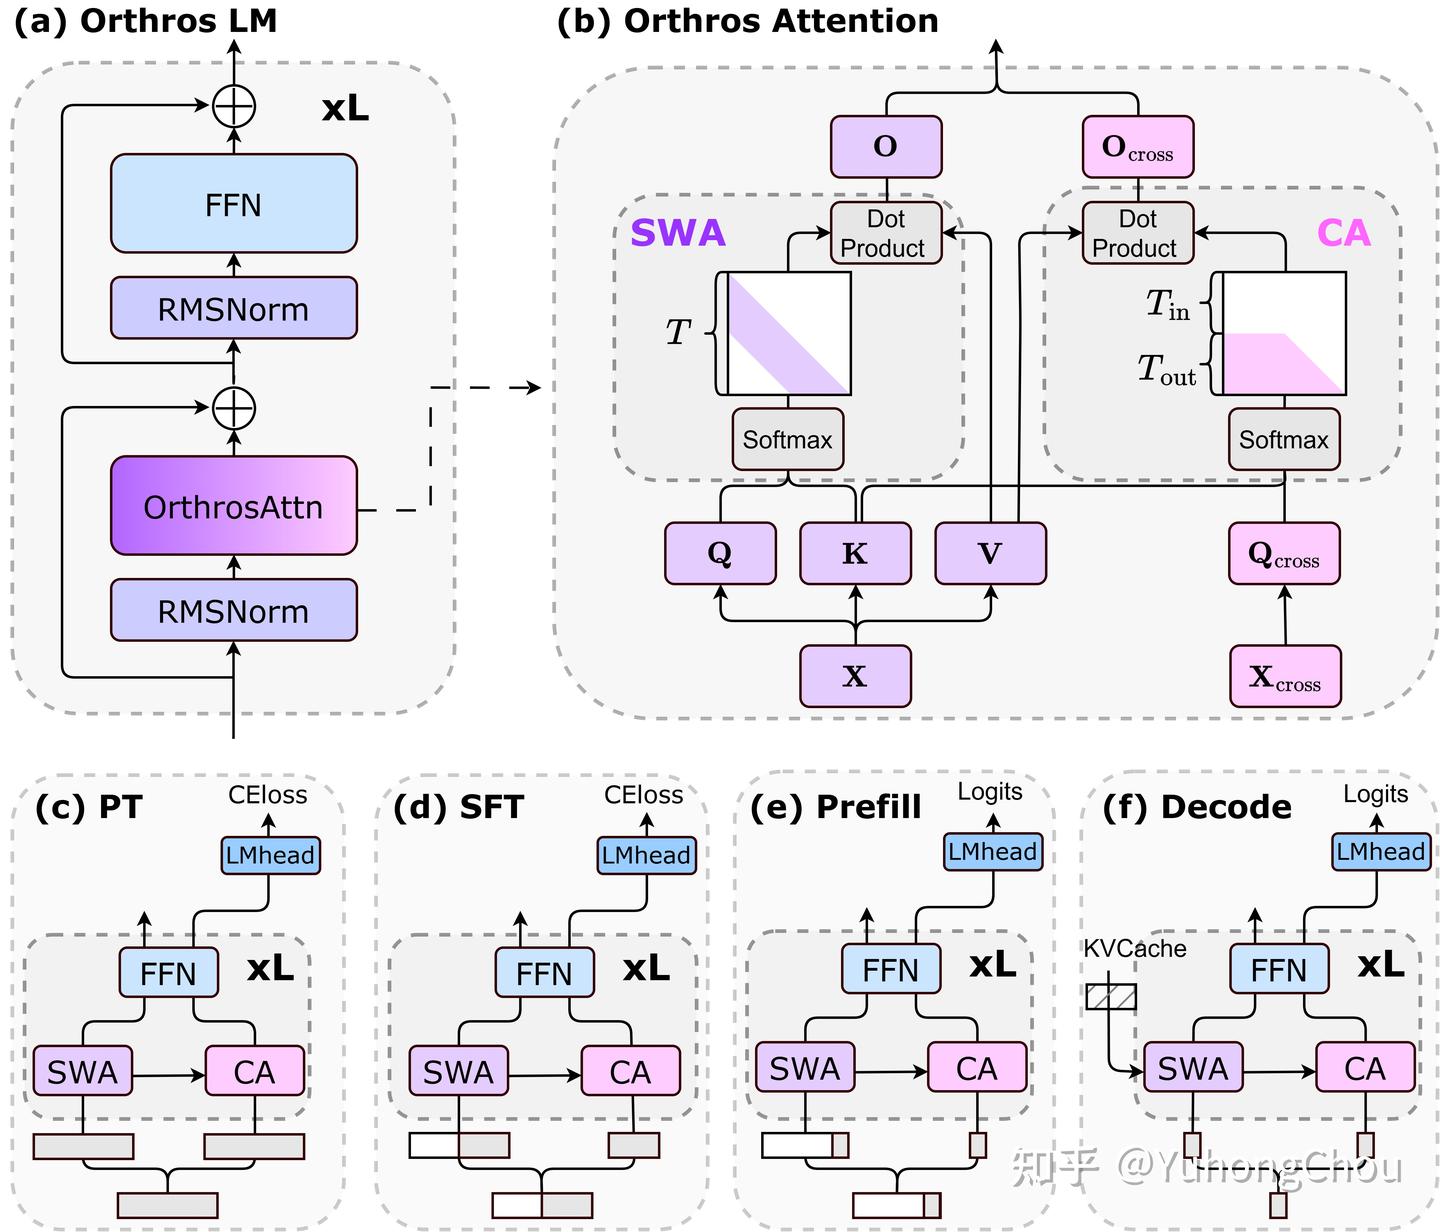
我们的方法:一个 Attention,两种工作模式
Orthros 的核心非常直接:
1、所有 token 都通过 Sliding Window Attention(SWA) 处理局部信息,并逐层建立 KV Cache;
2、只有真正承担 next-token prediction 的位置,才额外运行一次 Full Cross-Attention(CA),读取完整历史 KV;
3、SWA 和 CA 共享同一套 Q/K/V/O projection,仅用轻量的 Scale-Offset 区分两种 Query 的角色。
于是,同一个 Orthros Attention Module 在不同阶段会自然呈现不同的计算模式。
Prefilling:用线性复杂度读完整段输入
假设 prompt 长度为 T。Orthros 对全部输入 token 运行 SWA,但只为最后一个 prompt token 运行 Full Cross-Attention,用来预测第一个输出 token。
也就是说,序列再长,需要执行 Full Attention 的 Query 仍然只有一个。Prefilling 不再计算一个 T\times T 的 Attention Map,计算复杂度随输入长度近似线性增长。
Decoding:每个输出 token 都能看见完整上下文
在每个 Decoding step,当前 token 会形成一对共享权重的表示:
- 一个执行 SWA,并更新 KV Cache;
- 另一个执行 Full Cross-Attention,在完整 KV Cache 上检索信息并预测下一个 token。
因此,Orthros 没有把长上下文压缩进固定大小的 state,也没有因为 Sliding Window 而永久丢掉窗口外的信息。负责生成答案的 token,始终拥有全局视野。
Training、SFT 和 Inference 使用同一套机制
Orthros 不依赖额外的 Decoder 或训练后外挂模块。Pre-training、SFT、Prefilling 和 Decoding 的差别,只是需要预测的 output positions 数量不同。
- Pre-training:所有位置都参与 next-token prediction;
- SFT:只有 response token 参与预测;
- Prefilling:只有最后一个 prompt token 负责启动生成;
- Decoding:每一步只有当前 token 负责预测下一个 token。
这让 Training–Inference 保持严格一致,也让现有 Transformer 可以通过替换 Attention Module 转换为 Orthros。
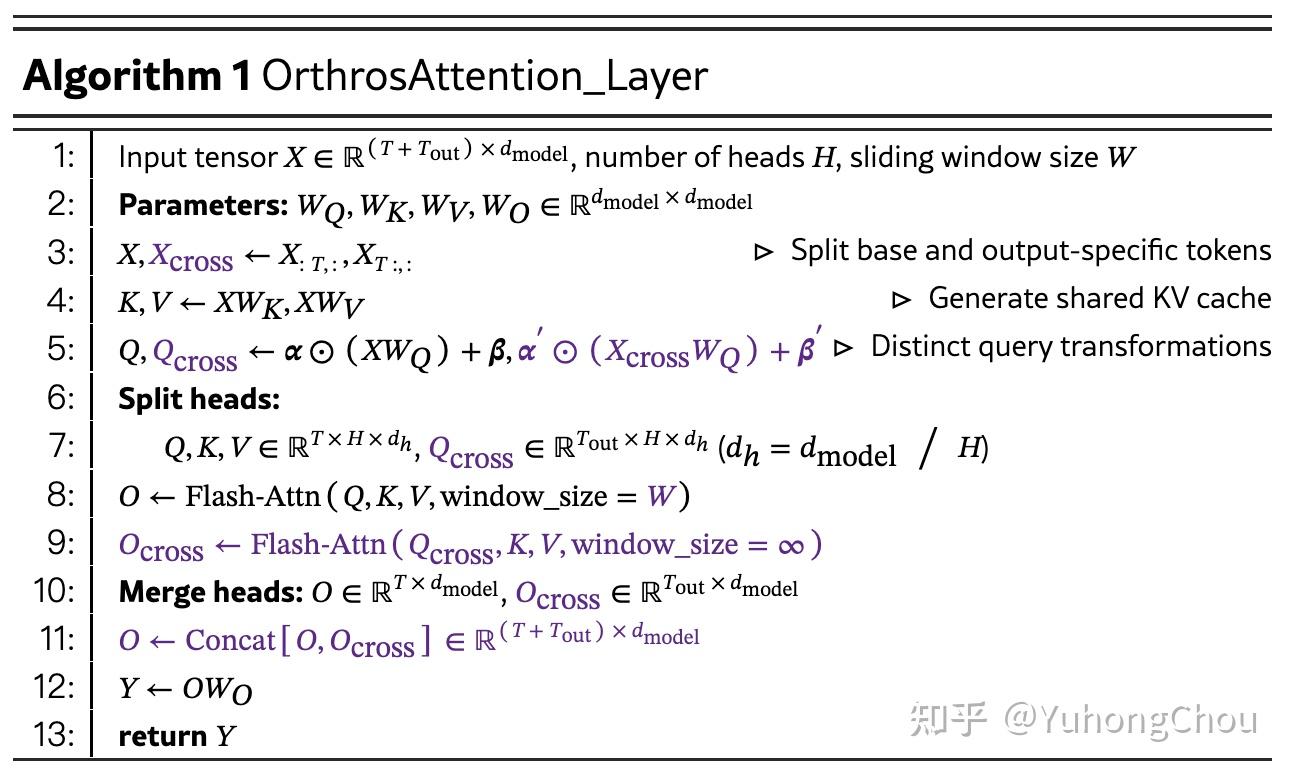
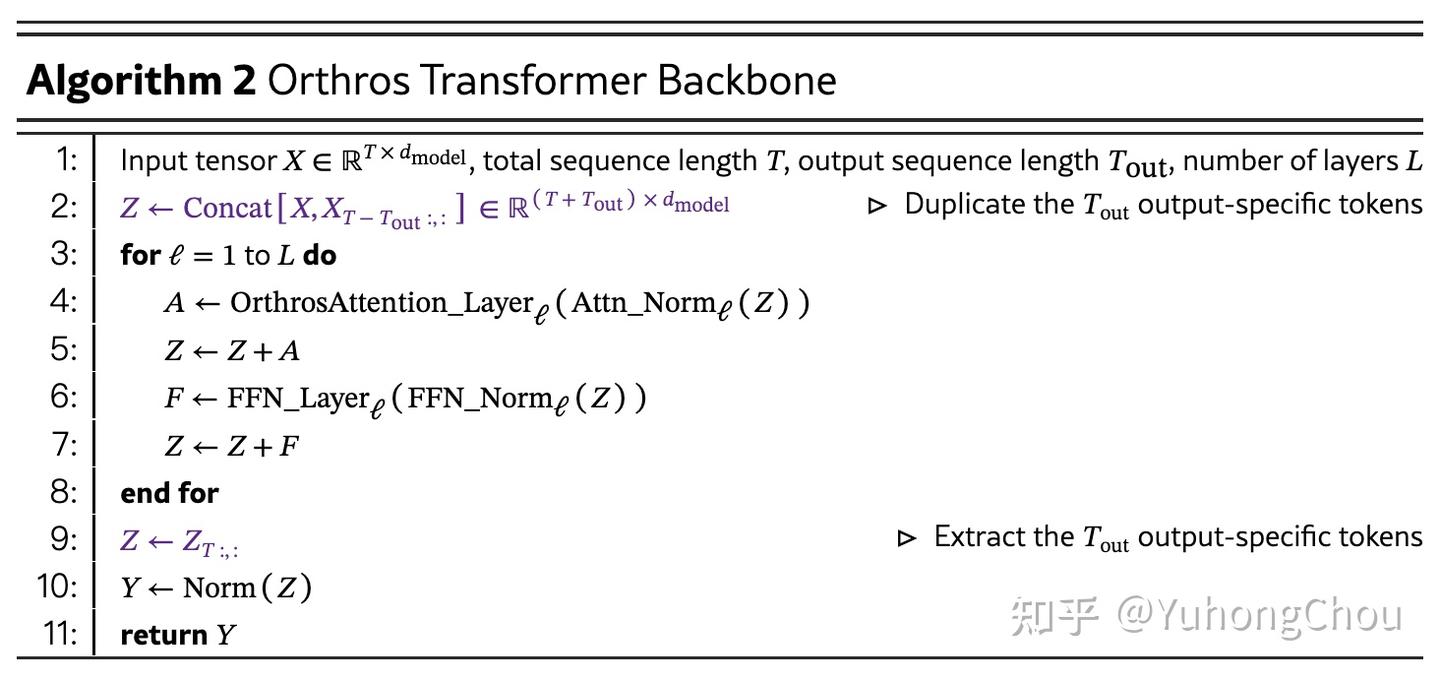
复杂度直觉:把昂贵计算留给输出
Orthros 的主要计算可以理解为三部分:SWA、output positions 对完整 KV 的 Cross-Attention,以及 token-wise projection。
关键变量不再只是总长度 T,还有输出长度 T_{out}:
- 当 T_{out}\ll T 时,整体复杂度是 subquadratic;
- 当 T_{out} 近似常数时,例如长文档问答、工具调用和许多 Agent 场景,Prefilling 可以视为 linear complexity;
- 只有在 Pre-training 这类“每个位置都要预测”的情形中,复杂度才会回到 quadratic。
这并不是凭空消灭计算,而是重新分配计算:
少在输入上做重复的全局交互,多在真正产生输出的位置上使用 Full Attention。
实验:效率、能力和可转换性,能否同时保住?
我们从模型 Scaling、从头训练、已有模型转换、长上下文 Recall 和真实推理效率几个角度进行了验证。
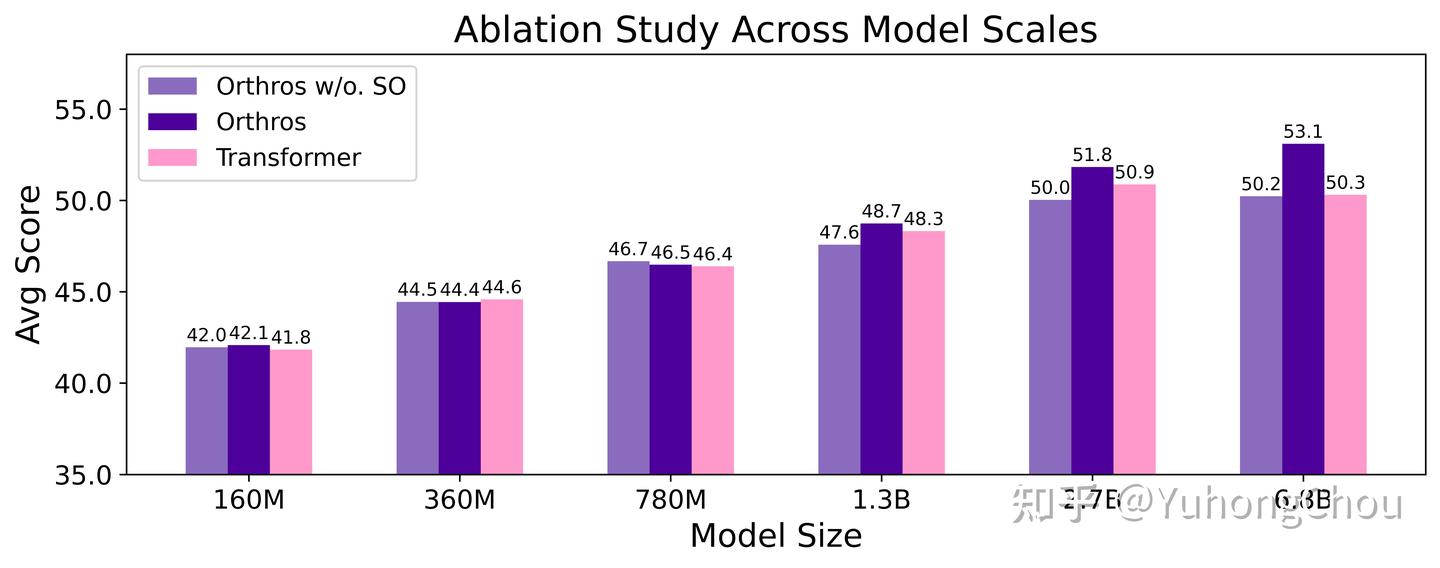
从 160M 到 6.8B,Orthros 可以正常 Scaling
在统一的 10B-token 训练预算下,我们将模型从 160M 扩展到 6.8B。Orthros 的表现随规模稳定提升,并在较大模型上逐渐拉开与 Transformer 的差距。
在 6.8B 规模上,Common Sense Reasoning 平均分达到 53.1,Transformer 为 50.3。移除 Scale-Offset 后得分降至 50.2,说明轻量的角色区分对共享参数十分关键。
从头训练,语言建模能力不输 Transformer
我们在 100B tokens 上从头训练 1.3B 模型。Orthros 在七项 Common Sense Reasoning 任务上的平均分为 53.98,高于 Transformer 的 53.41,也超过 GDN、GLA、RetNet 和纯 SWA 等高效架构。
这至少说明:阶段异构的 Attention 并没有破坏模型最基本的 Scaling 和语言建模能力。
不必推倒重练:已有 8B Transformer 可以直接转换
我们进一步把 Llama-3.1-8B 和 Qwen3-8B 的原始 Attention 替换为 Orthros,并使用 80B tokens 做 Continual Pre-training。
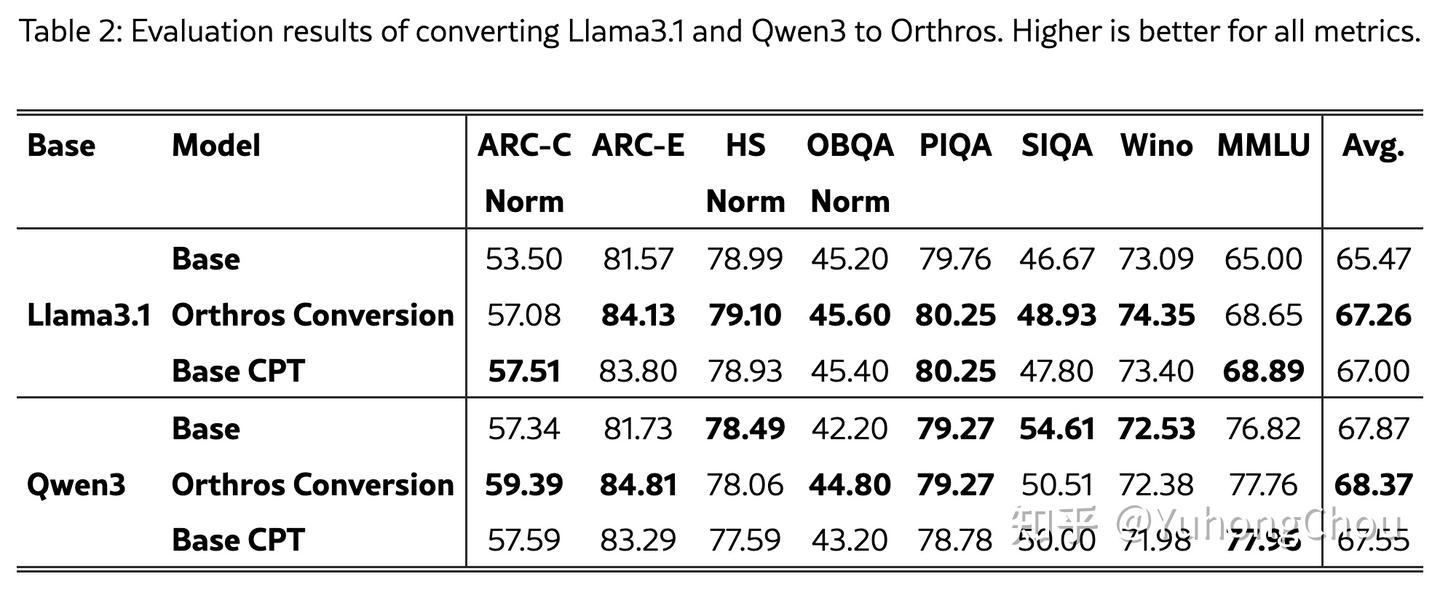
为了避免“只是多训练了数据”的质疑,我们还让原始 Transformer 在完全相同的数据上继续训练,作为 Base CPT 对照。
- Llama-3.1:Orthros Conversion 平均分 67.26,Base CPT 为 67.00;
- Qwen3:Orthros Conversion 平均分 68.37,Base CPT 为 67.55。
换句话说,Orthros 不仅可以从头训练,也具备较强的 Transformer-to-Orthros conversion 能力。对于已经投入巨额成本训练好的 Foundation Model,这一点可能比“再训练一个新架构”更重要。
Efficient Attention 最难的 Recall,Orthros 保住了
在六项 In-Context Recall-intensive benchmarks 上,1.3B Orthros 的平均分为 34.4,略高于 Full Attention Transformer 的 33.9;其他高效架构则存在更明显的差距。
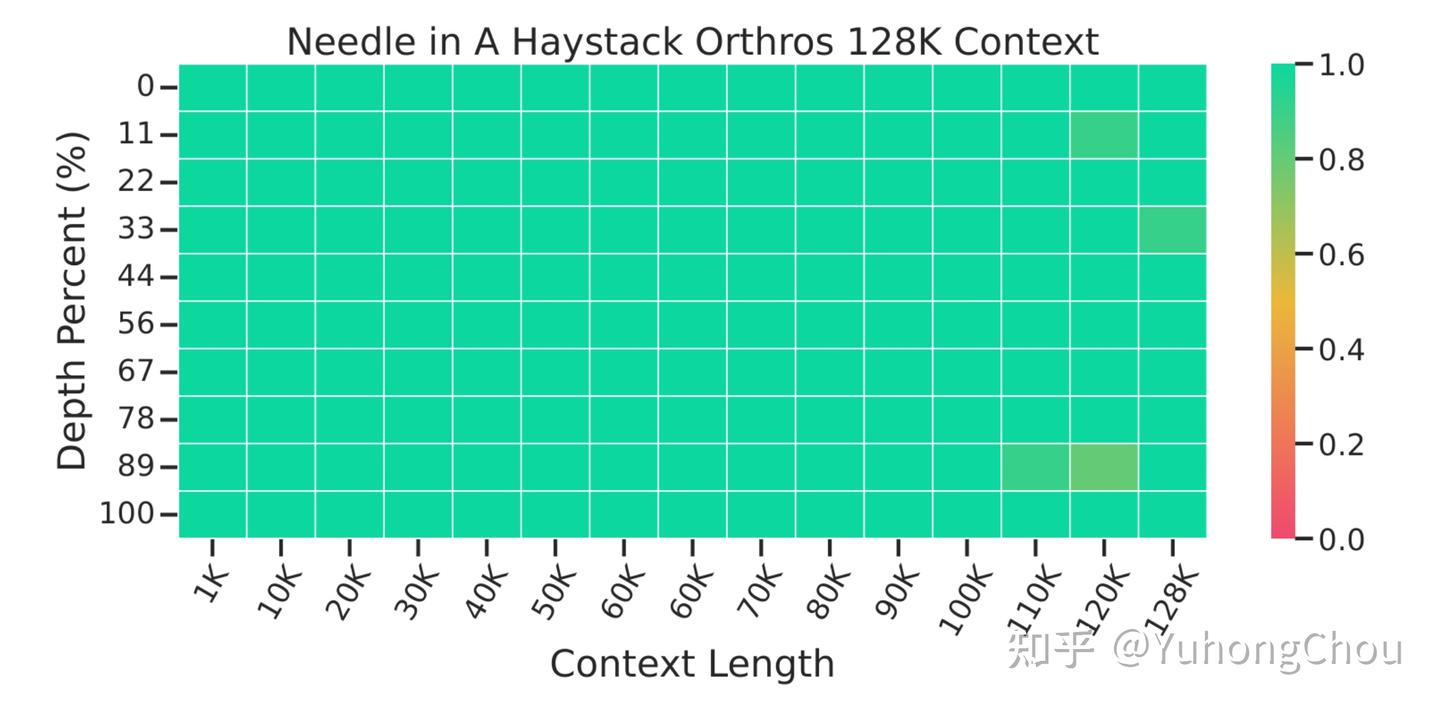
在进一步的 Long-context Extension 后,转换自 Qwen3-8B 的 Orthros 在 128K Needle-in-a-Haystack 测试中取得近乎全绿的检索结果。
最长 1M Context,Prefilling 加速 21.9×
效率是 Orthros 最直接的收益。
对于 8B 模型:
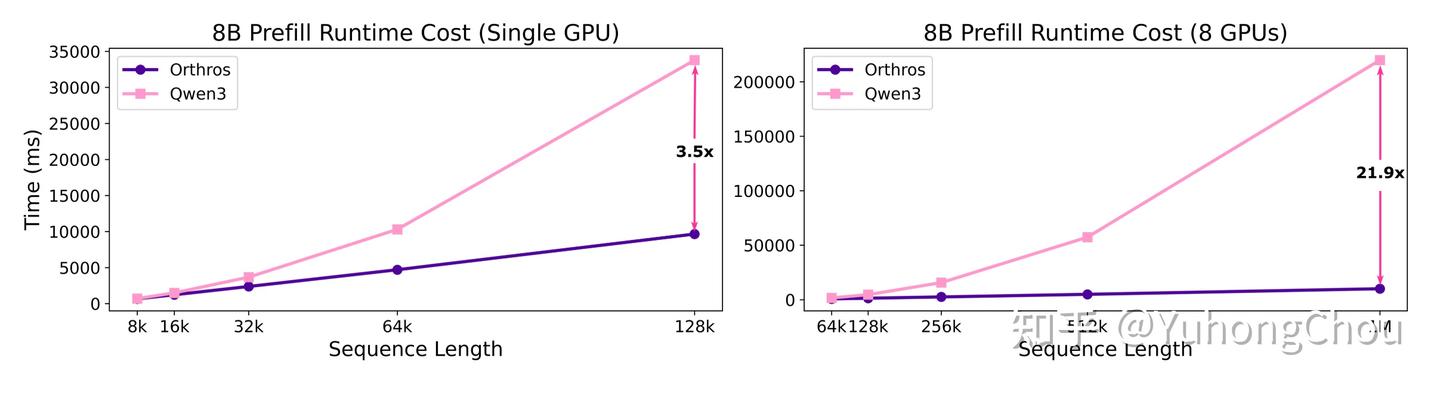
- 单卡、128K 输入:Prefilling 加速约 3.5×;
- 8 卡、1M 输入:Prefilling 加速达到 21.9×。
而且,序列越长,Orthros 相对 Full Attention 的优势越明显。这正是 linear 与 quadratic scaling 差异应有的形状。
加速也能转化为 End-to-End 收益。在单张 H100、128K input / 128 output、batch size 2 的设置下:
- Prefilling latency:77.25s → 17.02s;
- End-to-End latency:84.91s → 24.65s。
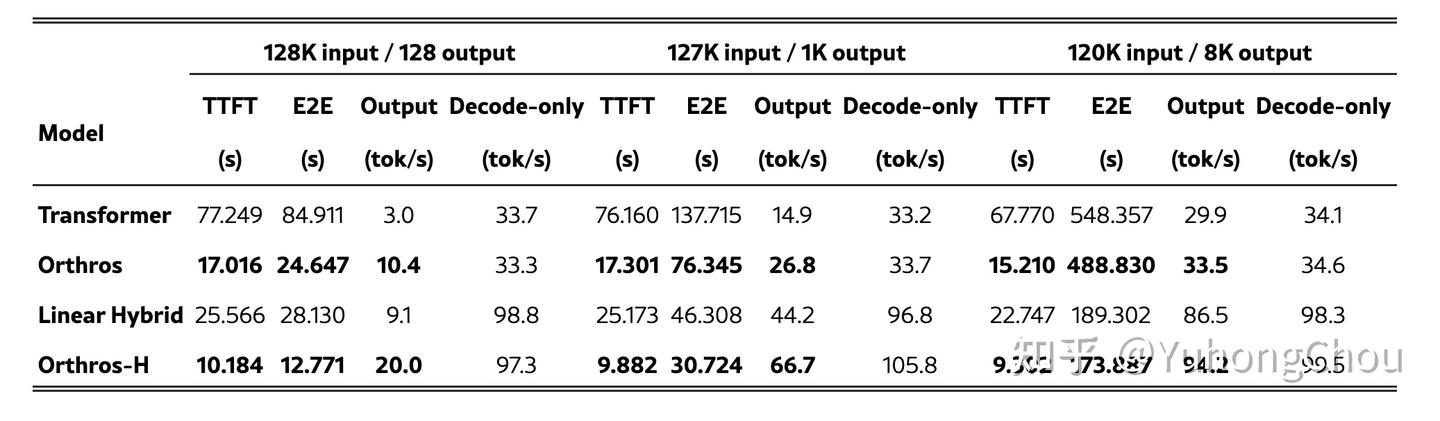
与此同时,Orthros 与 Transformer 的 Decoding 效率也基本相当。
这验证了我们的核心系统判断:Decoding 时虽然处理了成对 token、增加了 FLOPs,但这一阶段主要受模型权重读取限制。额外计算大部分被 memory I/O latency 掩盖,并没有等比例转化为延迟。
设计思路:为什么两种模式要绑定权重?
一个自然的问题是:既然 SWA 和 Full Cross-Attention 承担不同功能,为什么不为它们准备两套独立参数?
首先,这是一个系统选择。
Decoding 通常是 memory I/O-bound。Orthros 能够“多做计算但几乎不增加延迟”,重要前提就是两条计算路径共享 projection weights:权重从显存读入一次,即可服务两个 token representation。如果使用两套完整参数,额外权重读取很可能直接变成新的 Decoding latency。
其次,这是一个比较选择。
绑定权重使 Orthros 与原始 Transformer 保持接近的参数量,实验能够尽可能公平。否则,性能提升究竟来自架构,还是仅仅来自更多参数,会变得难以区分。
但共享也不能让两个角色完全相同。因此我们引入极轻量的 Scale-Offset,为 SWA Query 和 Cross-Attention Query 提供不同的仿射变换。Ablation 显示,这种“小幅解耦、主体共享”的设计在大模型上尤其重要。
当然,完全对参数做完全解耦可能继续提高模型能力。真正的问题不是“更多参数是否有效”,而是:
额外参数带来的收益,是否与新增的 I/O、显存和比较成本相称?
这是我们认为值得继续探索的方向,例如只解耦部分 projection、低秩增量参数,或针对不同工作负载动态选择共享程度。
讨论:现有 Scaling Ladder,少了一根轴
当前评价新架构时,一个主流思路是比较:在相同 Training FLOPs 下,谁的 loss 更低。
这个标准当然重要,但它默认训练计算几乎是唯一成本。Orthros 暴露了它的盲点:为了保持 Training–Inference consistency,Orthros 在 Pre-training 中会处理更多 token representation;但模型训练一次之后,可能要被部署和调用数十亿次,而它节省的是每一次长上下文推理的 Prefilling 成本。
如果只看 Training FLOPs,Orthros 可能显得“不够便宜”;如果看整个模型生命周期,答案可能完全不同。
换言之,也许 Scaling Ladder 不应只有 Parameters、Data、Training Compute,还应有一根长期缺席的轴:Inference Efficiency。
Orthros 的最佳场景也因此非常明确:长输入、短输出、Prefill-dominated workloads。例如长文档理解、多模态输入、代码仓库分析、RAG,以及需要频繁读取长历史但输出结构化动作的 Agent。
它并非在所有场景都占优。当输出长度持续增加,Decoding 会占据更高比例,End-to-End speedup 自然缩小;Pre-training 本身也不享受线性复杂度。此外,MoE routing、不同 batch size 下的 Decoding kernel,以及主流 inference engine 的深度适配,都仍需要继续研究。
写在最后
过去,我们谈 Efficient Transformer,常常在模型结构上做静态取舍:某些层负责效率,某些层负责能力。
Orthros 尝试给出另一种答案:效率不一定要被固定在某一层,也可以随计算阶段动态变化。
Prefilling 的目标是快速消化海量输入,Decoding 的目标是利用完整上下文做出下一个预测。让它们使用不同的计算模式,不是妥协,而可能是一种更符合任务和硬件本质的分工。
如果说 Transformer 让所有 token 彼此交流,那么 Orthros 想进一步追问:
阅读 -- 次每个阶段、每个 token,真的都应该为这种交流支付同样的代价吗?
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册