机器人数据不足且难以跨本体复用:夹爪录的“把杯子放进盒子”换到灵巧手上,手型和接触就全变了,机械臂、人形机器人、夹爪、灵巧手动作空间对不上,一批数据往往只能喂一个本体。另一边,人类第一人称视频数量巨大,却与机器人之间存在本体差异。
11月5日,青稞Talk 166 期邀请到 Ropedia W0 一作、南洋理工大学 MMLab 博士生、Ropedia 研究科学家刘天齐,分享《具身世界模型 Ropedia W0:从人类第一人称经验中学习跨本体的移动操作》。
本次分享深入讲解了具身世界模型 Ropedia W0 如何从人类第一人称经验中学习跨本体的移动操作。内容涵盖具身世界模型规模化的数据困境、Xp-Data 的构建与五阶段清洗管线、相机位姿加投影骨架的统一运动学表示、模型设计与两阶段训练策略,以及人类经验的 Scaling 效应,并展示了从分钟级生成到实时 VR 交互、策略评估、模型基规划和世界-动作模型初始化等应用,最后探讨了跨本体移动操作的未来方向。
开场与介绍
谢谢青稞社区提供了这次机会。大家好,我是刘天齐,现在是新加坡南洋理工大学 MMLab 的一年级 PhD,导师是刘子纬老师,同时我也在 Ropedia 做 research scientist。很高兴今天能在青稞社区和大家分享一下我们最近的工作,叫 Ropedia W0,题目是从人类第一人称经验中学习跨本体的移动操作的世界模型。
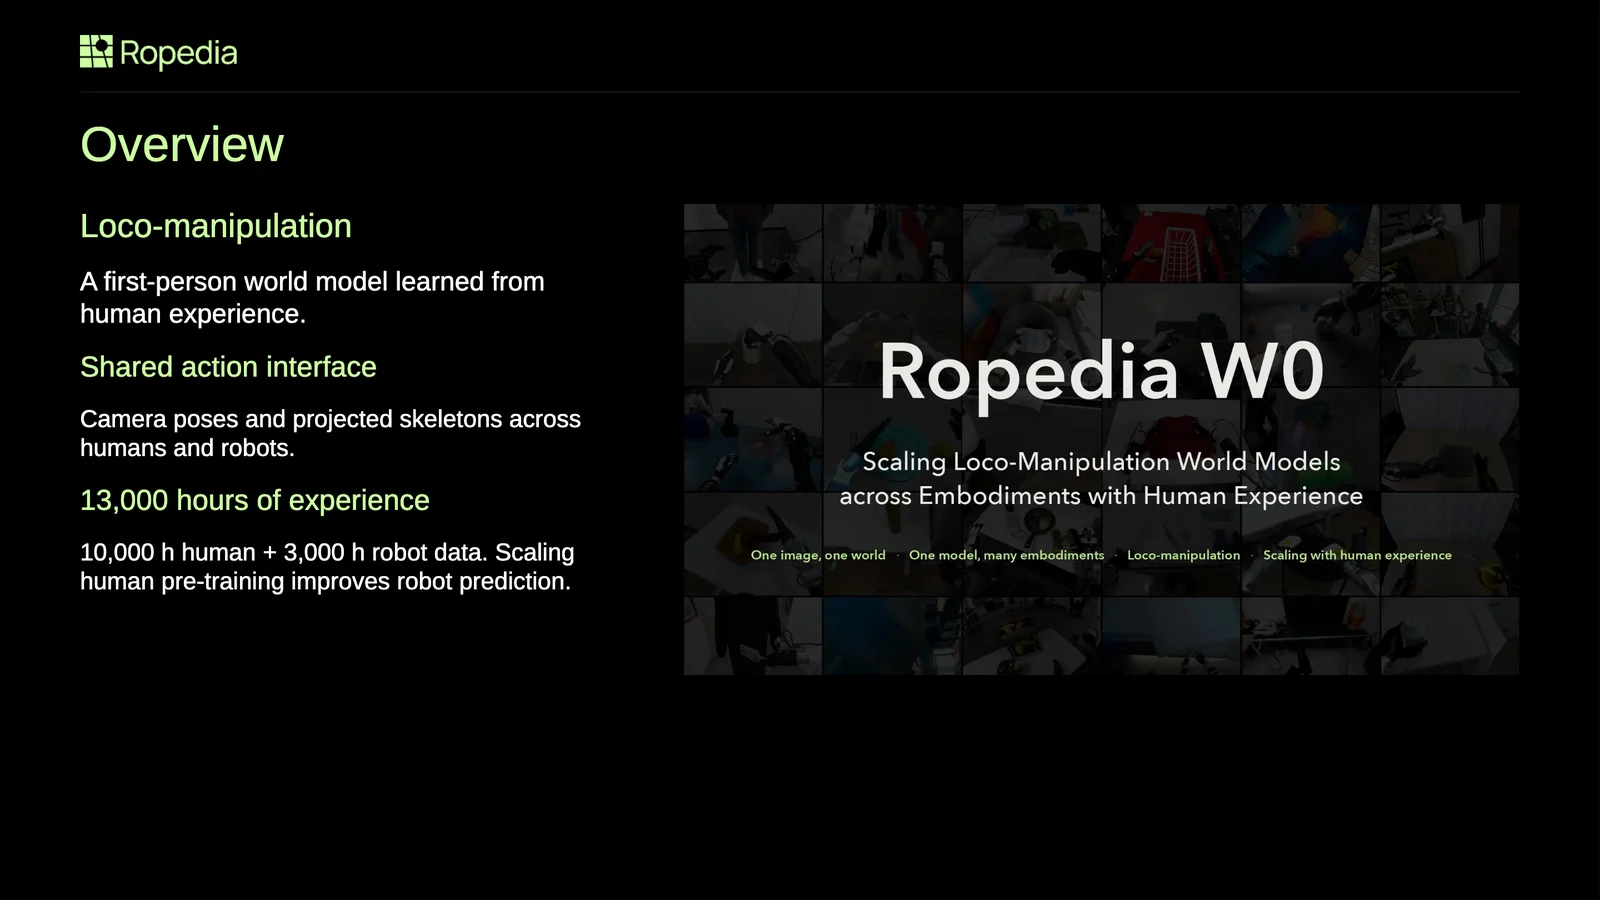
在正式展开之前,我先用一页让大家对我们工作有一个整体的印象。我们做的 Ropedia W0 是第一人称视角的世界模型,给它当前看到的画面,然后告诉它接下来身体要怎么动,我们的模型可以预测接下来会看到什么。它主要有三个特点。
第一个特点是 Loco-manipulation,它可以同时去处理机器人的移动和操作,不局限于在桌面上操作一些物体,就类似于人一样,人可以边走路边做事情,我们希望机器人也能够做到这么一个特点。
第二个是我们用了一个 Shared action interface,人和各种机器人,包括机械臂或者人形机器人,不管是末端执行器是 gripper 夹爪还是灵巧手,都共用同一套动作接口。共用同一套动作接口的好处是,不同本体之间的 knowledge 信息可以实时共享。具体这个接口,我们使用的是相机位姿,加上投影的骨架。
第三个特点是我们用了大规模的人类还有机器人数据来训了一个 world model,主要是从人类经验中去学习,一共是用了大概 13000 个小时的数据量,其中 10000 小时是人类的第一人称视角视频。我们发现,随着人类数据越来越多,我们模型在机器人上的预测也会表现得越来越好,就说明 human 的一些信息可以比较好地 transfer 到不同的机器人本体上。
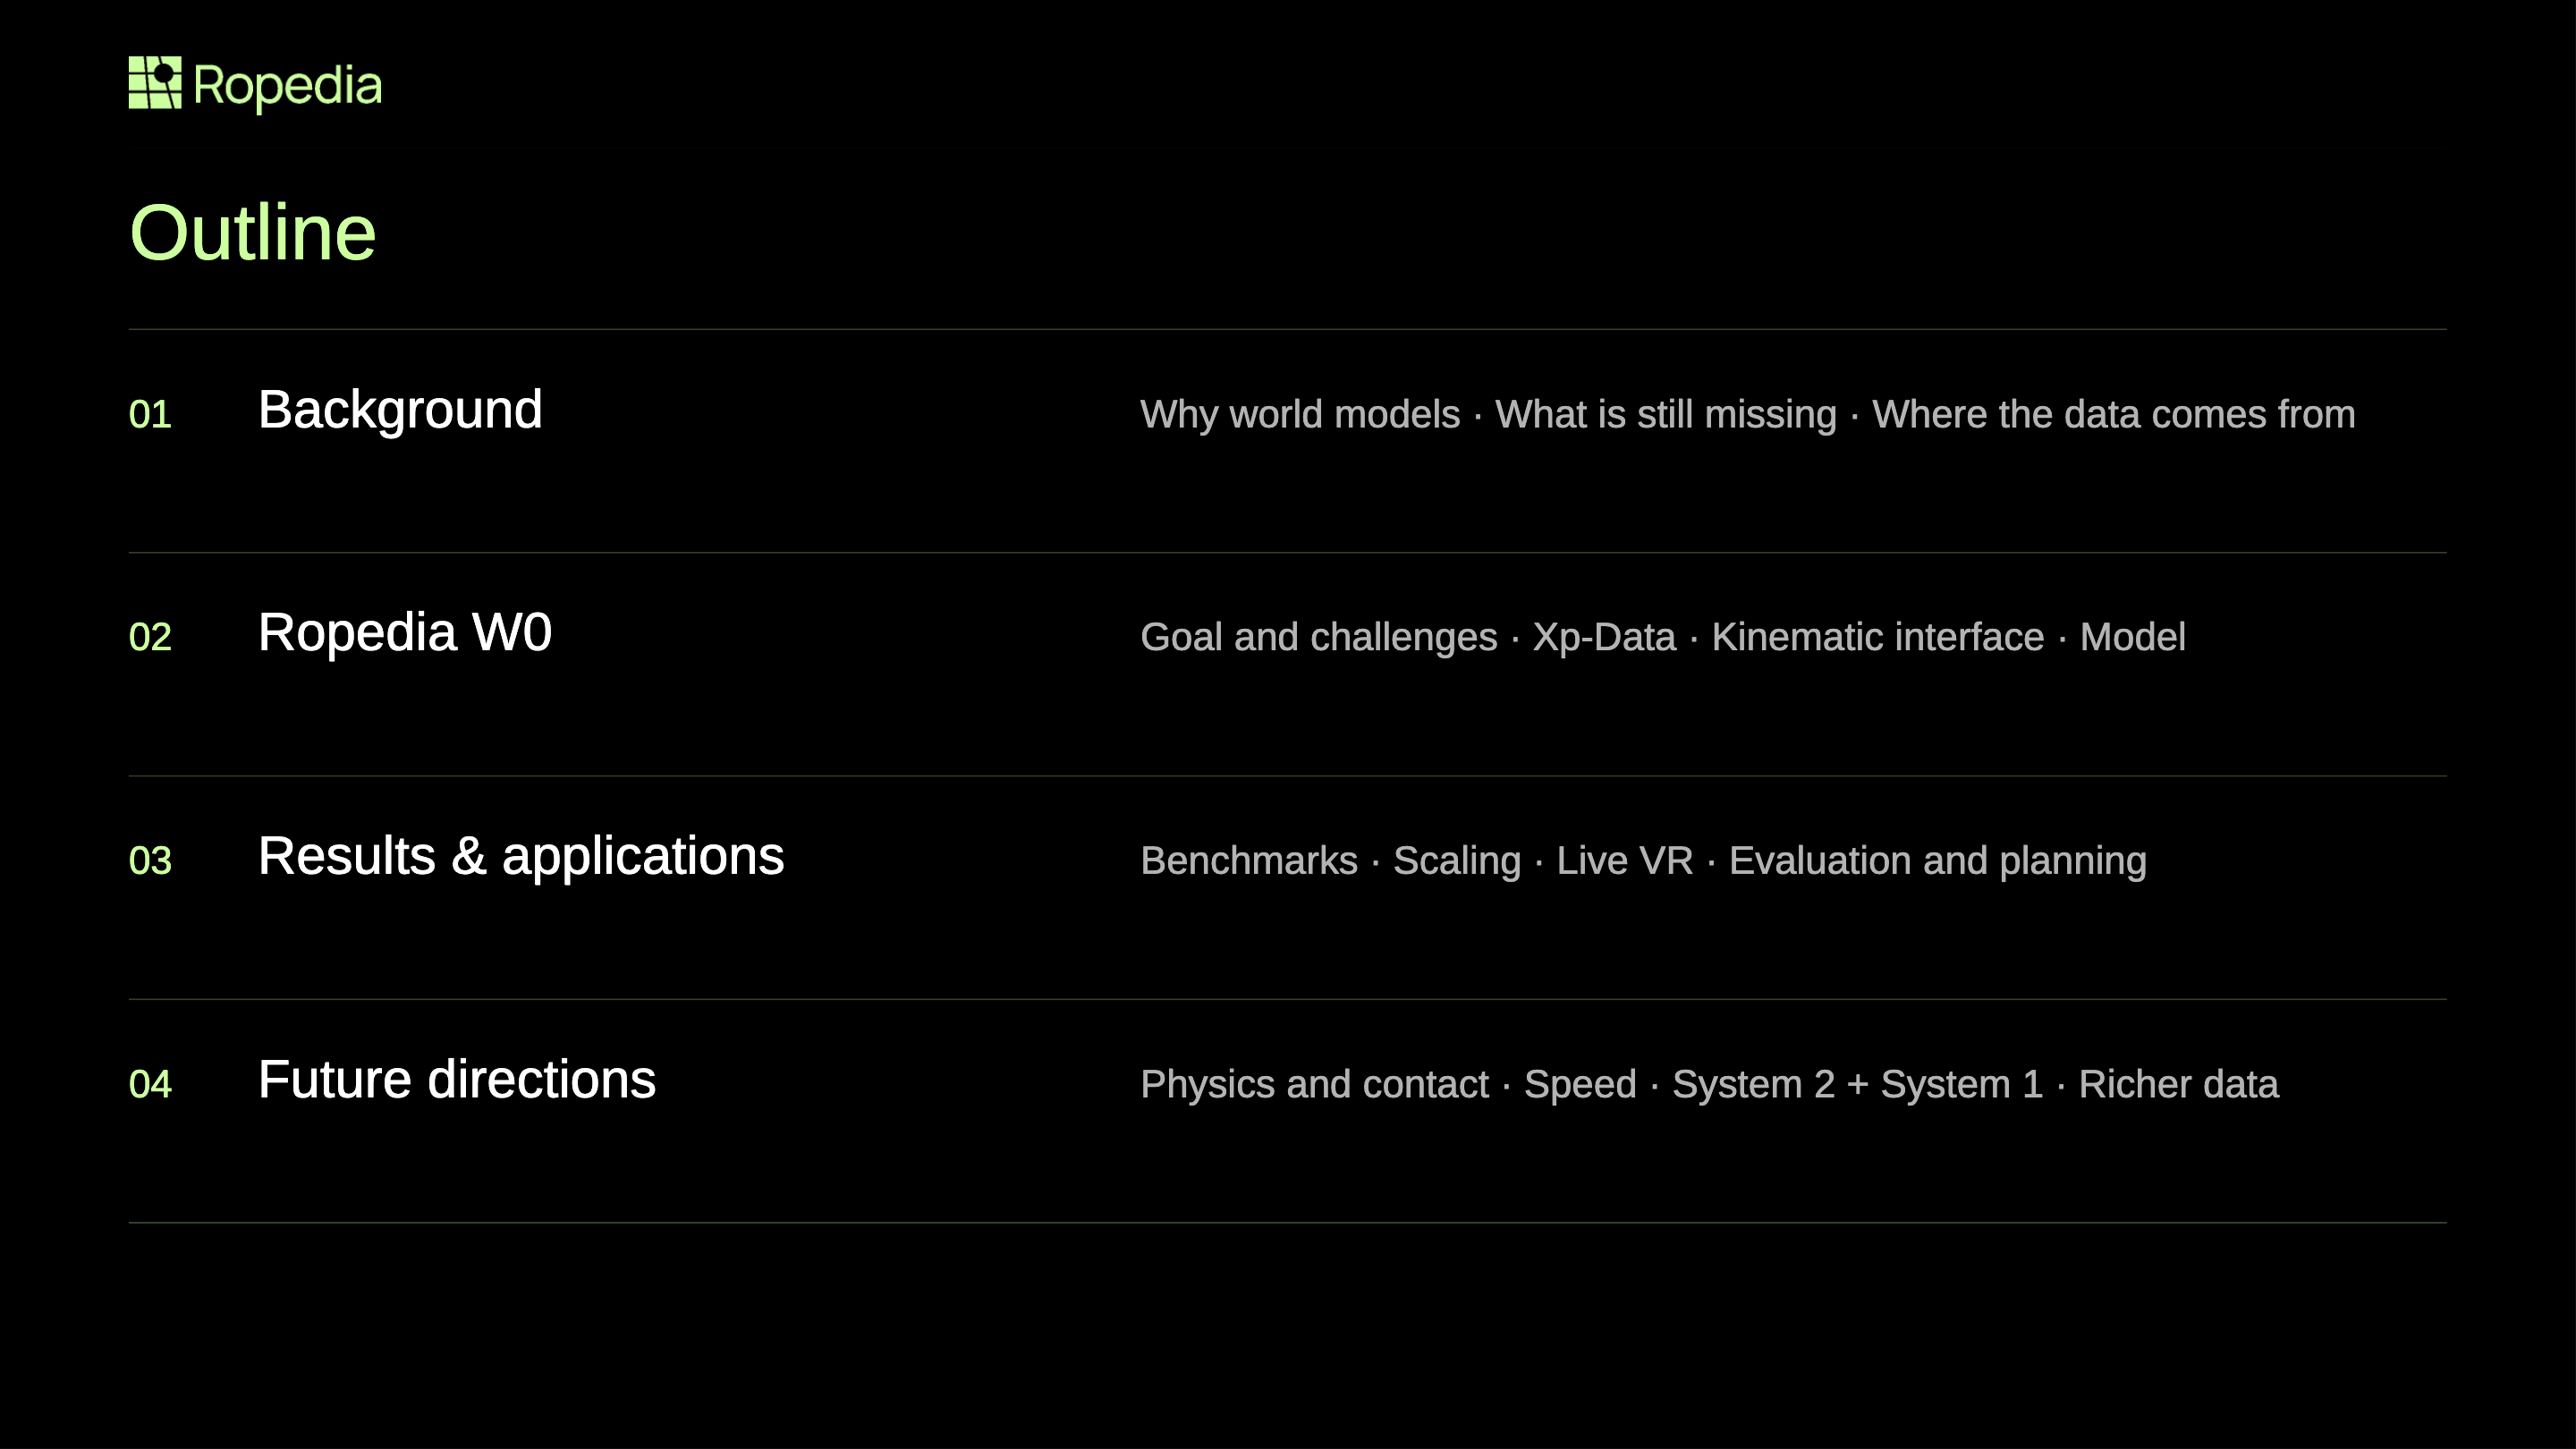
今天的分享大概分为以下四个方面。在第一部分,先简单讲一下背景,主要是机器人为什么需要 world model,以及现有的工作简单介绍一下,例如他们做了哪些事情、哪些事情他们还没有做得很好,要训这么一个世界模型需要哪些数据。
第二部分再进入到我们这个具身世界模型 Ropedia W0 本身的介绍,主要包括我们想做一个什么样的模型,然后会遇到哪些挑战,以及对于这些挑战我们是去怎么解决的,主要是在数据还有动作表征以及模型上分别做了什么事情。
第三部分主要看一下我们工作的一些结果、一些性能,包括它的一些下游应用,主要是一些实时的 VR 操作以及世界模型对于机器人操作的一些应用和帮助。
最后一部分可能和大家聊一下我们的下一步,或者说接下来这个方向还有什么值得关注的地方。
一、背景:机器人为什么需要世界模型
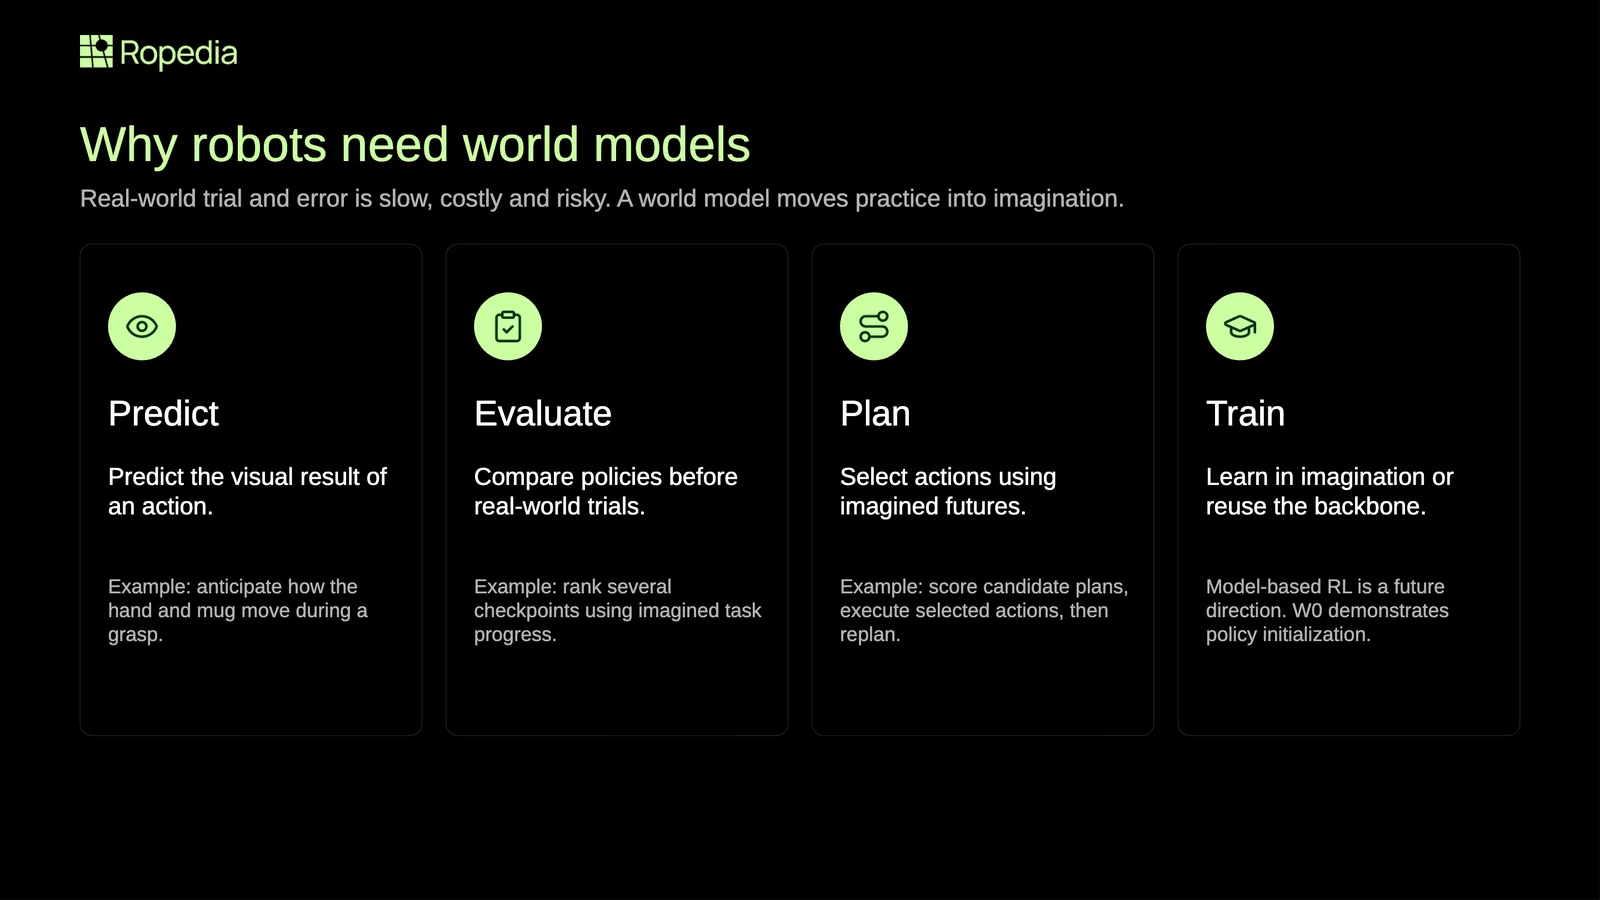
首先,机器人为什么需要一个 world model?
大家都知道机器人学习很多时候是要靠试错,但是在真实的我们的世界中,试错是又慢又贵,还有风险,东西会坏,然后场景也要人去复位,一次也只能尝试一种做法。我们世界模型想要做的就是把这部分机器人在真实世界中的练习给搬到模型里面,搬到模型的想象里面去。我们的 world model 大概可以起四个作用。
第一个是预测,机器人在动手之前,它就能够想象到未来的结果。比如我伸手去拿杯子之前,我们人可以大概有这么一个想象,先看看手和杯子会怎么动,根据想象的结果,然后再去规划具体的动作执行。
第二个是评测。具身世界模型可以让机器人不上真机,就能够在模型内部进行一些 policy 策略的评估,这会对机器人不同 policy、不同策略评价有非常大的帮助,因为不需要上真机,就可以知道哪个策略更好。
第三点是规划。在世界模型的想象中,我们可以去尝试不同的方案、不同的策略,我们只执行最好的策略,然后交给真机,让真机去执行。
第四点是训练,可以分为两个角度。第一个是由于世界模型对物理世界的建模,所以机器人不需要在真实环境中去做一些试错、做一些 RL 强化学习,它可以在我们 world model 里面去做一些强化学习。第二点就是说,咱们 world model 也可以作为类似于 base backbone,最近也比较多人做这个 world action model,叫世界动作模型,咱们的 world model 也是给世界动作模型提供了一个类似于 base model,它可以在我们视觉模型上接一个 action expert 去实现世界动作模型的构建和训练。
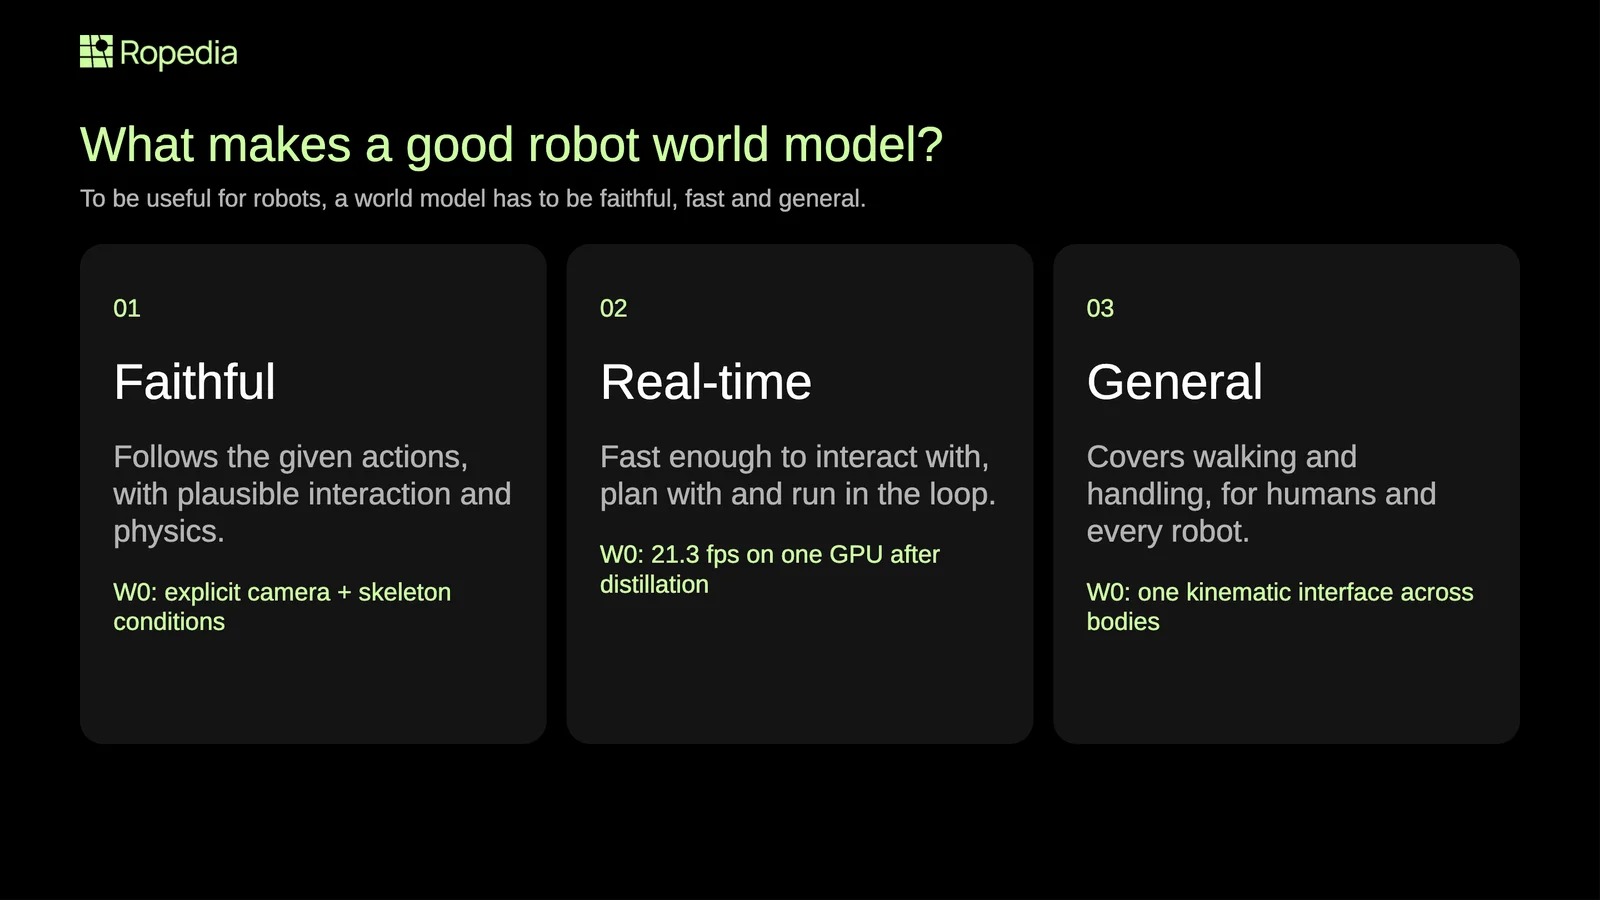
我们知道世界模型对机器人的帮助之后,怎么样才算一个比较好的具身世界模型?对于这个问题,我觉得至少要做到以下三点。
第一点是逼真。逼真可能不单单指的是视频生成出来像素画质要好看,而是生成的画面要严格跟着我们给定的动作去走,它的交互和物理要做得比较合理才行,不单单追求画面的质量,更在乎的是它能不能跟着我们给定的动作走,具体交互的时候能不能有一个比较好的效果。
第二点是速度。现在的 world model,主要是这种 video world model,生成的速度还是一个比较大的问题,由于它们是基于 diffusion 扩散模型的架构,需要多步去噪才能得到最后的视频,速度也是 world model 非常关注的一个部分。因为 world model 对具身的一个非常大的作用,是用来给具身在模型想象内部做交互、做规划,它的最终作用是要放进闭环里去用的,它需要做到实时可能才对具身有更好更大的帮助。
第三点可能就是它的泛化性、通用性。通用的话,我从两个角度来说明。第一个,从任务角度,现在大部分世界模型或者说具身的相关工作还是主要关注在这种 tabletop,它固定在桌面上去操作一些物体。不管是包括人形机器人还是机械臂,我们希望机器人能够达到的效果是像人一样,它可以在比如说干家务活的时候在房间内走动,可能还边走边干活,类似于这种效果。第一个它的通用性指的是它可以去同时做移动和操作两件事情,不单单局限于在桌面上去完成一些固定视角、固定机位的任务。然后第二个方面指的是它最好是能够跨本体的。现在大部分工作还是聚焦于一个固定的本体,因为现在机器人硬件也没有收敛,然后机器人也有特别多的种类,不管是机械臂还是轮臂、人形机器人,需要为每一个本体架构、不同本体型号去单独去训一个模型,代价是非常昂贵的,同时也不能把不同机器人对物理世界的交互的一些信息给共享。这个通用性主要包括两个方面,在我们 talk 里面,第一个是能够做到移动和操作两个事情,另外一个是能够做到跨本体的一些知识的共享。
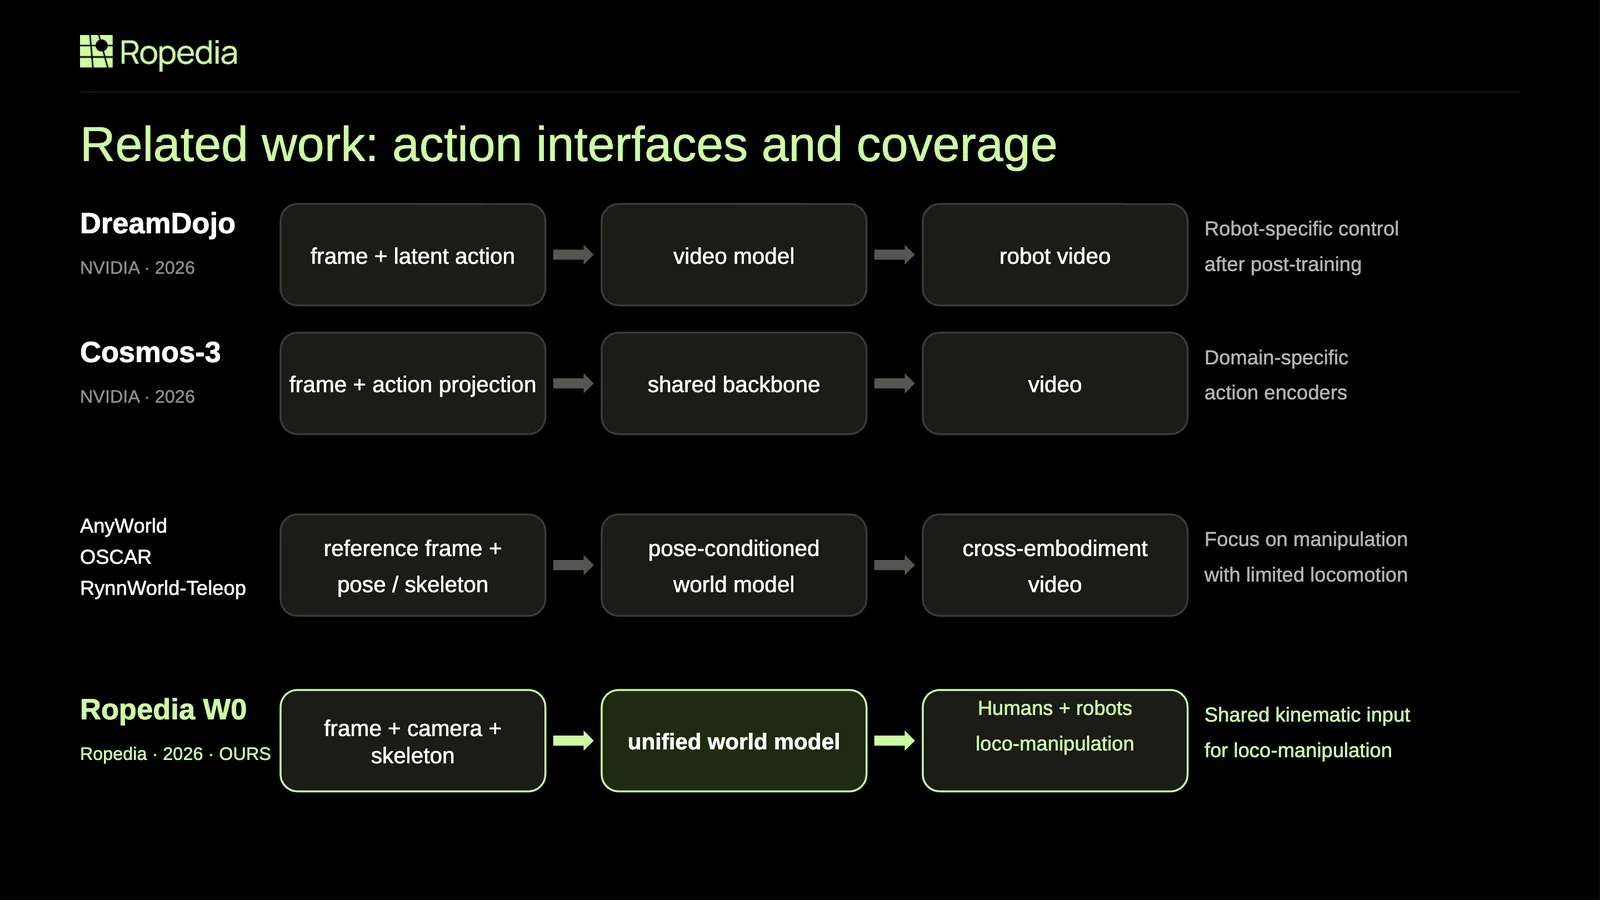
带着上面说的三点,我们来看一下最近的一些有代表性的工作。这里每一行代表的是从输入到输出的流程。英伟达的 DreamDojo,它是今年年初的一个工作,它相当于也是先用人类视频去做预训练,它对于人类视频的利用基本上只用人类的 RGB 视频,然后 action 的表征相当于是从人类视频中类似于前后两帧去提一个隐式的 latent 表征,然后后续到具体的机器人的部署上的时候,就会把机器人的 action 动作的关节角给通过一个 adapter 预训练学人类的动作的隐空间里面,然后再去做特定机器人的一些建模或者说预测。它的问题是人和机器人,或者说不同型号机器人,它不能直接用一个模型去解决,它不同机器人都需要一个单独 adapter,把不同型号机器人的动作空间给映射到一个预训练人见过的一个 action 的空间,它很难做到跨本体泛化。
然后第二个也是英伟达的,叫 Cosmos-3,这是他们的世界模型。他们当然是做了一个比较大的 scope 的工作,包括各种 understanding、generation 都做了,但是它里面也重点 focus 在 forward dynamics,可以理解为一个 world model,就给定一些 action,然后让模型能够预测出后面的一些视频结果。Cosmos 它是用了一个共享的主干网络,它还是需要对每个不同的本体有自己的单独的 encoder 和 decoder,还是不能通过一个模型去 handle 不同的本体,虽然说主干网络是 share 的。
然后其他的一些工作,包括国内一些大厂的工作,AnyWorld、OSCAR 还有 RynnWorld-Teleop 他们的话,是用比较显式的动作表征,比如用手的骨架作为 condition 作为这种条件来生成预测后续的视频。他们还是主要局限在于 tabletop 的 manipulation,没有去考虑这种 loco-motion 带移动的交互。
咱们这个工作就围绕我们之前说的两点,第一个是跨本体泛化,第二个是同时建模移动和操作。基于之前的工作都没有做到这两点,咱们想做这么一件事情:做一个 unified world model,既能够做到不同本体,包括各种本体型号以及人和机器人之间的一个通用的模型,第二个是可以做 loco-motion 和 manipulation 两件事情。具体做法我们后面再讲。
既然咱们想做一个跨本体的移动和操作的世界模型,那为什么这两点会比较重要?我们先说 Loco-manipulation,就是移动和操作,因为我们机器人真正要派上用场,比如说帮忙去做家务,一定是一边走动一边拿东西的,只会去模拟桌面操作的世界模型在这种应用场景上是不够用的。然后第二个是说跨本体,如果每换一款机器人都要单独去训练一个模型,成本会非常高,不同本体不同身体之间学到的东西也没法共享。
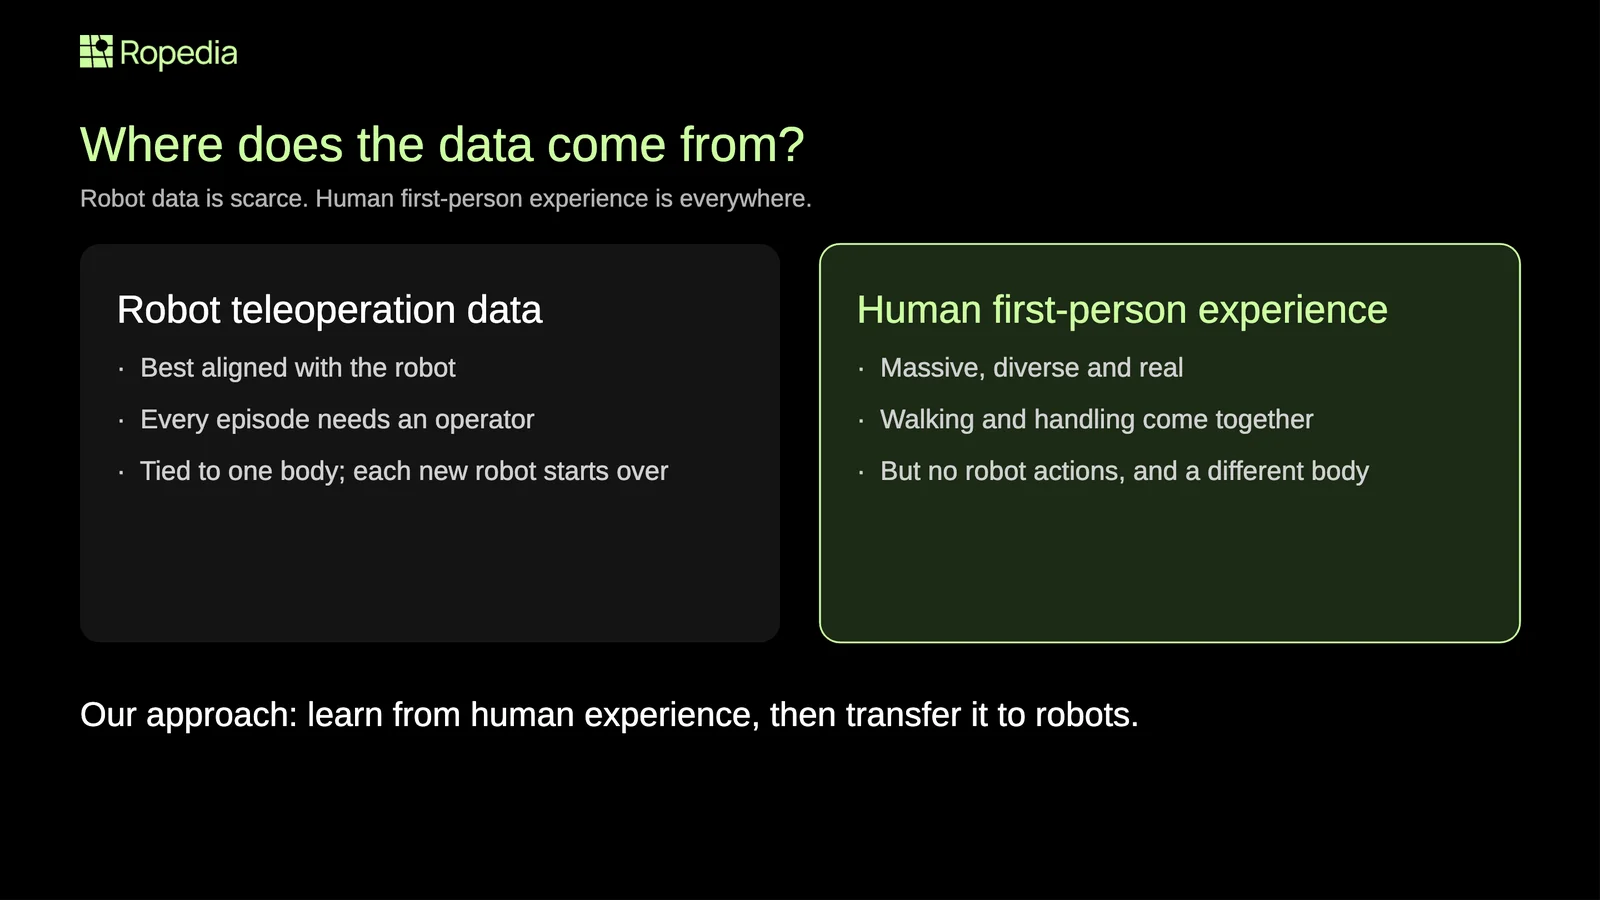
要训练这么一个模型,数据从哪里来?现在大家都知道这个模型深度学习都是数据驱动的,咱们这个也不例外。世界模型要做到多好,很大程度上取决于它见过什么样的数据。左边是机器人要操作的数据,它当然和机器人是最贴合的,然后质量也是最高的,但问题也很明显:每一条都需要人去遥操作来采集,它的成本就会很高,数量很难 scale up 上去,往往绑定在某一款具体的机器人本体上,如果你换一款机器人,可能得从头又遥操作来采集。右边的话是人类的第一人称的一些数据,就 human first person experience,它的量当然相对来说就会大很多,我们人在平时一些工作生活中的一些记录,然后它场景也会更加丰富,也足够真实,走动和操作是天然在一起的。它也有短板,第一是它没有机器人的 action 这种动作,人的身体和机器人差别当然也是相对比较大的。
咱们的思路是,我们先从人类的 experience、人类经验里面去学习,我们这个世界是怎么运转的、交互之后这个世界的状态是怎么变化的,这么一个规律,再把从人类数据中学到的知识给迁移到各种不同本体的机器人上面。
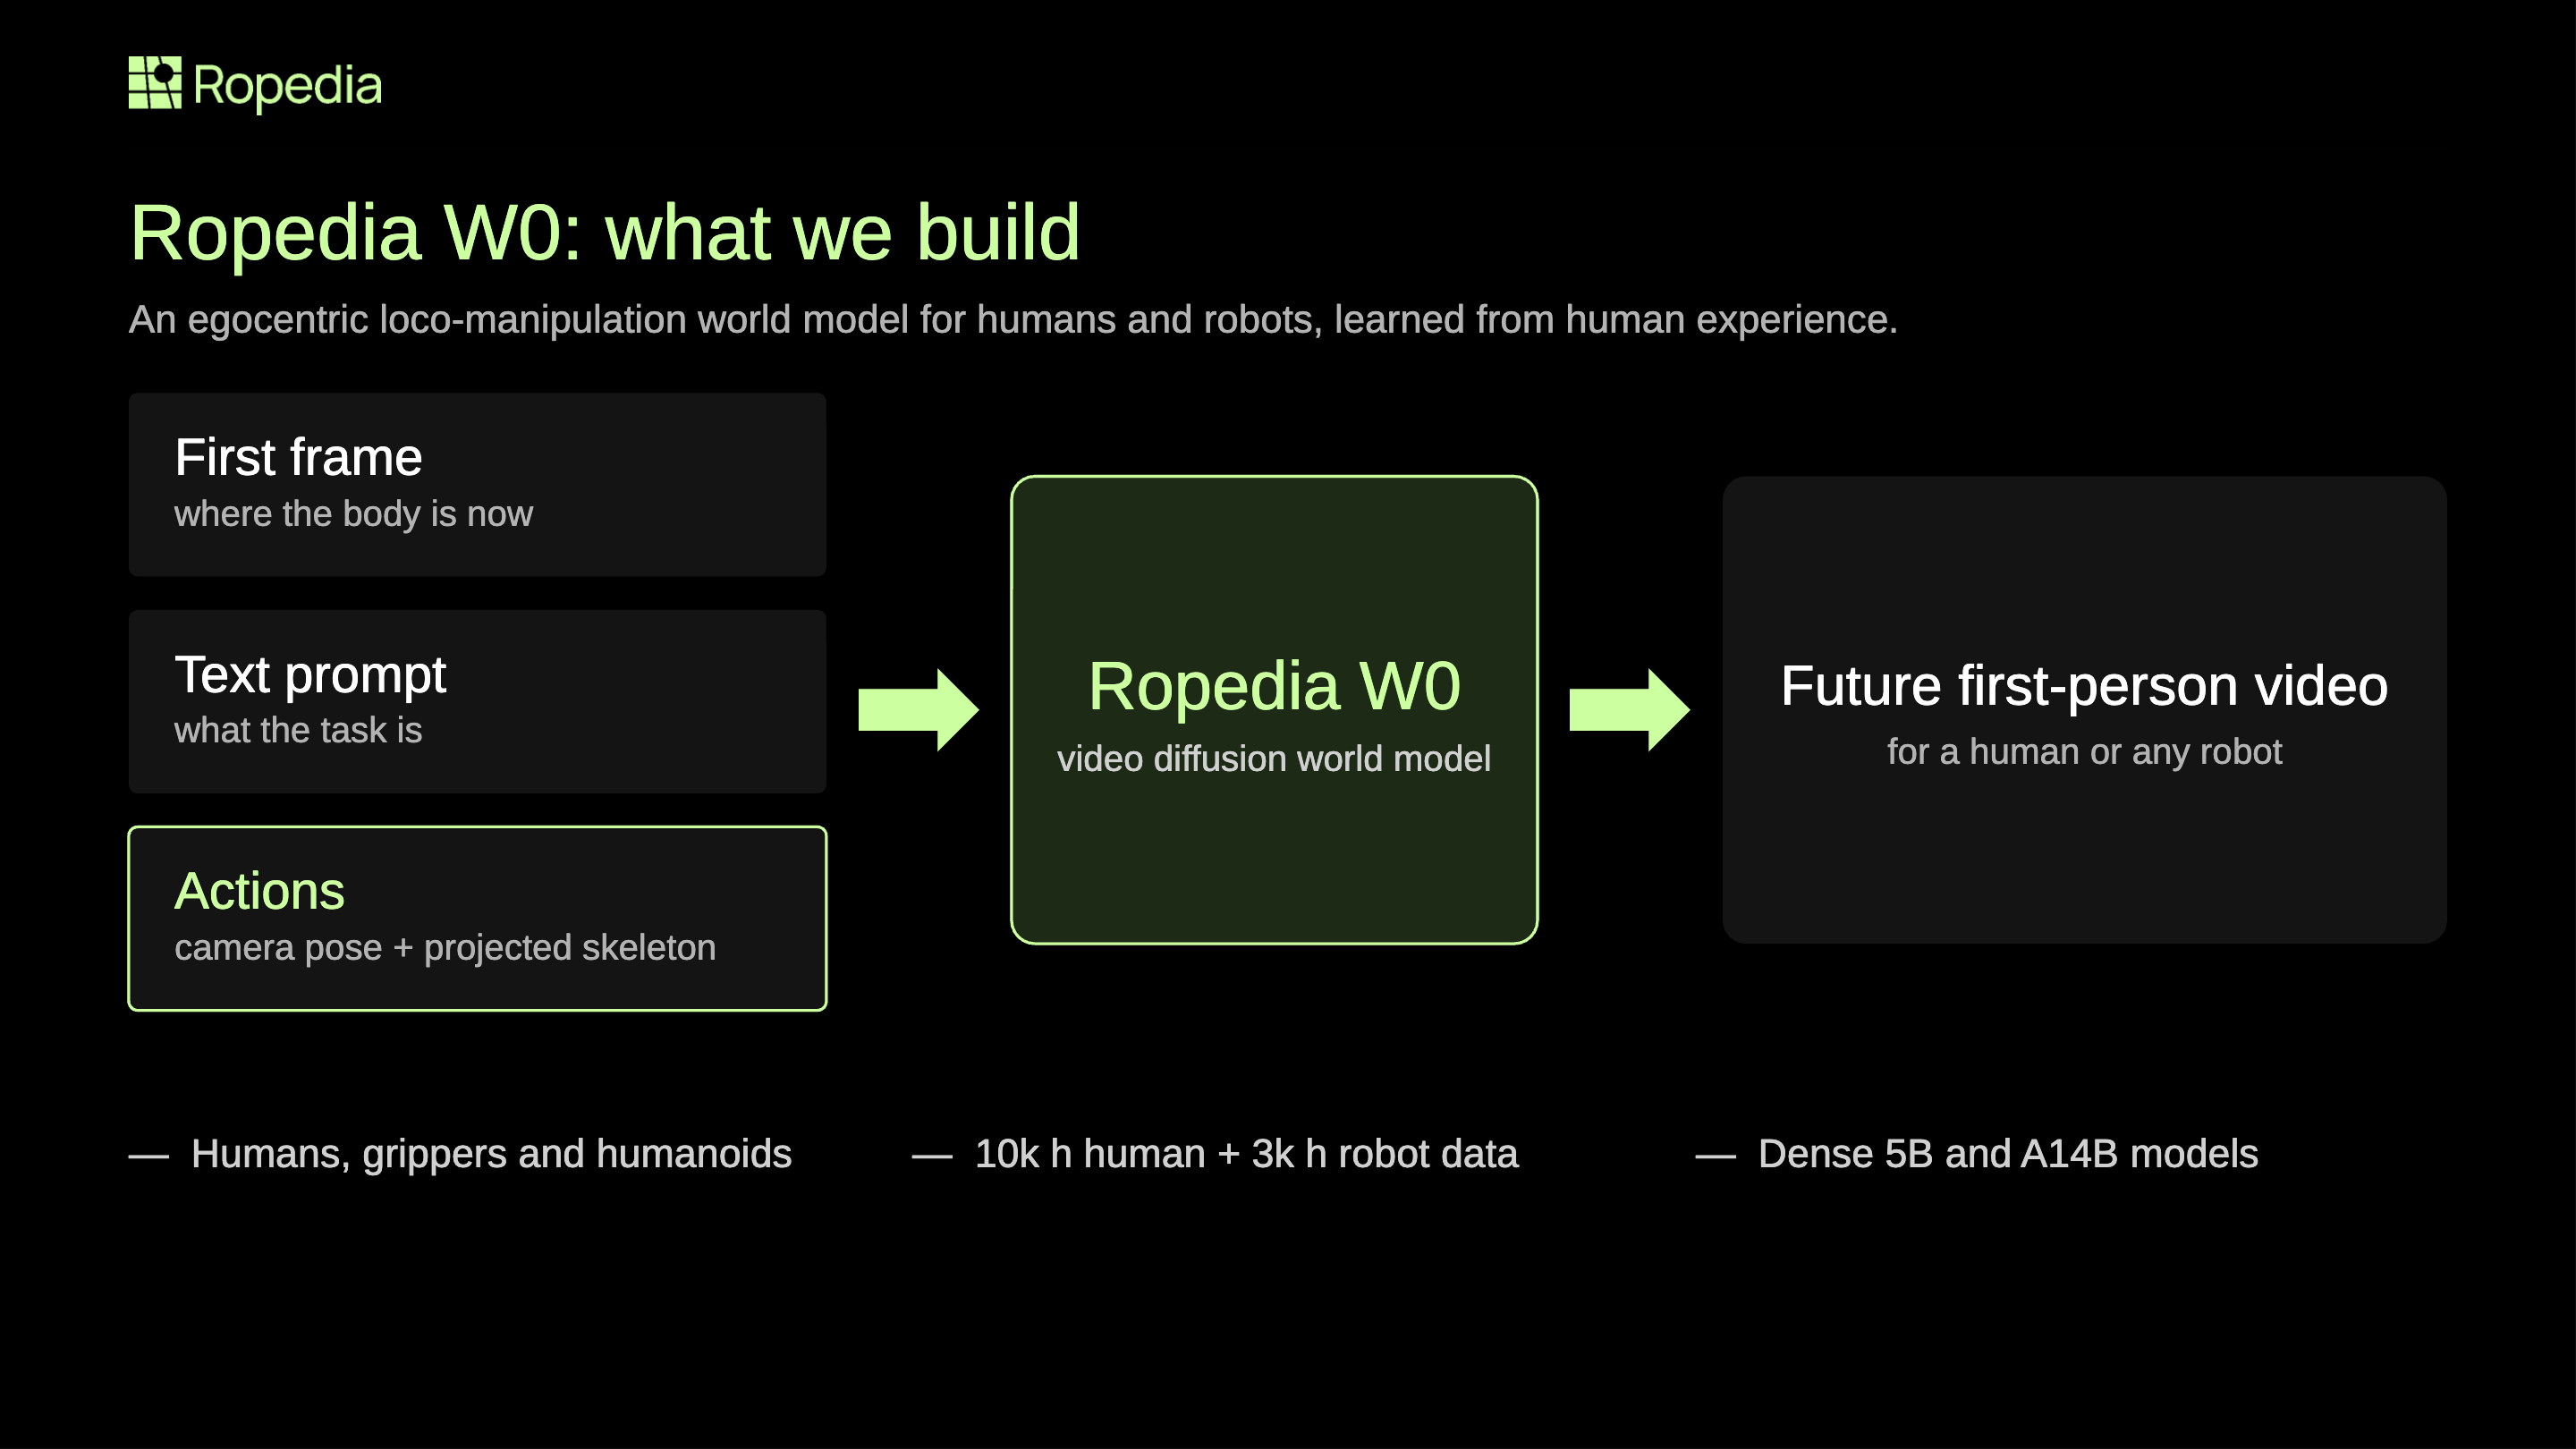
基于这个思路,我们做了具身世界模型 Ropedia W0。简单来说,它从人类第一人称视角数据中去学习到的移动操作的跨本体的世界模型,它同时适用于人和各种机器人,主要从人类经验中去学习。输入主要有三样,第一个是当前的观测以及一个任务的描述,想让它干什么,然后第三个就是它 action 的表征。当然这里 action 我们工作中是用 camera pose 和 skeleton 投影的骨架来表征的,然后输入到咱们这个 world model 里面,输出接下来第一人称视角的视频。
这个视频可以是人的,也可以是任何一款机器人的,所以说它涵盖了人、夹爪机械臂、灵巧手、人形机器人等各种本体形态。我们训练是用了 10000 小时的人类数据和 3000 小时的机器人数据。对模型尺寸方面,我们也做了两个不同尺寸的尝试,一个是 dense 的 5B 模型,还有是 A14B 的一个模型。大家可以把它理解为一个可以被动作驱动的视频的模拟器。
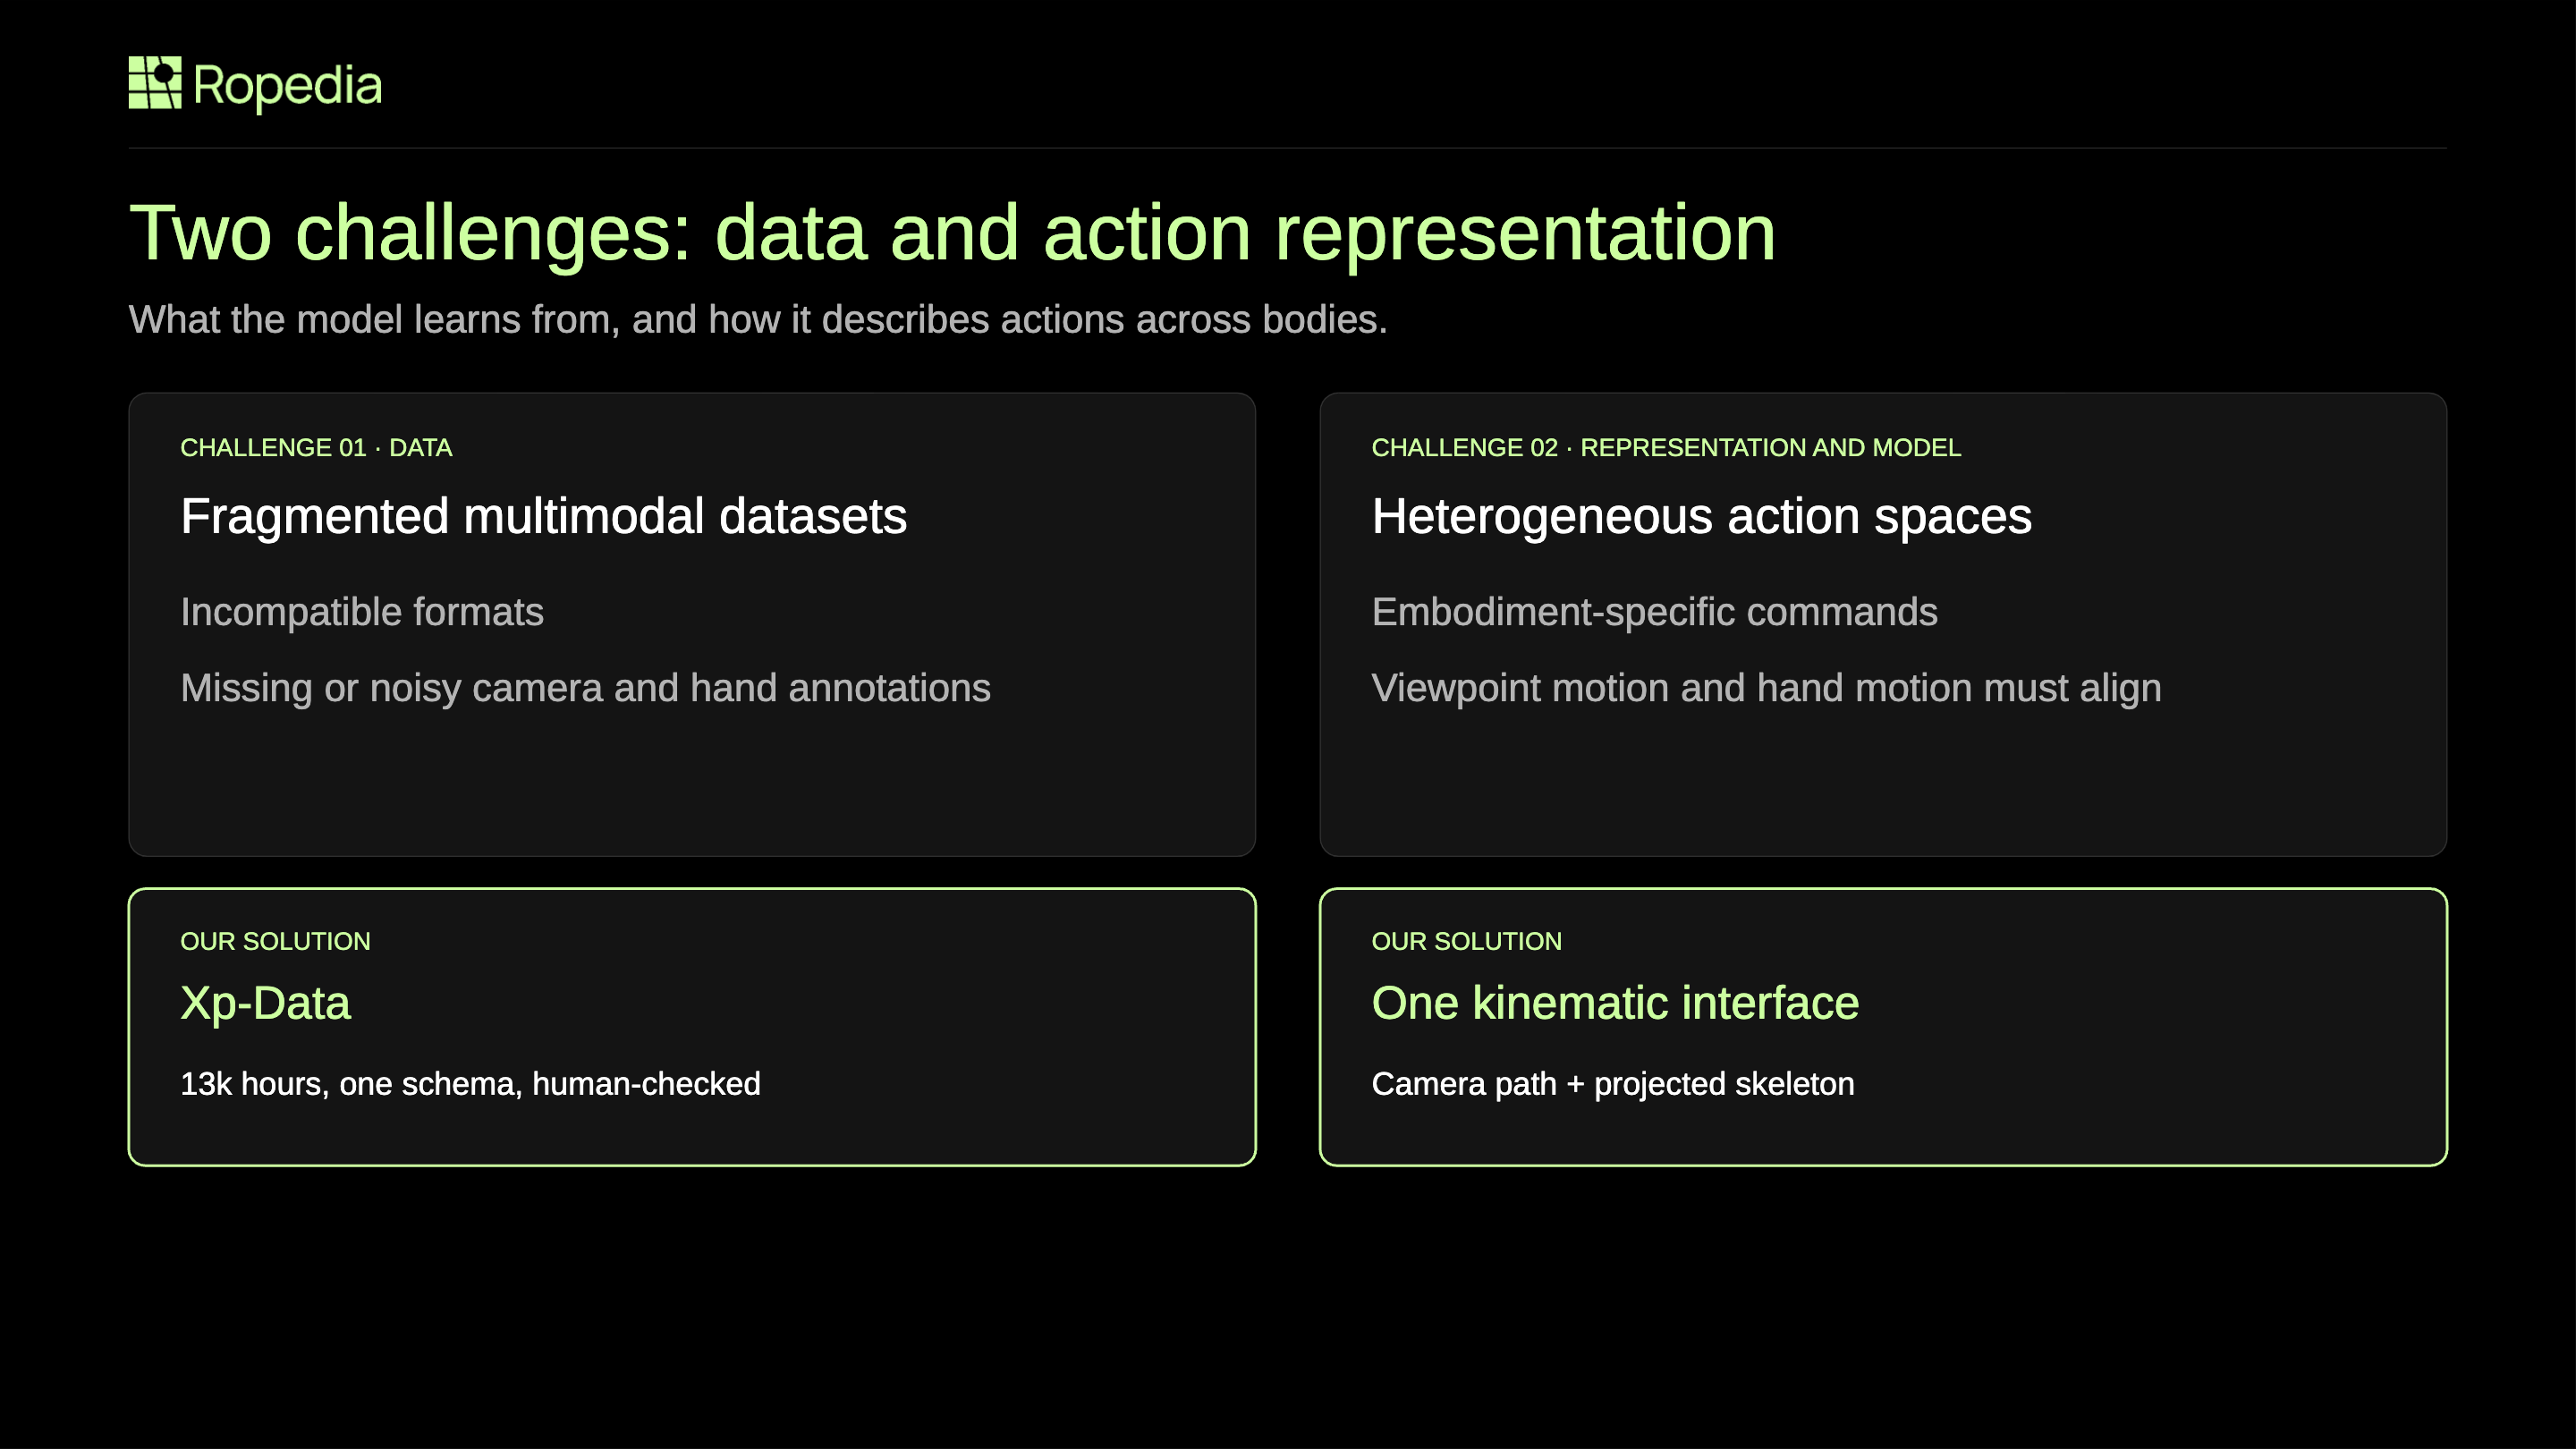
不过想把模型训好,有两个绕不开的难题。第一个难题是数据:现在并没有一个规模大、质量好、格式统一的人类加机器人的数据集。当然现在公开的数据集也有特别多,几十个,但是格式也是五花八门,大多数也缺少我们需要的相机轨迹和手部姿态的一些标注,或者说标注质量还不够好。所以我们的做法是构建了 Xp-Data,大约有 13000 小时,然后都会统一成一种格式,会经过算法以及人的一些严格质检来保证它的标注质量。
第二个难题,我们之前提到咱们想做一个移动加操作以及跨本体泛化的通用模型,那怎么去建模移动、怎么去建模操作、怎么样去做到跨本体,需要去设计好一个通用、适合泛化学习的动作表征。不同的身体控制指令完全不一样,而走路 loco-motion 带来的视角变化和手上的动作又需要放在同一种语言里描述。对此我们的做法是用一套统一的运动学接口,用相机轨迹去描述身体移动后会造成什么、会看到什么样的视角下的世界,然后用投影骨架去描述手是怎么操作、是在做什么。
二、数据:Xp-Data 的构建
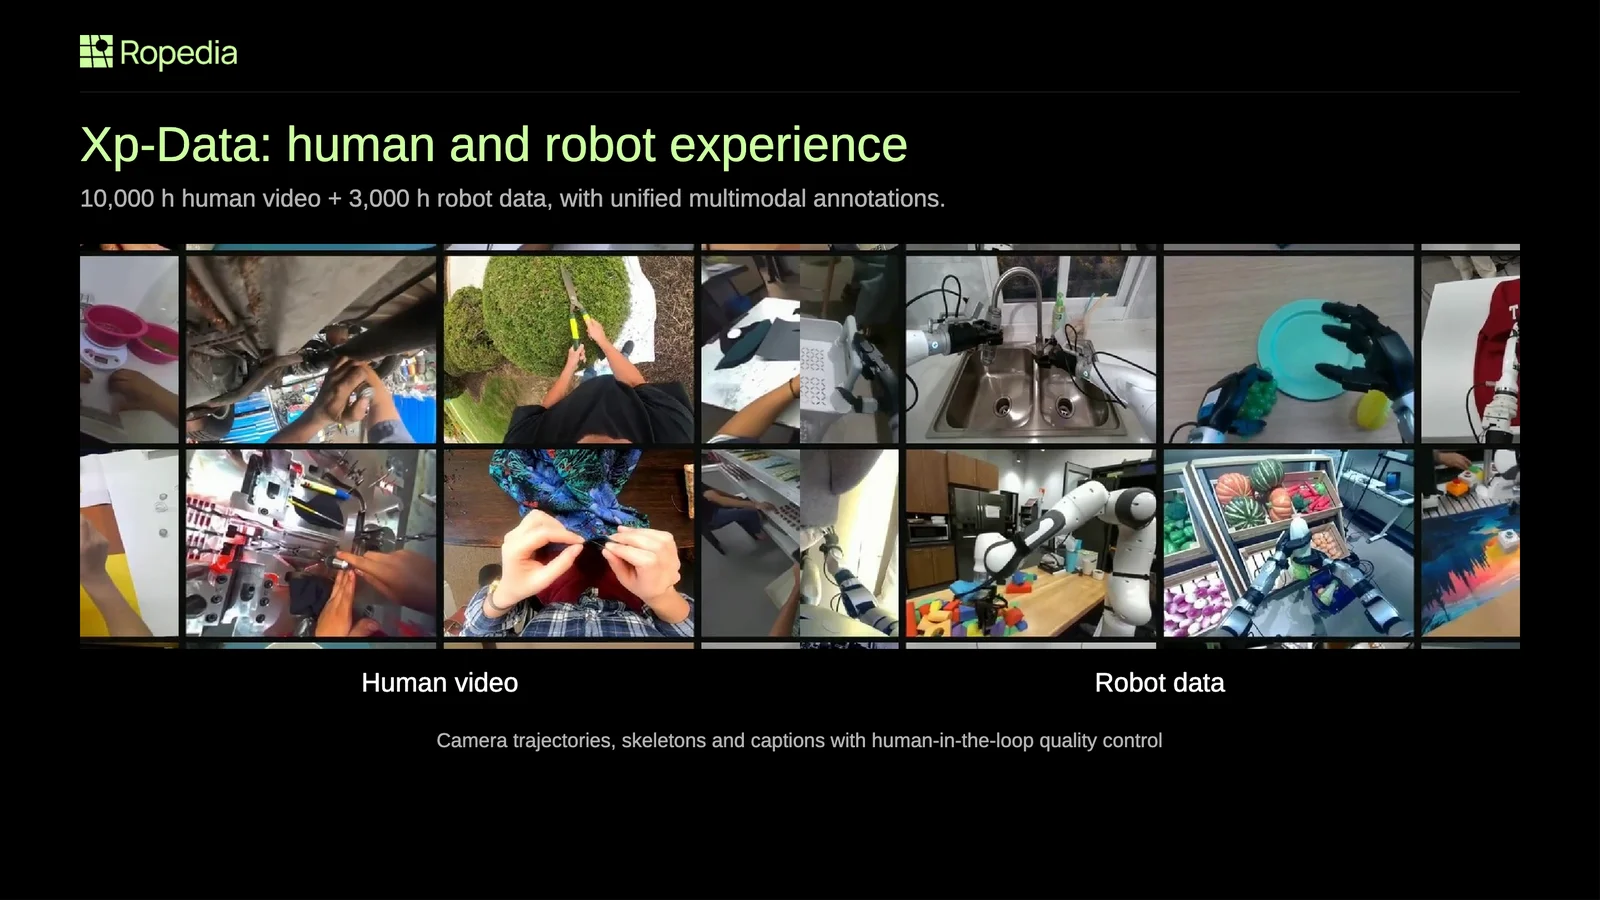
然后接下来可能就对这两个问题一个一个去讲。我们先说数据。这是我们构建的 Xp-Data,大约 10000 小时的人类第一人称视频,加上 3000 小时的机器人数据。人类数据一部分来自于我们重新标注的大概 14 个公开数据集,也有超过六成,就是大概六千多个小时,是我们自己去采集的第一人称视角的视频。这 10000 小时指的是我们经过各种质检后留下来的数据量,因为我们会经过比较严格的算法和人工的过滤,最后留下来大概 10000 小时的 human data。然后对于机器人,我们也是找了各种公开的、包括我们可以访问的各种数据来源来构建的一个数据集,同样也会经过我们格式的统一和严格的质检,最后留下大概 3000 小时的各种不同本体、不同来源的 robot data。然后不管来源是什么,每一段数据都会带有我们想要的标注,有相机轨迹、手或者说机械臂的一些骨架,包括任务的文字描述,都会统一成同一种格式。
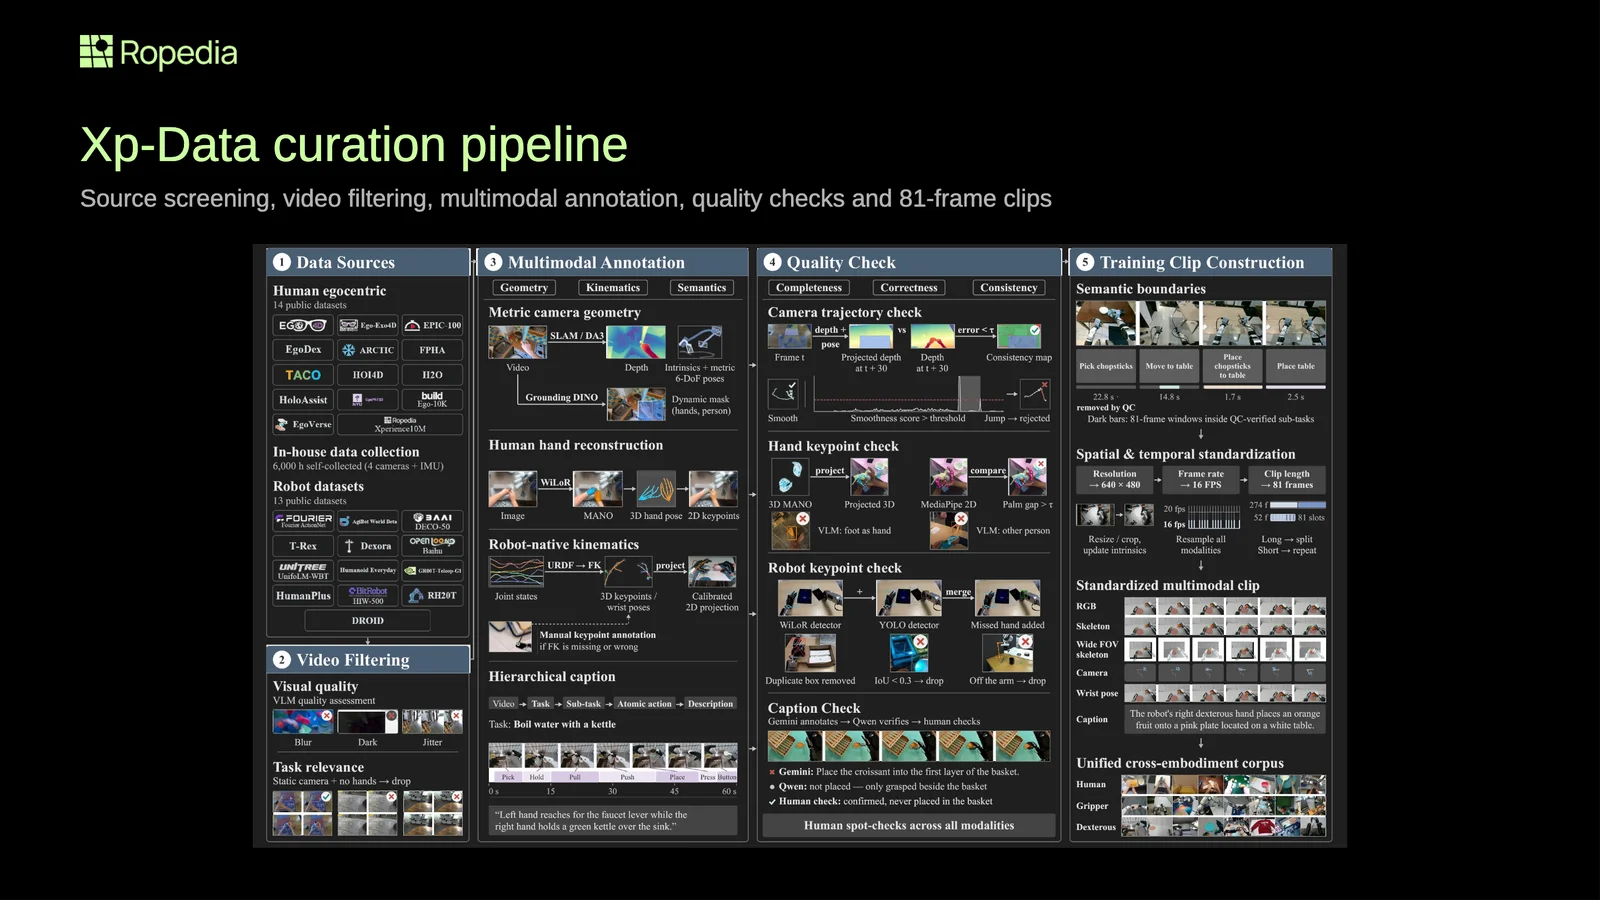
接下来我们可以看一下我们数据的具体 pipeline。整个流程大概分五步。
第一步收集数据源,主要包括各种公开的数据集,不管是人类的数据集还是机器人的数据集,我们尽可能去互联网上找了能收集到的各种数据集,然后同时我们也会自己带采集设备去各种 diverse 的场景里面去采集各种 diverse 的 task。大概我们自己采集了 6000 多个小时,最后留下 6000 多个小时。
第二步是做一个预筛选。我们采集的各种,不管是我们采集还是别的数据集提供的,原数据都会有一些不太符合要求、质量不太高的原数据,比如说我们会把那些画质很模糊、然后灯光很暗、然后晃得特别厉害,以及或者说在某一个片段、某一段视频里面,他的手根本没有去做事情、没有对 world model 训练没有太大意义的视频给去掉。
第三步就是做多模态的标注,也主要包括我们之前提到的我们想要的几种模态。第一个是 3D 的标注,包括相机几何深度的一些标注,然后第二个是手的 skeleton。对于人,我们就用现有的 MANO 检测算法去得到手的标注;对于机器人的话,由于机器人的运动学决定了它可以通过正向运动学去拿到它的末端执行器,或者说它整个身体在 3D 空间中的坐标,所以这对于机器人的 skeleton,我们可以直接拿到的。想要把它 3D 的 skeleton 给投影到 pixel-align 的 2D 的图像中,我们还需要去拿到相机相对于机器人基座的内外参。然后内外参是现在大部分公开数据集并没有提供的,因为它需要去做手眼标定,如果你直接去用对应型号对应机器人型号官网上的内外参去投的话,一般是不准的。对于这个问题,我们也是人工去自己标注了很多,然后为每个数据集去反向去推导和优化出它标定应该会得到的内外参,这个部分是我们花了很多时间去解决的。除了所谓的 skeleton 以外,还有这种文本描述。对于文本描述,caption,我们也做了一些不同粒度的文本描述,就包括 task、subtask,还有 dense 的 description。
然后第四步主要是做一些 quality check,做一些质检。前面我们用模型也好、用 human in the loop 的标注也好,标完之后,我们需要对标注质量进行一些检查。我们对于 QC 就是质检也设计了为每一个模态设计自己单独的一些 QC 的算法,同时我们也会去 human in the loop 去反馈、去重点检查一些容易出错的地方。在保证了标注质量过关的情况下,我们再把对应的可以用到的片段或者视频给它们切成统一可以用于训练的 format。
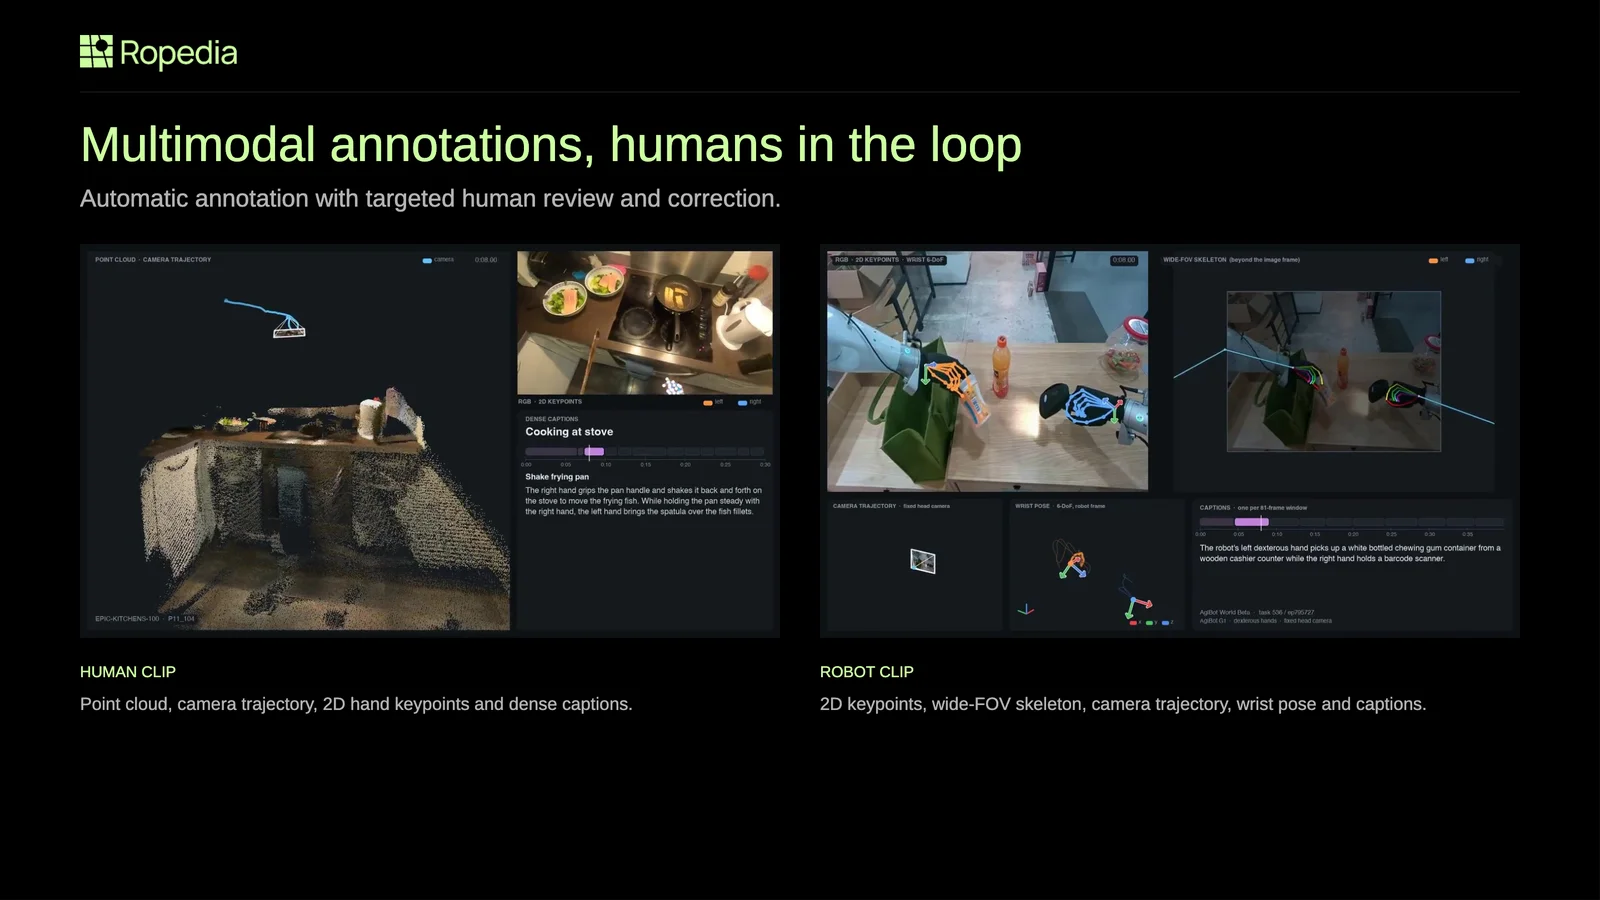
这一页可以大概看一下我们标注出来大概是什么样子。左边展示的是一个人类的数据的例子,我们的标注有这种场景的三维点云、相机在场景中走过的轨迹以及手部关键点,还有标系的文本描述。右边就是机器人数据部分,它也有这种关键点,由于它是关键点可以通过 FK 去直接拿到的,它不单单画面内有这种 skeleton,画面外我们也是可以拿到的,我们可以拿到它更加广视角下的骨架,同时它也有相机轨迹、手腕的位姿和文本的描述。可以看到人和机器人的数据都会被整理成同一种形式。
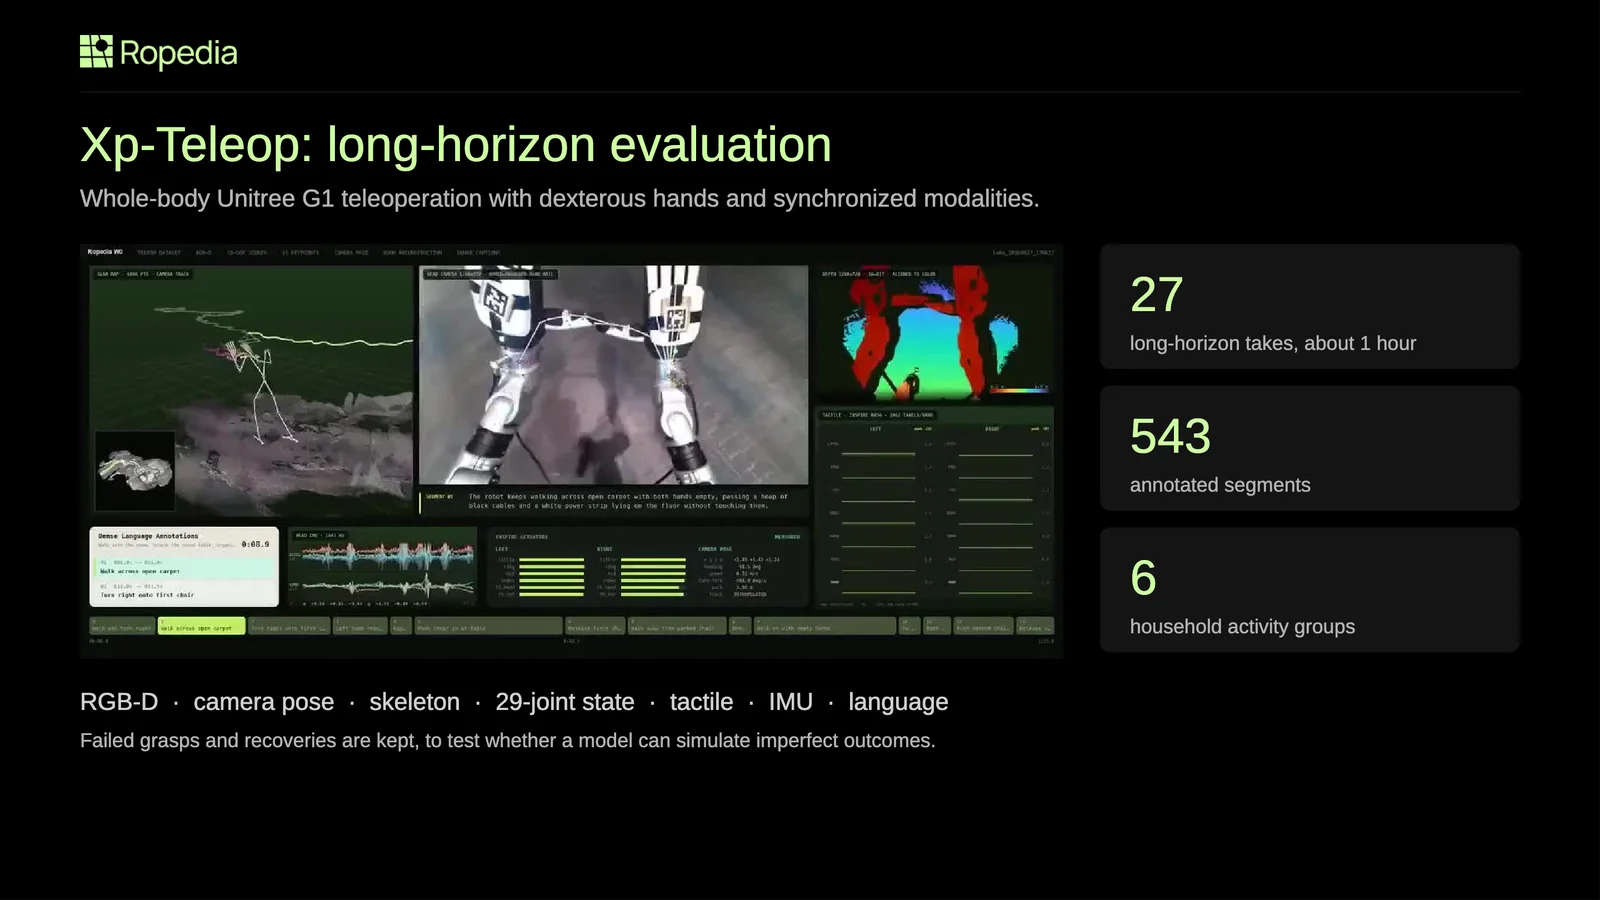
除了之前提到的用的训练数据之外,我们做了评测的基准,叫 Xp-Teleop。我们用遥操作对宇树 G1 和两只因时灵巧手,然后通过全身遥操作来采集了大概一个小时的评测数据量。它同一段视频里面既有 loco-motion 走动,然后又会有一些比较灵巧的一些操作。它一共有 27 段长程的数据,人工我们人工给它标注了 543 个片段,然后覆盖六类家务活动,模态也是特别全,有 RGB,还有深度,还有相机位姿骨架,每个关节的状态、触觉、IMU 和 caption 这种文本描述。当然我们在做 benchmark 的时候还特意保留了失败的抓取,它面对失败后后面恢复的过程,就用来去评测我们的世界模型到底能不能模拟出没抓住,或者说我开始没抓住、后面才抓住这么一种对于模型来说可能不是一次性特别完美、在现实中确实非常真实的情况。数据部分大概可能就讲到这里。
三、动作表征:统一运动学接口
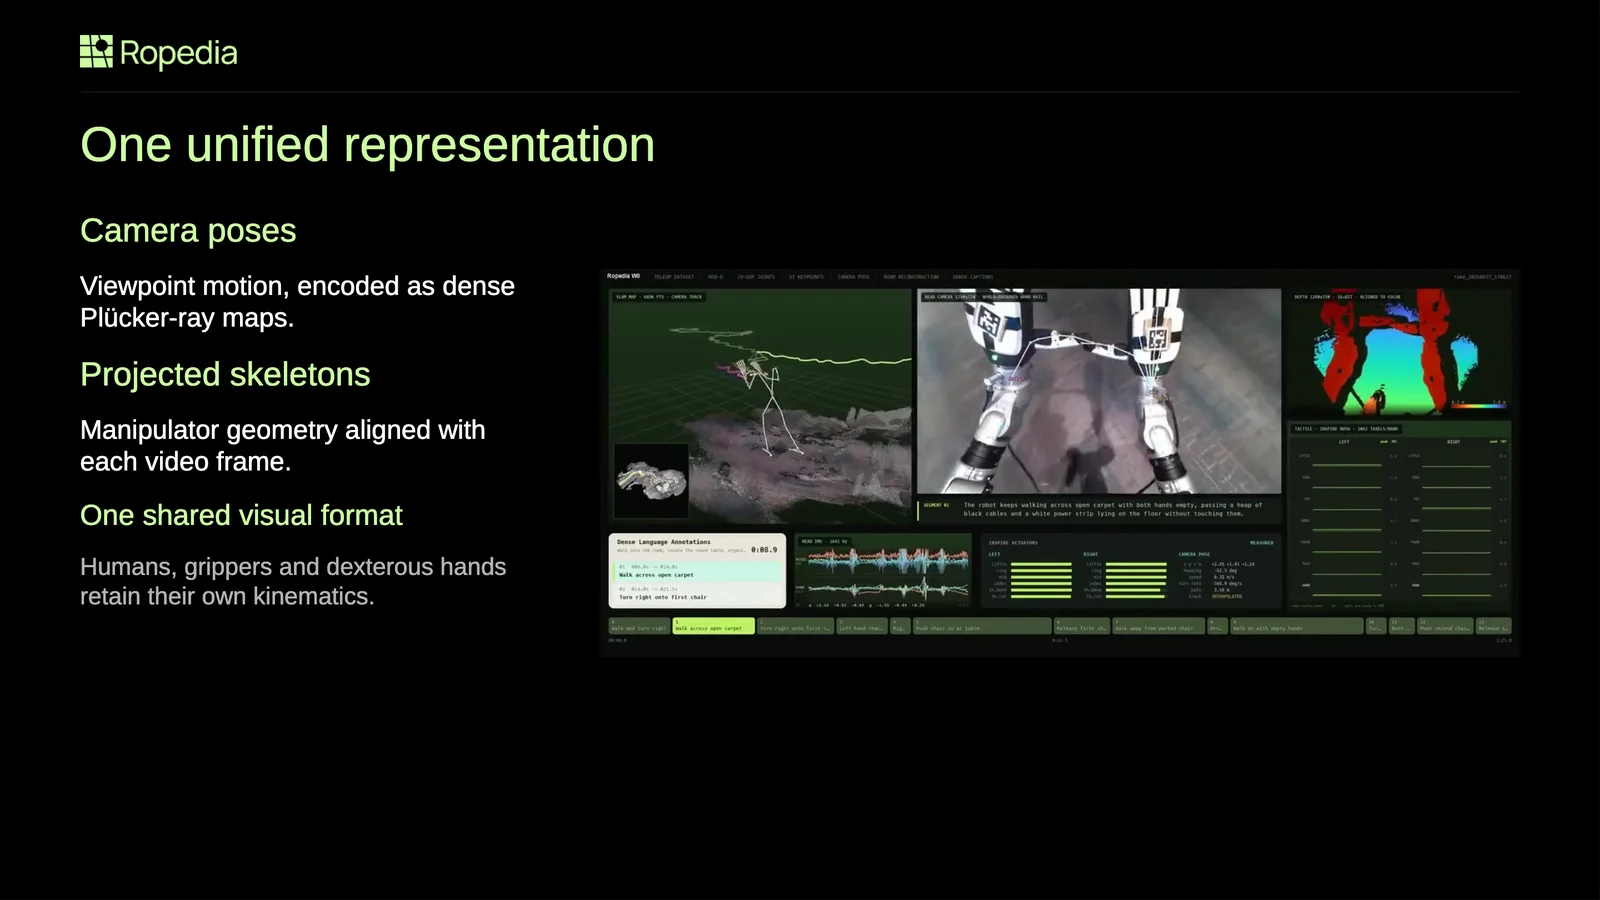
接下来可能是我去说一下我们前面说的第二个 challenge。咱们想要做的跨本体泛化,但是不同机器人、然后人和机器人它们身体也都是各不相同的,那动作怎么去统一表示?我们的答案就是用两种信号来表征。
第一个是用 camera pose 来表征 loco-motion,我们会去描述身体会怎么移动,然后看向哪里。我们具体会把它编码成比较稠密的 Plücker 射线图。
第二种是投影的骨架,它描述手或者说机械臂在做什么,然后它是一种显式的表征,它是和图像 pixel 逐像素对齐的。这两种信号由于都是 vision 的信号、视觉的画在图像上的信号,它对人、夹爪还是灵巧手都是通用的。同时,对于投影的 skeleton,由于它是通过每个单独的本体它自己的运动学模型来投影得到的,所以它又保留了不同本体它真实的运动学结构。右边可能就是一个展示,右边是一个宇树 G1 的真实的数据,可以看到画面深度、关节状态和 skeleton 都是在每个时间戳都是同步的。
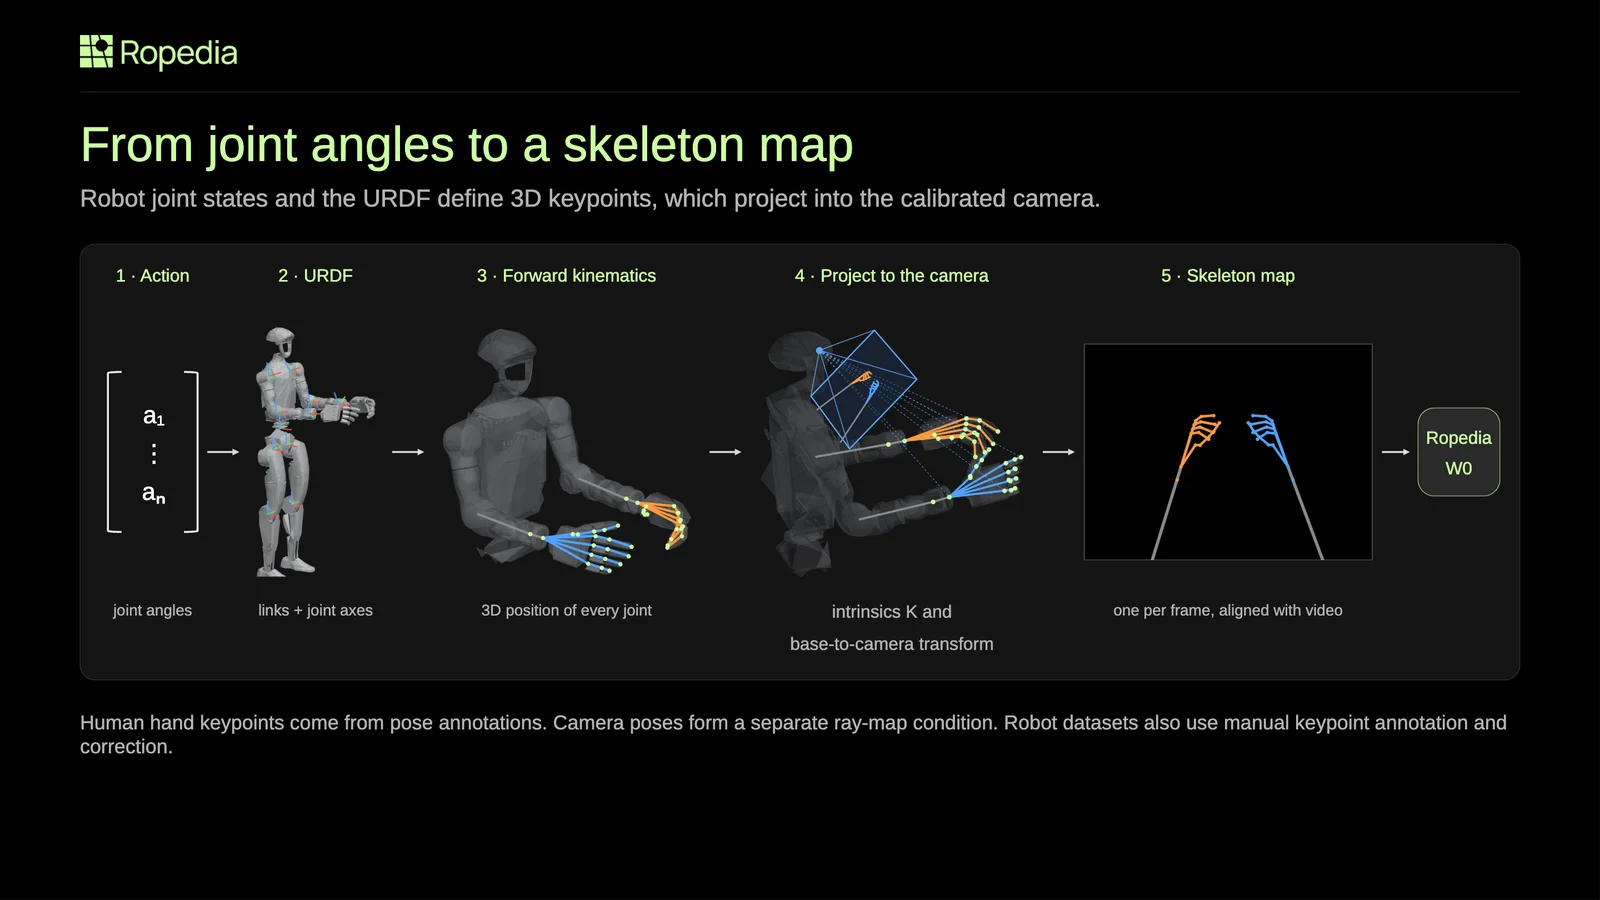
那机器人的动作,之前的 action 本质上就是一串关节角度,那是怎么从关节角度变成我们最后想要的画面中逐像素对齐的骨架?这里是一个示意图流程图。第一个我们先拿到这些动作的 action,就是每个关节的角度,然后第二步是通过 URDF——URDF 可以把它理解为机器人的设计图,里面写着每一节连杆到底有多长、每个关节应该绕哪根轴转。然后第三步是正向的运动学,可以把最原始的关节角度沿着 URDF 设计图给一节一节算下去,这样就可以得到每个关节在三维空间中的坐标位置。第四步就是可以借助于相机内参和机器人到相机变换的外参,可以将这些三维点给投影到相机的画面上。第五步把投影出来的这些关节点连成线,就可以得到一个每一帧逐像素对齐的骨架图,这是对机器人去怎么拿到它 skeleton map 的一个流程。
对于人来说的话,那肯定就没有所谓的 URDF 了,那人的话,我们就直接从这种姿态标注中去拿到对应的手部关键点,再用同样的方式去投影。这样一来,人和机器人最后对于他操作的表征都会变成同一种类似于视觉的形式,模型的话就可以向两边来学习,就人和机器人都可以,他们用了同一套表征就可以共享一套学习。
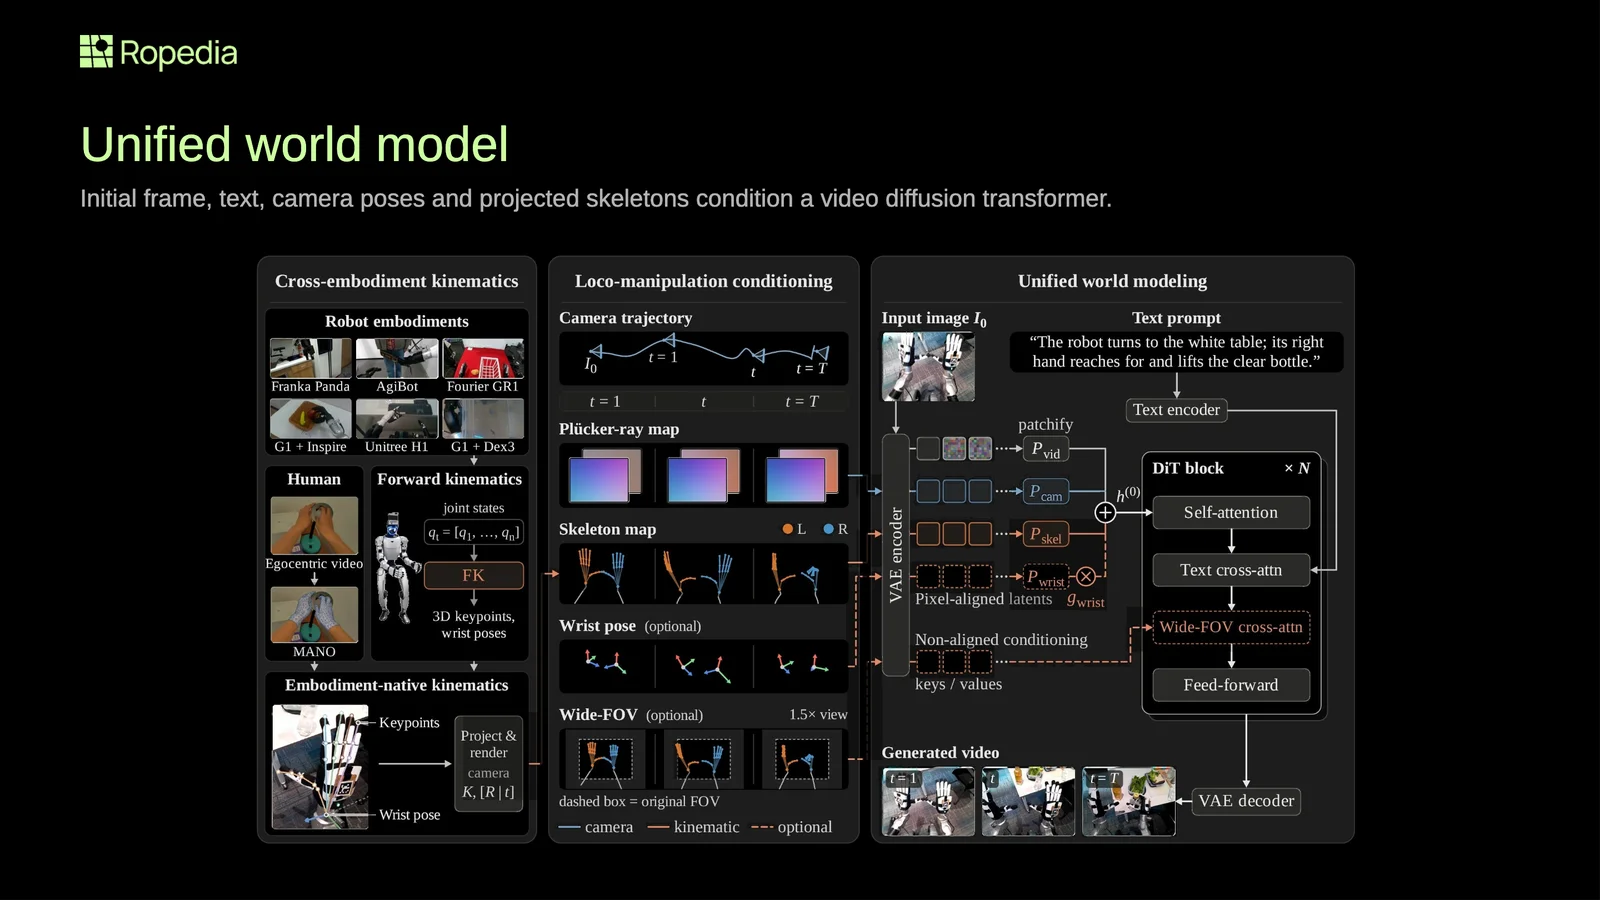
把这些拼在一起的话,我们最后的一个模型:最左边不管是人还是机器人,都会被转成同样的条件信号,也相机轨迹和骨架图,有些数据还可以额外提供手腕的位姿和更宽 FOV 更宽视野下的 skeleton。对于中间的话,这些动作的表征之前说了它是和视频每一帧是逐像素对齐的。最右边的话这些视觉的表征都会和当前的观测和任务文本描述一起,作为条件去输入到 diffusion transformer 视频扩散的模型,然后由它来生成接下来的观测视频。
总体上来说,我们基于在大量视频数据训好的视频基座的基础上,然后将这些 condition 注入进去,然后用我们采集到或者说标注好的人类和机器人数据去做训练。这样做的一个好处是可以去充分利用视频模型本身就已经学好的关于外观和运动的先验。然后我们这边学的,主要是关注第一个是我们给定的动作和最后预测视频对应的,然后第二个是我们用这么多交互的数据,不管是人还是机器人,去让模型学会怎么去做合理的和物理的交互。
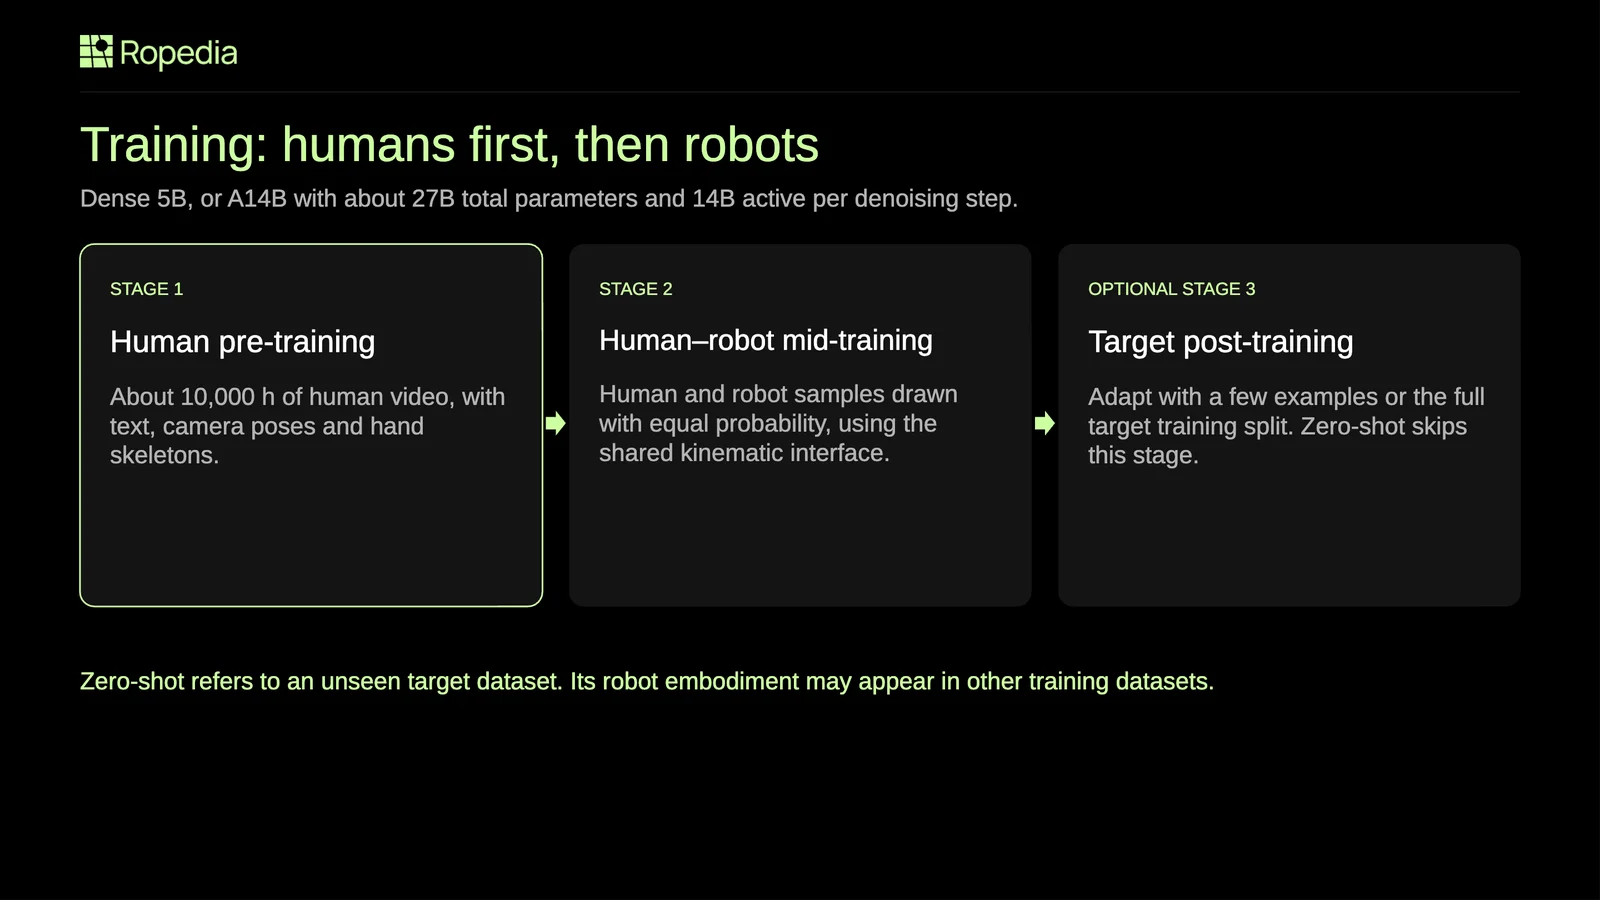
整个训练大概分为三个阶段。第一阶段我们只用 human data 去做预训练,大概 10000 小时,条件是文本、相机的位置和手部的骨架,这一部分主要是学的世界怎么随着我给的动作去变化,我的动作会导致世界的状态发生什么变化。
第二个阶段是人和机器人的混合训练,这里我们对人和机器人是用相同的概率去采样的,用的还是同一套共享的运动学接口,也相机轨迹和 skeleton。
第三阶段是可选的,在目标机器人上用少量或者全量数据做后训练。当然如果我们在评估的时候 setting 是零样本测试的话,那 stage 3 是不需要的。
我们的模型也有两个规模,一个是 5B 的稠密模型,另外一个是 A14B,总参数大概是 27B,每一步去噪激活大概 14B。
一句话来概括的话,我们的模型是先从人身上去学习世界是怎么动的,然后再学不同的身体怎么动。
四、实时化:蒸馏与流式生成
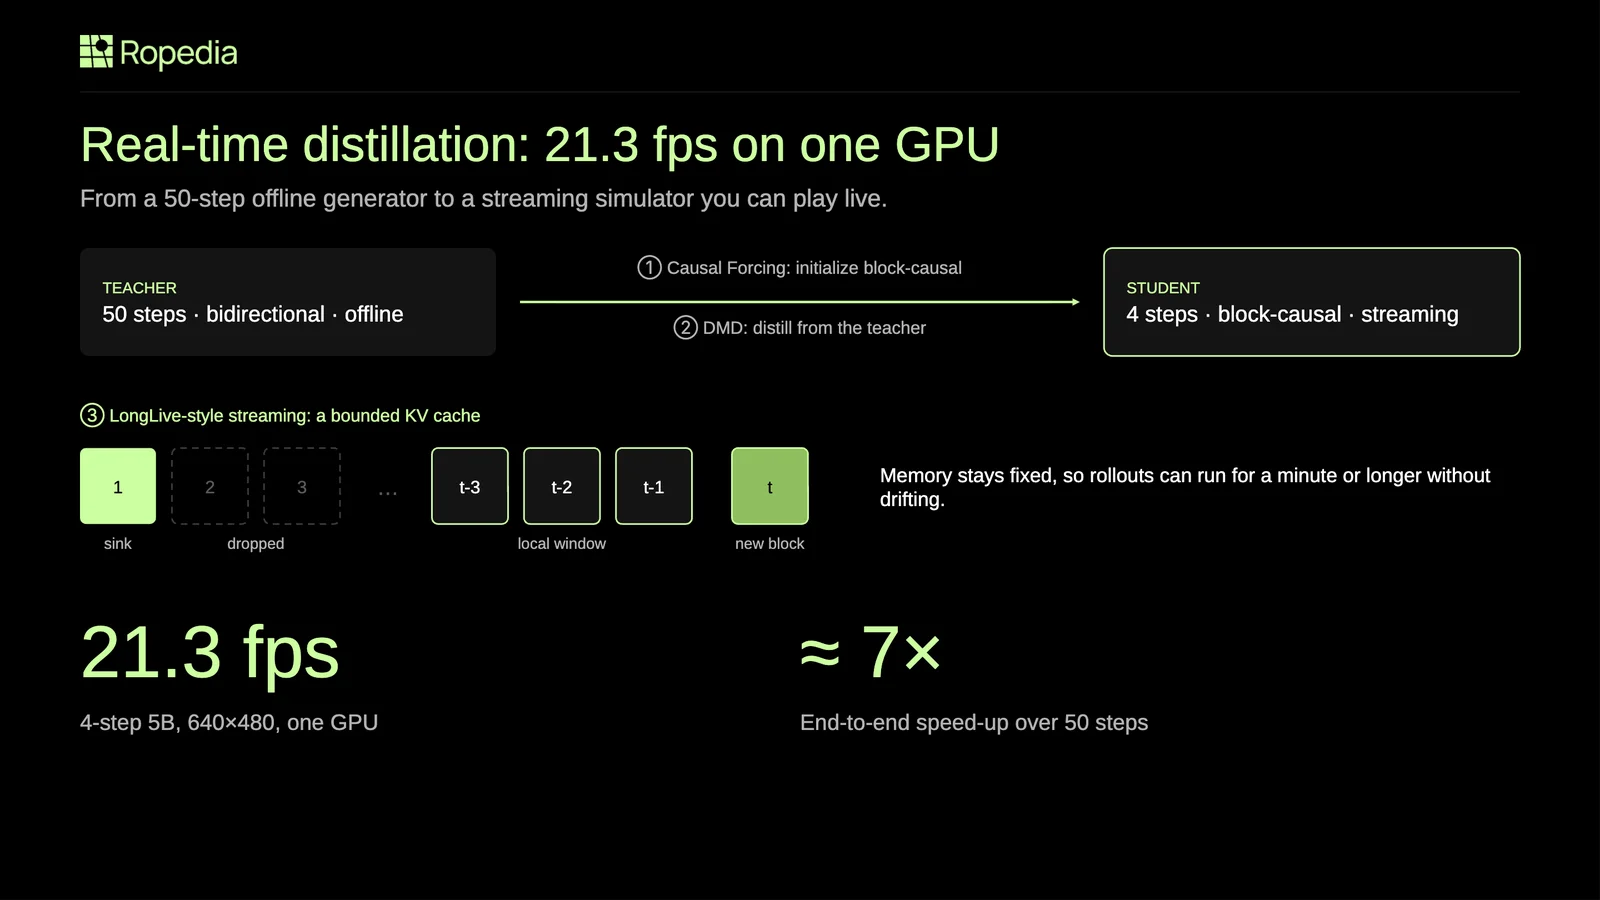
前面提到一个好的世界模型,不仅要 action following,它物理交互要做得比较好,还需要一个点,速度得快。原始的视频生成模型,它需要几十步,比如50 步地去噪,这种离真实的实时交互还差很远。所以我们也会把我们前面训好的这种模型给 distill 蒸馏成一个可以去自回归流式的一个可以做实时交互的生成器。
这里主要有几步。第一步的话就是把我们之前训好的双向 diffusion 给改造成像类似于语言模型一样那种自回归式的一块一块往后生成的范式,然后每一块去噪只需要四步,然后边生成边播放。然后第二个是让自回归式的快模型向最开始学好的又慢但是质量高的 50 步的模型去学习,它们之间会通过 DMD 一种蒸馏的方式来训练。第三点就是说,我们可以通过 DMD 将原始的比较慢的、质量比较好的模型给蒸馏成一个自回归式的一块一块生成,然后每一块生成的时候只需要少量去噪的部署的这么一个比较快的模型。
它还是只能做固定时间段的视频生成,比如5 秒。我们也想把它改造成不仅快而且能够长视频生成的模型。所以在第三步,我们主要参考了 LongLive 这种风格式的长视频训练,主要可能生成的时候,只让模型去记住最近一段的内容,而不是把之前所有的视频帧都记住,那这样会出现 memory 过曝的问题。除了只记住最近的一段内容,也会去重点关注开头的几个锚点,这样显存就不会越用越多,视频也能比较稳定地生成很长。经过这么一套蒸馏下来,我们最后的效果大概是能够在单卡上在 640×480 分辨率下,可以做到 21.3 FPS 的速度,端到端比最开始的 50 步会大概快 7 倍,可以连续生成 1 分钟左右比较稳定的交互视频。我们最后在 application 应用那个环节会重点展示一下这么一个效果。
五、实验结果
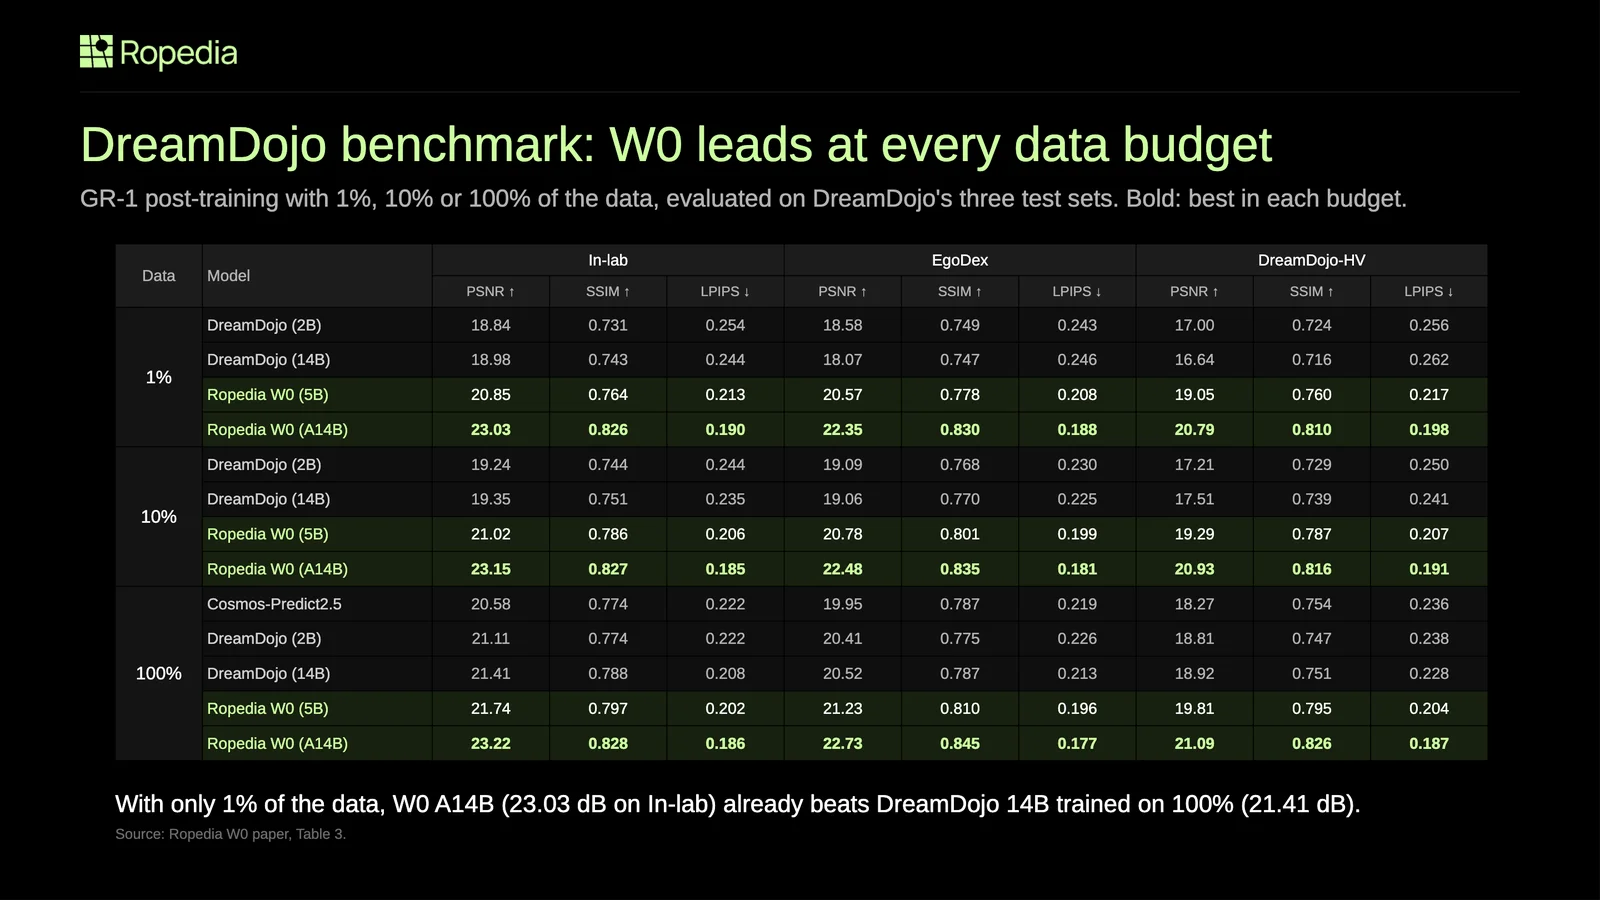
后面可以跟大家一起来看一下我们工作的实验结果。
第一个是我们在英伟达的工作叫 DreamDojo,它自己建的一个 benchmark 上去比了一下,用跟他们论文中用的同一个协议来比的。他们的机器人的型号是 GR-1,一个人形机器人的型号,分别用了 1%、10% 和 100% 的数据来做后训练。
在 DreamDojo 划分的测试集上去评估生成的质量,主要用的是 PSNR、SSIM、LPIPS 这三个比较常用的指标,然后每一档数据最好的结果都加粗和高亮了。可以看到在三档不同的后训练数据的 setting 下,我们的模型在所有指标上都是最好的,然后即便我们的小一档的模型,5B 的模型也在不同的赛题下全面超越了 DreamDojo 14B 的模型的效果。
可能比较值得注意的一点就是说,在左上角,我们只用了 1% 的后训练数据,我们的 14B 模型,比如在第一个评测集上也取得了 23.03 的这么一个指标,这个指标是相当于超过了 DreamDojo 14B 模型,在 100% 的后训练数据集上取得的 21.41 的这么一个指标效果,就说明我们的预训练,从人类经验中去学到东西,确实能够大幅度减少对目标机器人的数据需求,就用少量的数据去微调,就能够取得一个很好的预测结果。
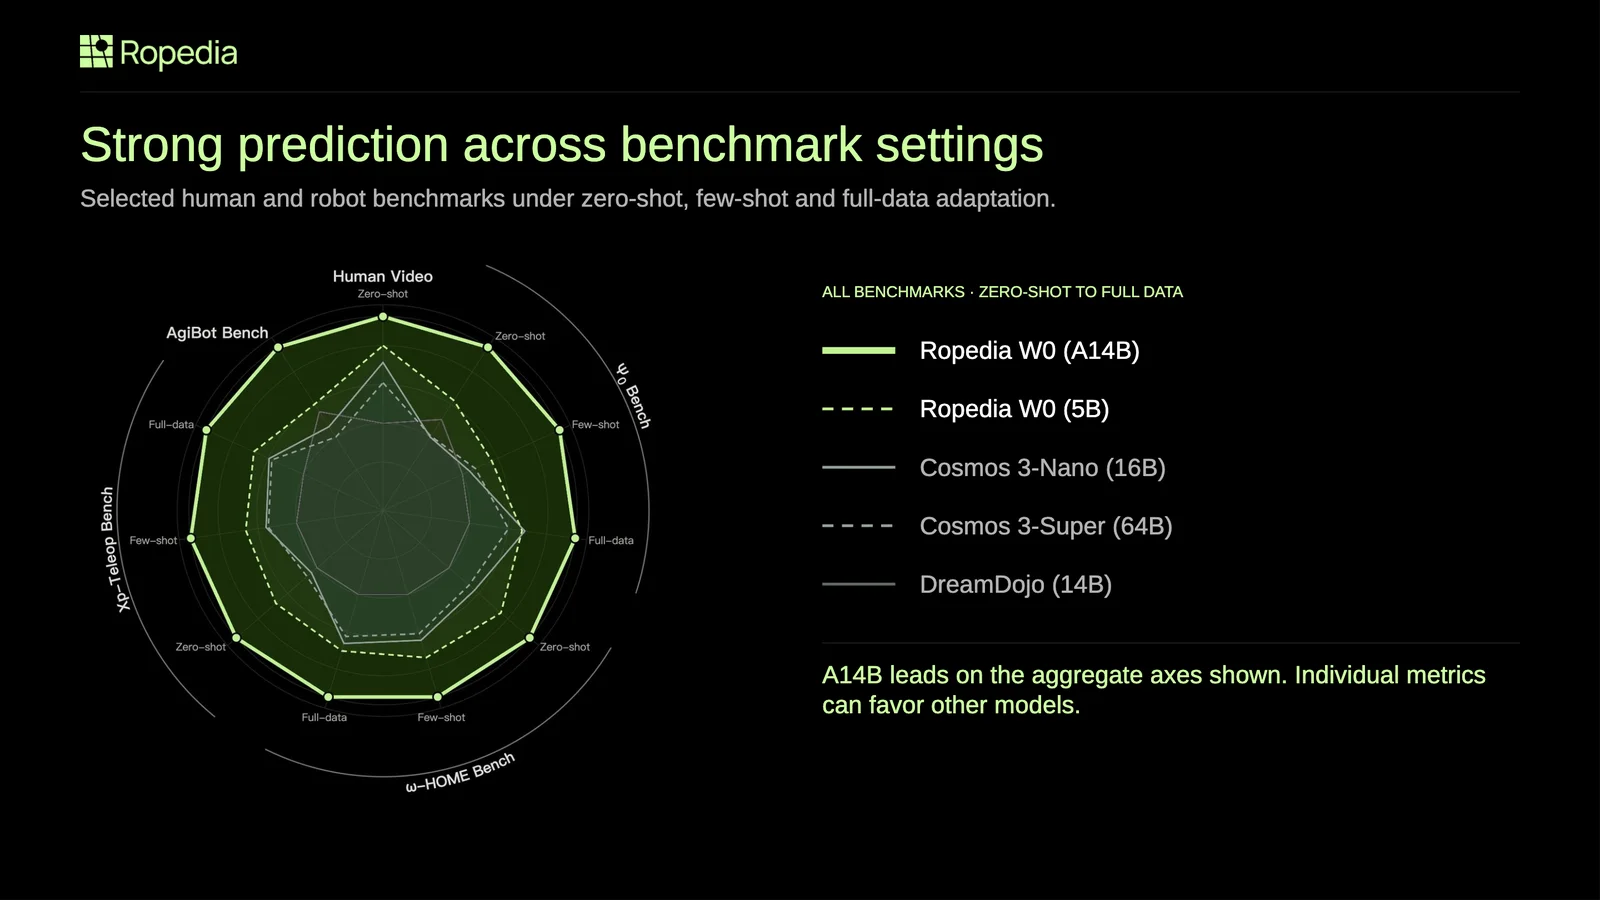
这里阐述了更多在不同的 benchmark 和数据集上的一些评测的效果。这里是用一个雷达图来把更多评测放在一起来看,这里面主要包括了人类视频和好几个机器人的数据基准上的效果,然后每个部分我们也测了不同的 setting,就是说我们是 zero-shot 还是 few-shot 还是用所有的后训练数据来训。
这个指标是越往外越好,然后这个实线绿色部分是代表的是我们的 14B 模型,然后从里面的虚线的绿色是代表的是我们的 5B 模型,再靠里面的灰色是 Cosmos-3 和 DreamDojo 的指标效果。然后综合图上的这些综合指标来看,我们的模型不管是 14B 还是 5B 都在视频或者结构预测上都取得很好的效果,即使 Cosmos-3 和 DreamDojo 的模型尺寸可能会更大。
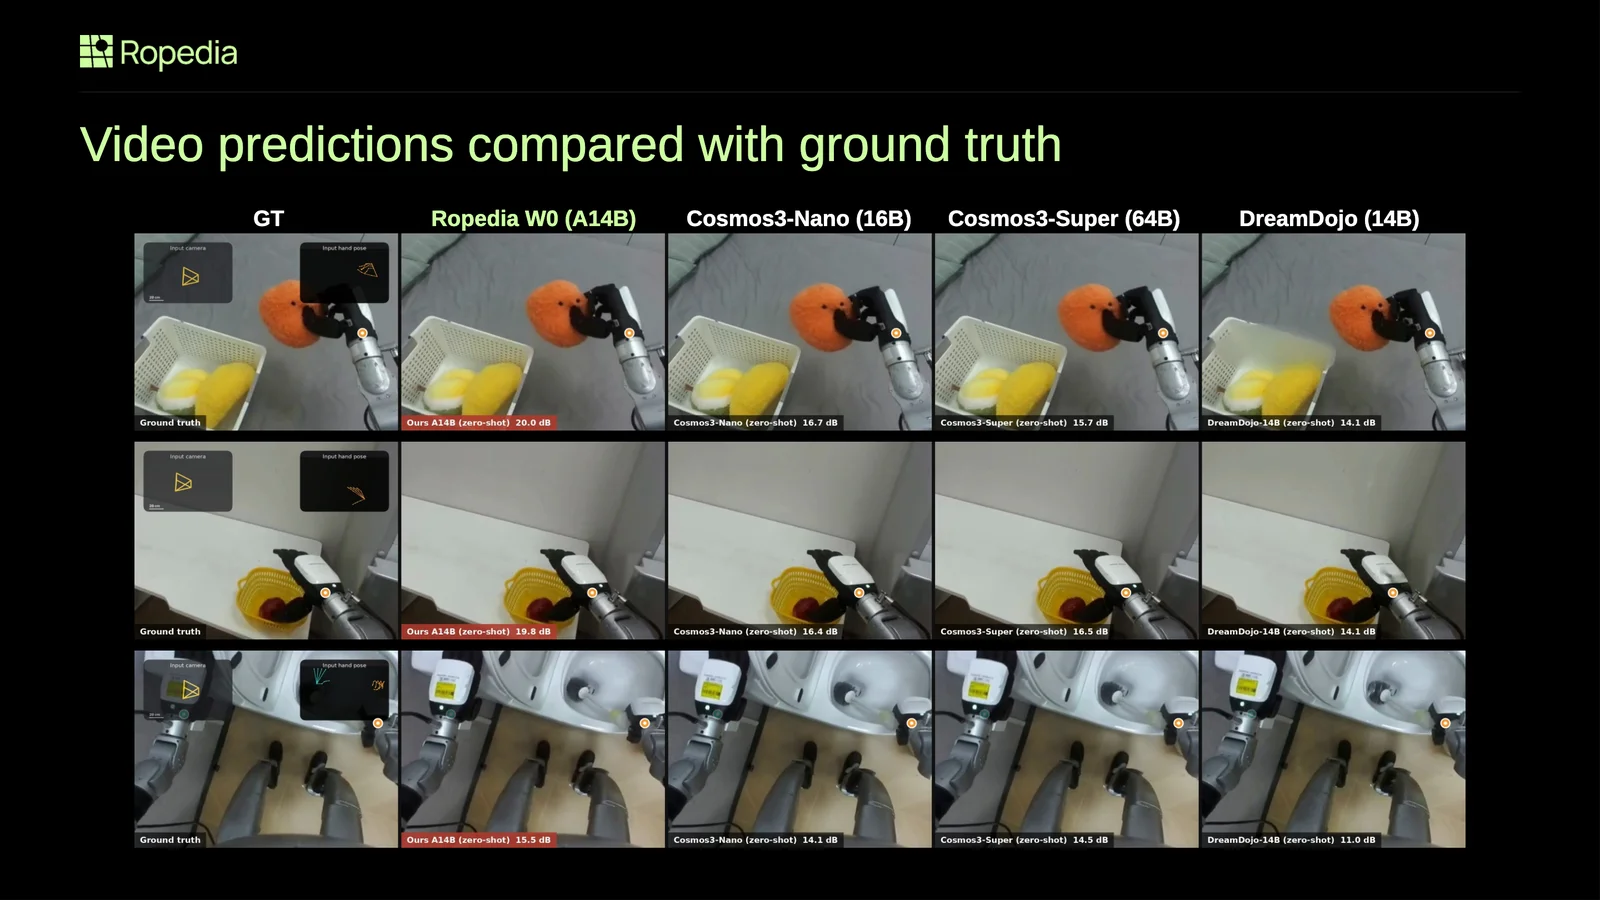
然后这里可能可以展示一些定性的视频结果来给大家具体看一下效果。这里的话展示的是不同模型在同样的输入下、就给同样的动作 action,放在一起,他们最后模型输出视频的一个对比。然后最左边一列是 ground truth 就是真实的视频,然后右边就是不同模型预测的视频。可以看到我们的模型和 GT 还是特别吻合的,不管是从画面质量还是动作上。
跟其他的模型对比的话,我们模型的主要的视频效果优势体现在两个方面,第一个是说这种动作的跟随会和 GT 给的这个动作比较相对比较接近,不管是说手的运动、机械臂的运动,还是说这个视角的运动,都会相比其他方法更加接近。第二个是交互,我们的手在和其他物体交互的时候,这种效果是更加自然和物理生成性更好的。
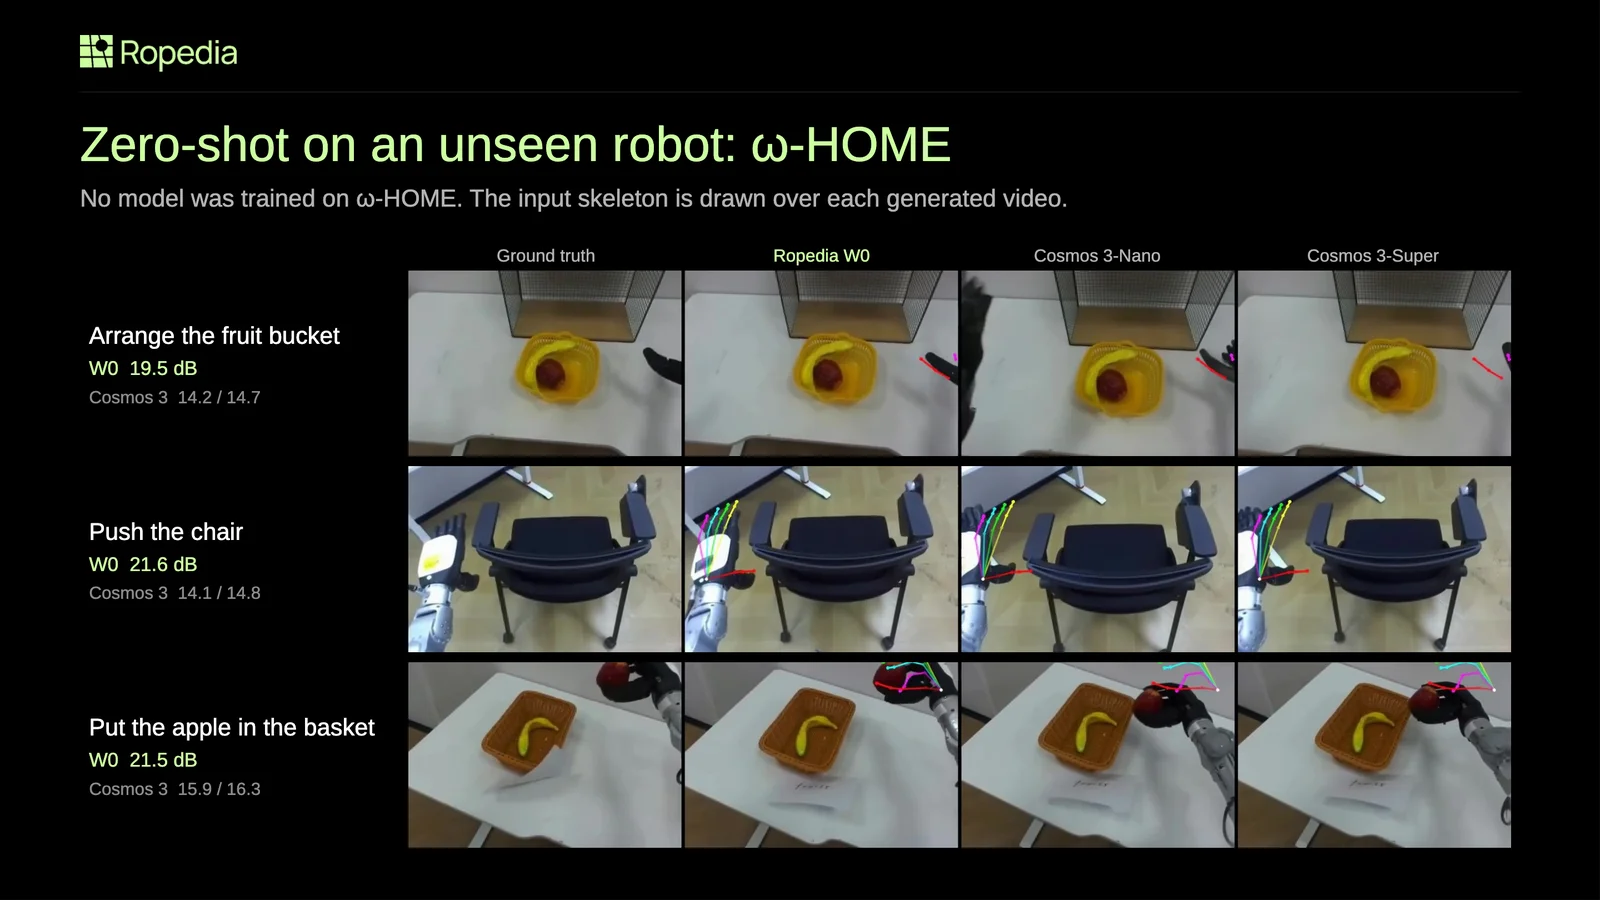
然后这里再看两组和 Cosmos-3 的组帧对比,这一组是来自于 ω-Home 里面的一些样本,这是一款就是说我们现在所有模型都没有见过的一个数据集,所以是完全 zero-shot 上去的效果。每一行从左到右也分别是 GT、我们的模型还有 Cosmos-3 的结果。然后画面上叠加的这个 skeleton,就是说它输入的动作的 skeleton,可以看到我们模型预测的画面是跟着这个 skeleton 一起动的,但是对于 Cosmos-3,它往往是做不到这么 pixel 逐像素跟随的。
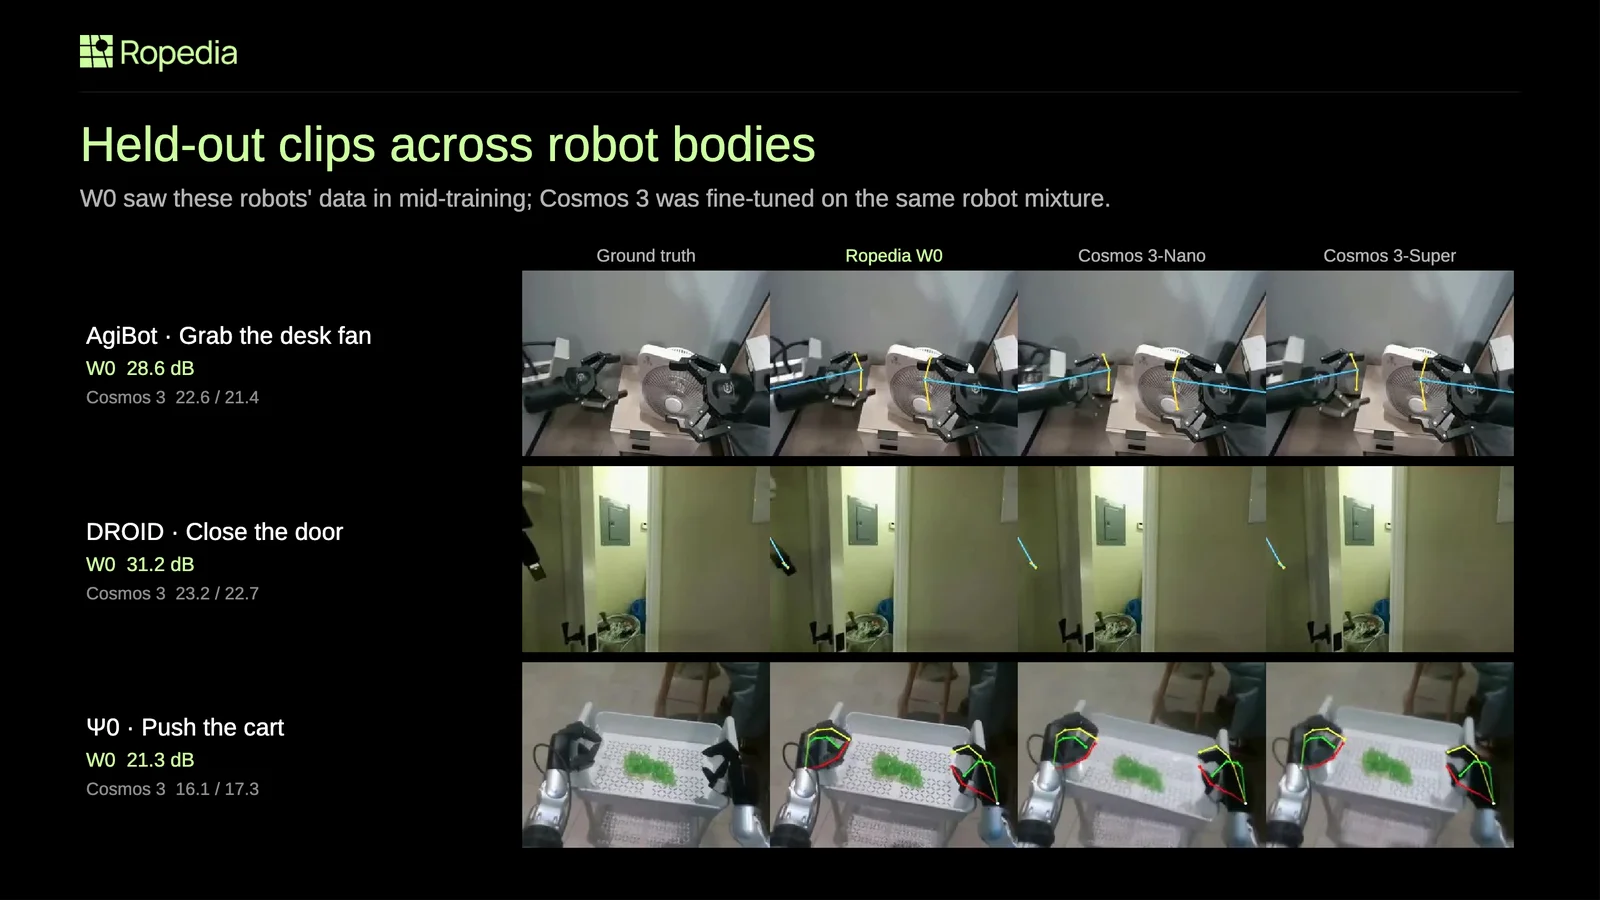
这里也展示了其他机器人本体上的一些对比,不管是说对于末端执行器是 gripper 的,还是说机械臂的,还是人形机器人灵巧手的,我们的模型在不同本体上的效果也是会比其他相关工作会更好的。
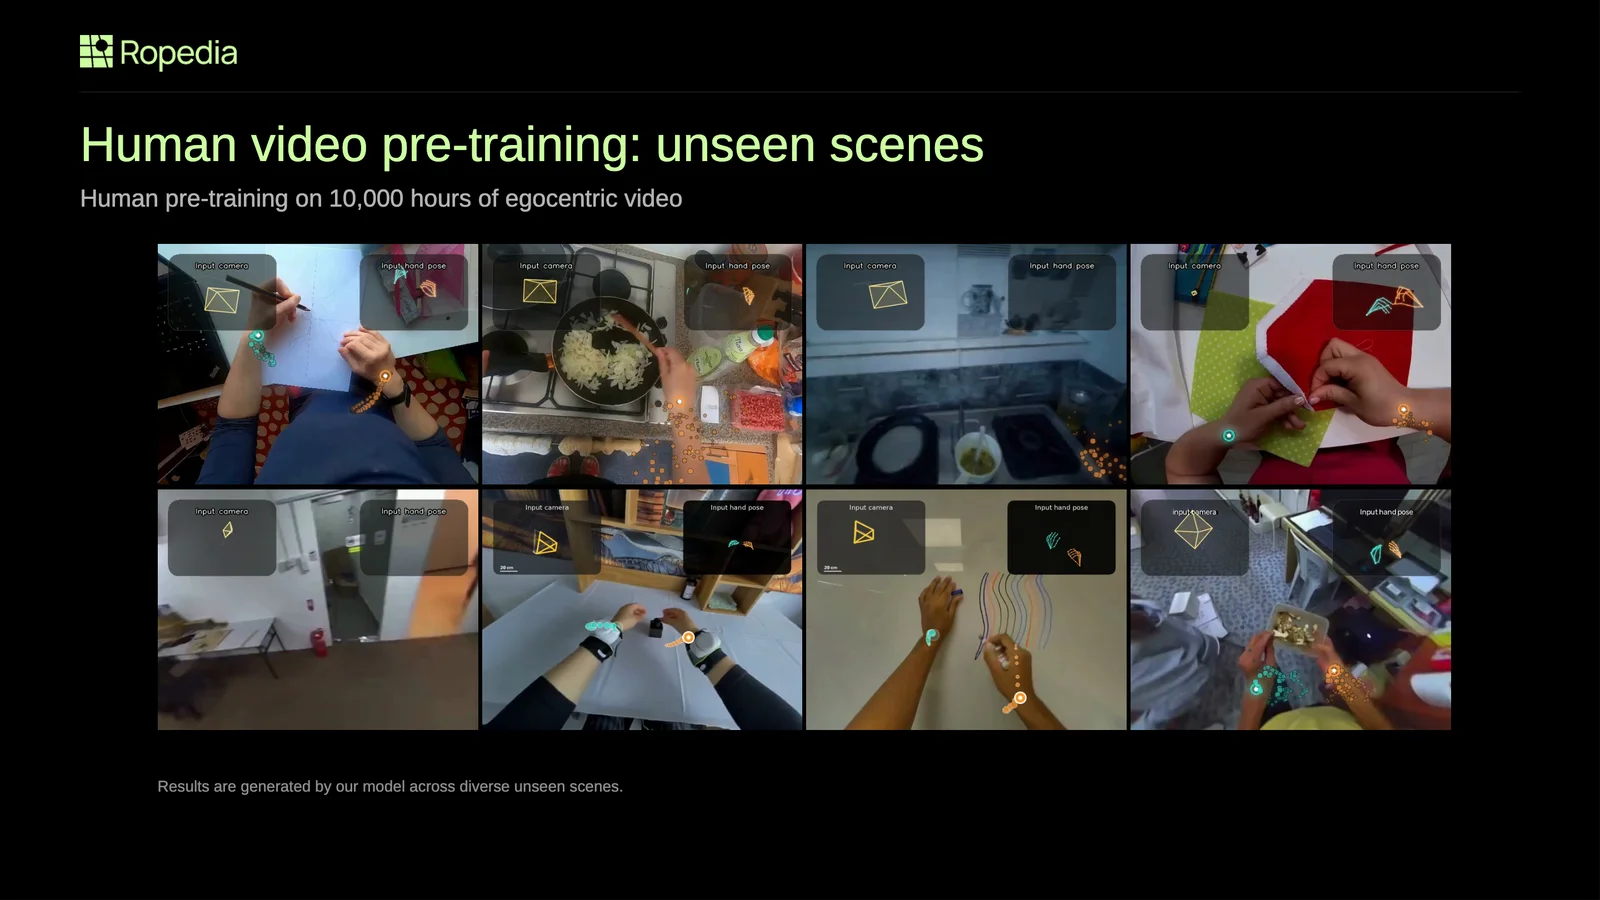
这一页是展示了模型在它没有见过的场景里面,模型生成的人类第一人称视角的视频,然后包括有厨房、书桌,还有各种做手工等等场景或者任务。每个视频画面的左上角或右上角的这些小图表示的是我们给模型的动作的可视化,一个是相机轨迹,一个是手部的姿态。可以看到模型生成视频,同时跟住了这两种信号,视角会随着头部运动,然后手的动作也和骨架保持一致。这主要得益于我们用了 10000 小时的人类数据做预训练。
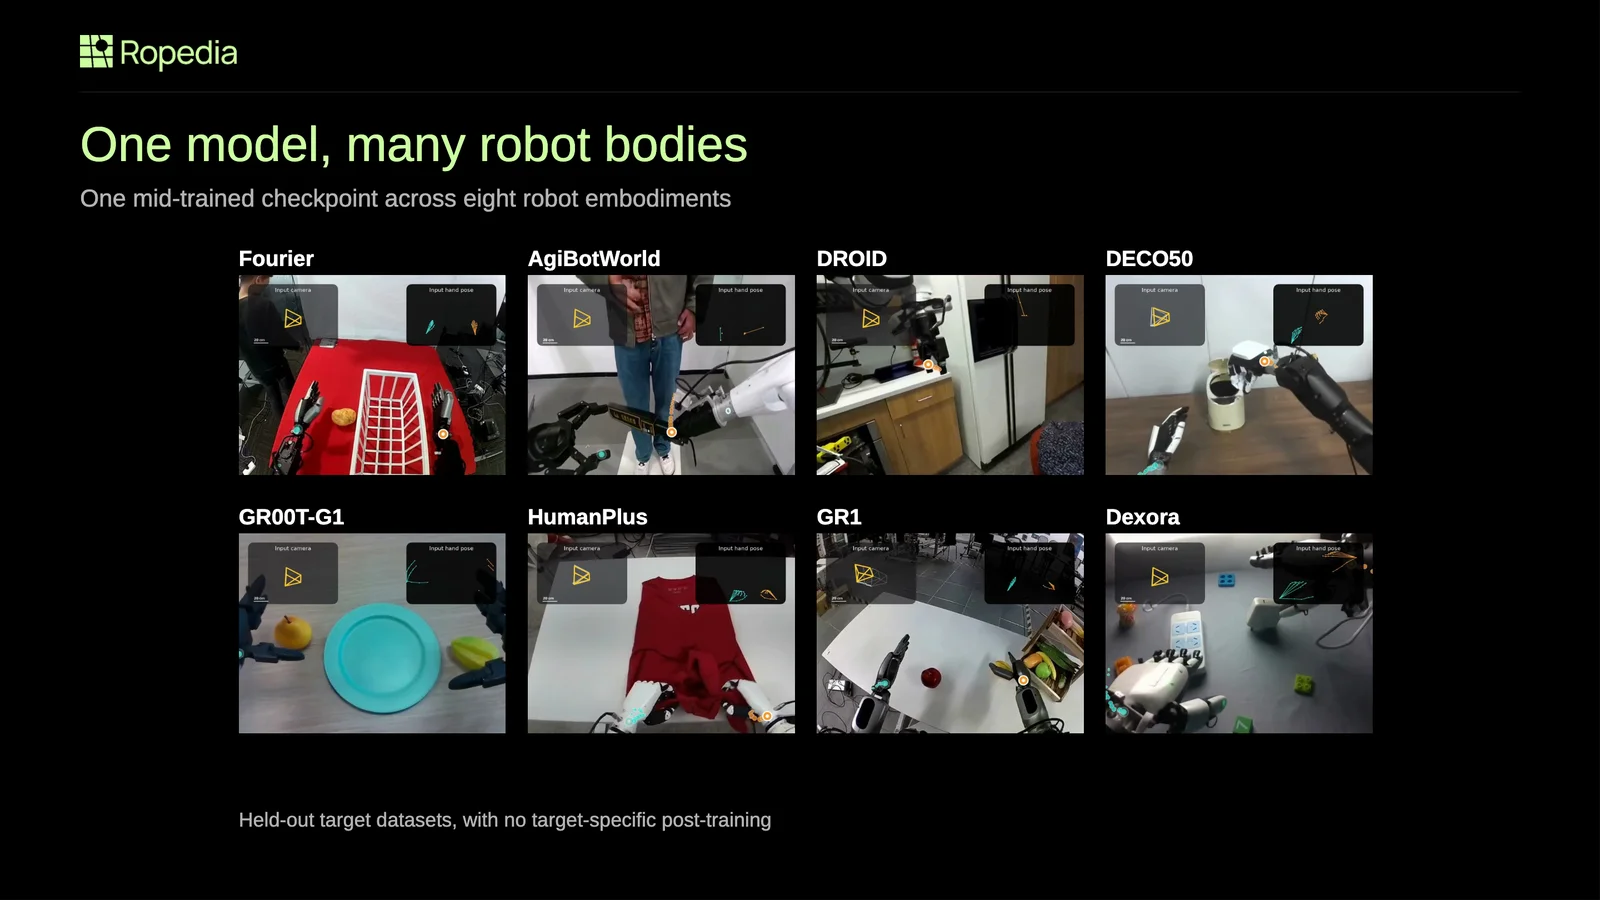
这里展示的是我们训同一个模型,然后直接放在不同机器人本体上去做推理时的效果,不需要做特定机器人上的复训练,直接去 inference 的结果。这里展示了八种不同的机器人,从不管是单臂到双臂机器人还是到像类似于宇树这种人形机器人,都可以拿到一个比较好的视频预测的交互结果。这些结果也都是没有做针对性后训练的结果,通过同一个模型的权重去直接生成的,这可能就是我们之前说的,我们去统一这个动作接口的一个好处,用同一套表示就可以适用于不同的机器人本体。
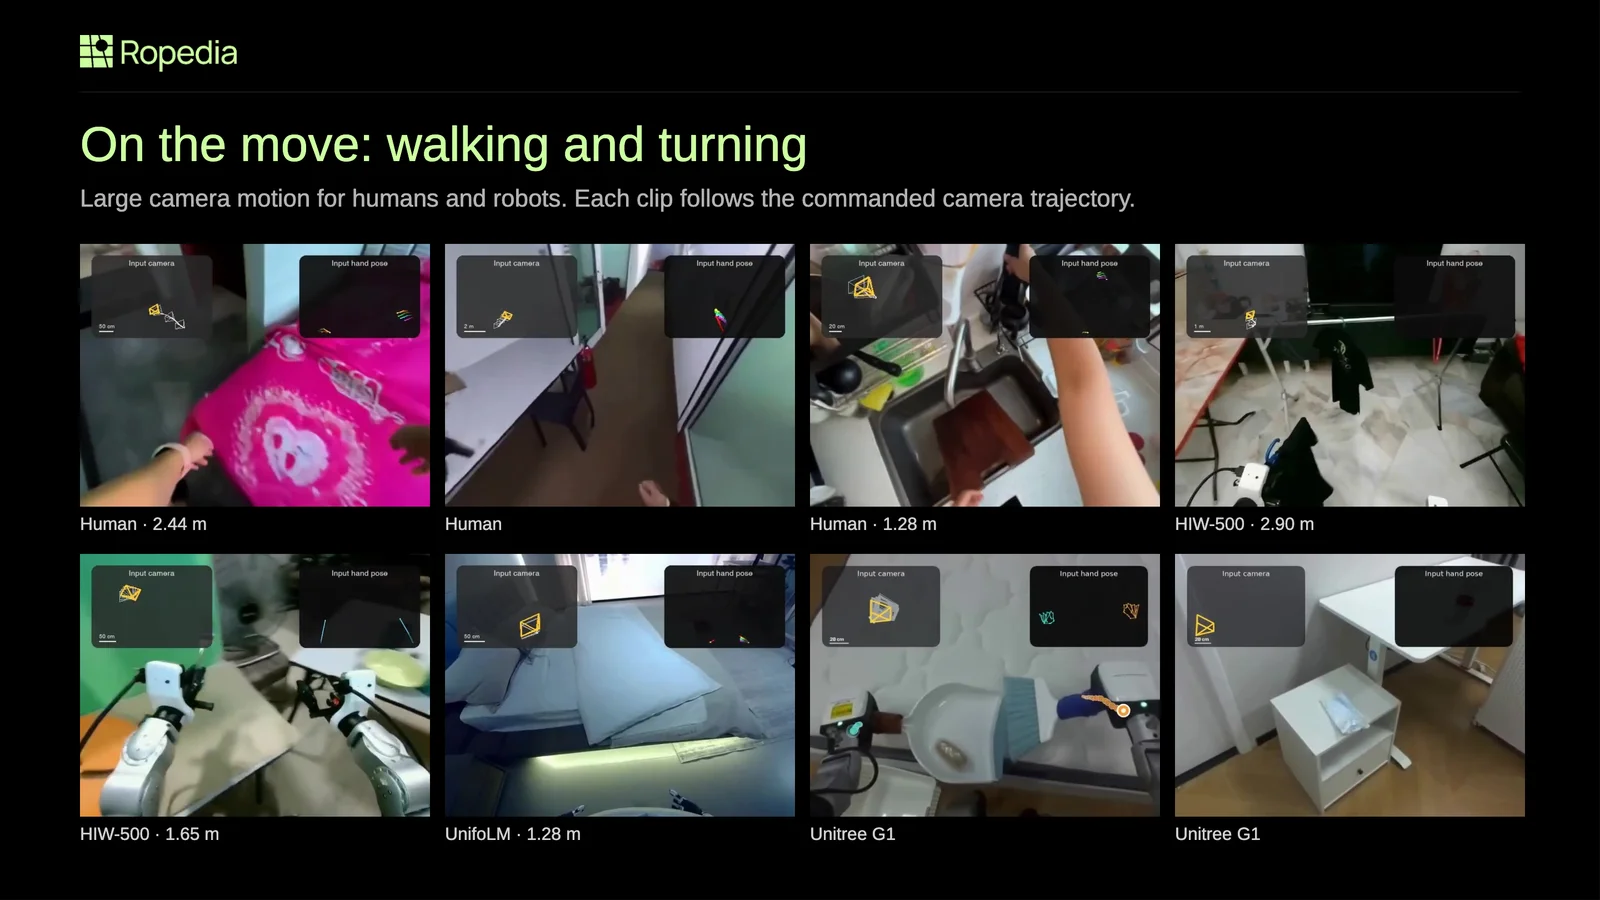
这一页可以重点看一下我们前面提到的 loco-motion 就是它的移动。这里人和机器人都在走动,或者说转身,有的走了几米,视角变化挺大的。然后每个画面左上角也是输入的相机轨迹,右上角是手的 skeleton。生成的视频会跟着我们相机轨迹走。在视角变化的时候,房间的结构在走动过程中也保持得相对比较稳定,不会说我转了一个身,你就变成另外一个房间了。
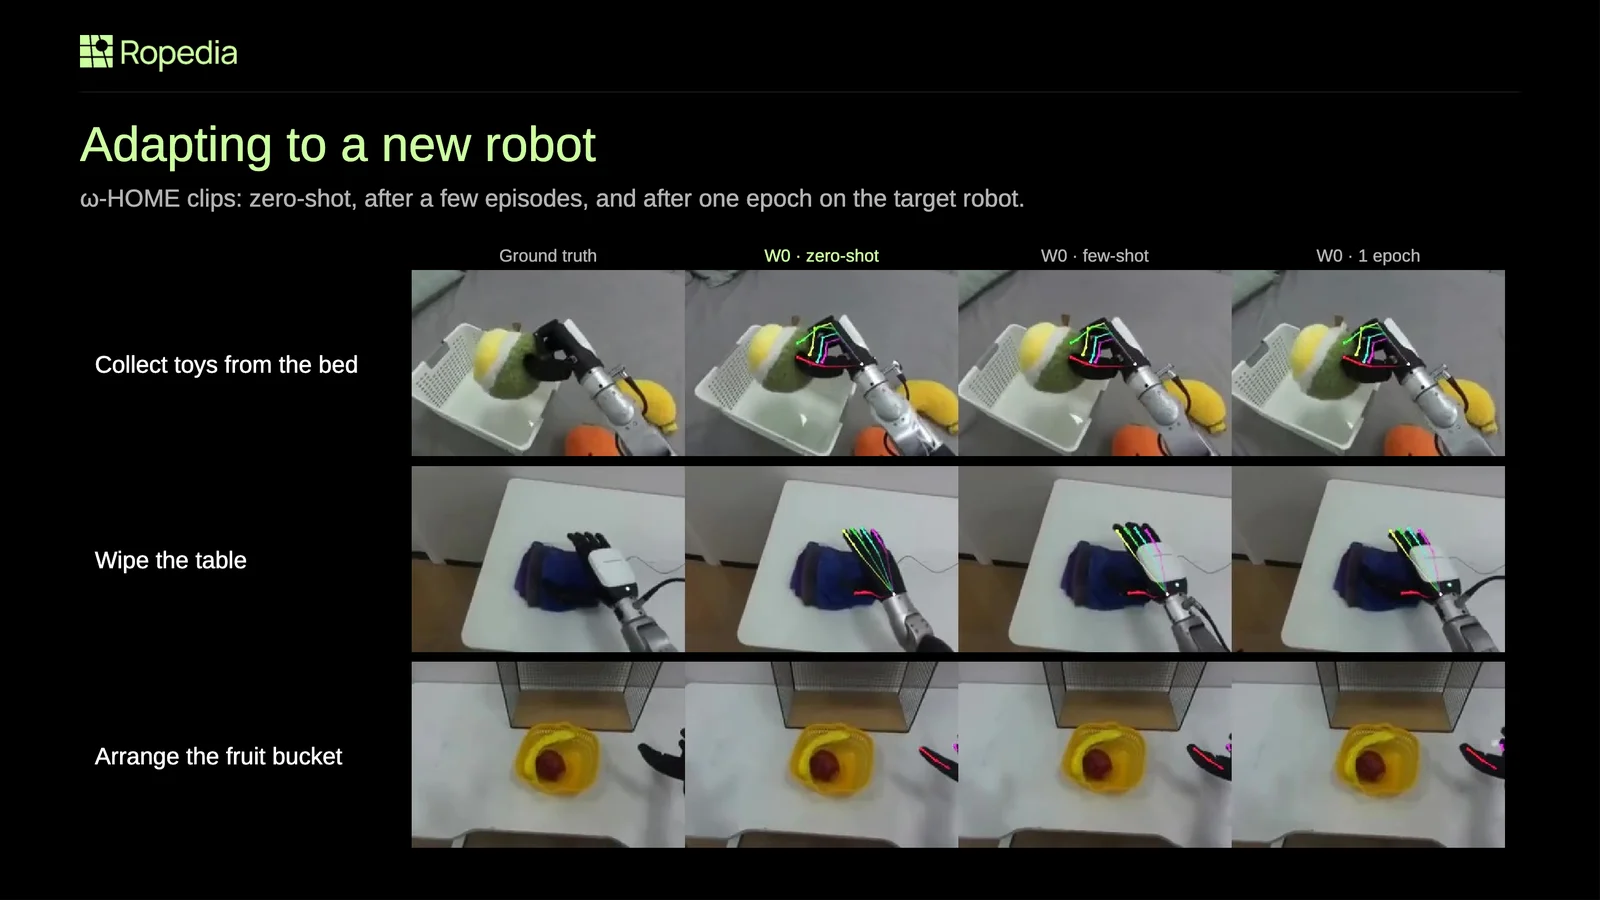
那遇到一种机器人在训练中没见过的机器人的话,需要多少数据才能去适配?这里我们展示了一些可视化,就每一行从左到右,第一列是真实的视频画面,第二列是我们模型在零样本下的视频结果,后面分别是通过 few-shot 后训练以及用了更多后训练数据来训出来一个结果。
从这个视频中我们可以比较直观地看到,在 zero-shot 的时候可能这些,比如以第二行为例,它的动作是完全跟随着 action 来动的,但是可能这个机械臂生成跟真实的不一样,当然这也很正常,appearance 会不一样,但是它动作是跟随的。
当我们加了少量的几条对应的机器人的数据来类似于微调以后,它的手的不管是 appearance 还是动作都还有交互都能够做得比较好。当然我们加入更多的后训练数据之后会更加好一点。
所以从这个例子可以看到我们的模型由于是通过不同本体、用统一接口来训出来的,去遇到一个新款机器人的时候,不需要去从头采很多这种目标数据集的数据,而是仅需要少量的数据微调一下,就能够在不管是 appearance 还是 action 交互上都能做到比较好的效果。
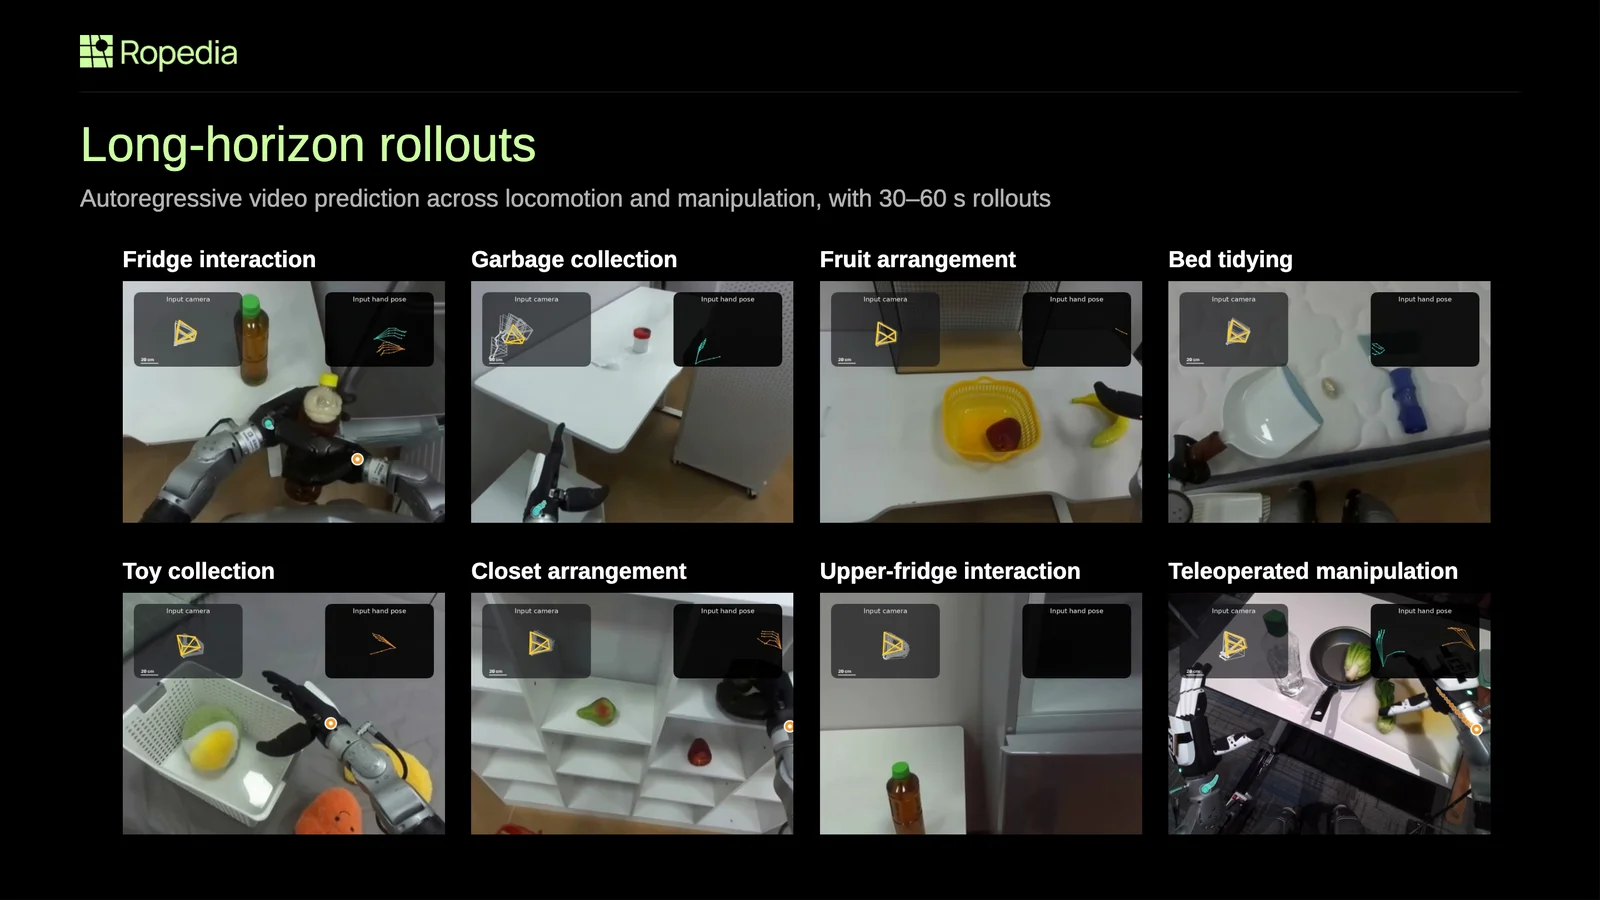
这里可以展示一个相对长视频的生成,大概 30 秒到 1 分钟的一个连续视频。这里面视频里面机器人会一边走一边操作,比如开冰箱、收拾垃圾、整理床铺。长视频最难的一点在于,在往后生成的时候,前面小的误差会一点点累积,然后到生成时间相对较长的时候,整个画面、整个场景可能就崩掉了。但是从我们展示的结果来看,我们的模型在长视频生成的时候还是相对比较稳定的,不管是交互的细节动作跟随,还是说整个场景环境,具体到里面可能是一些房间物体和机器人从头到尾还是保持得比较一致的。
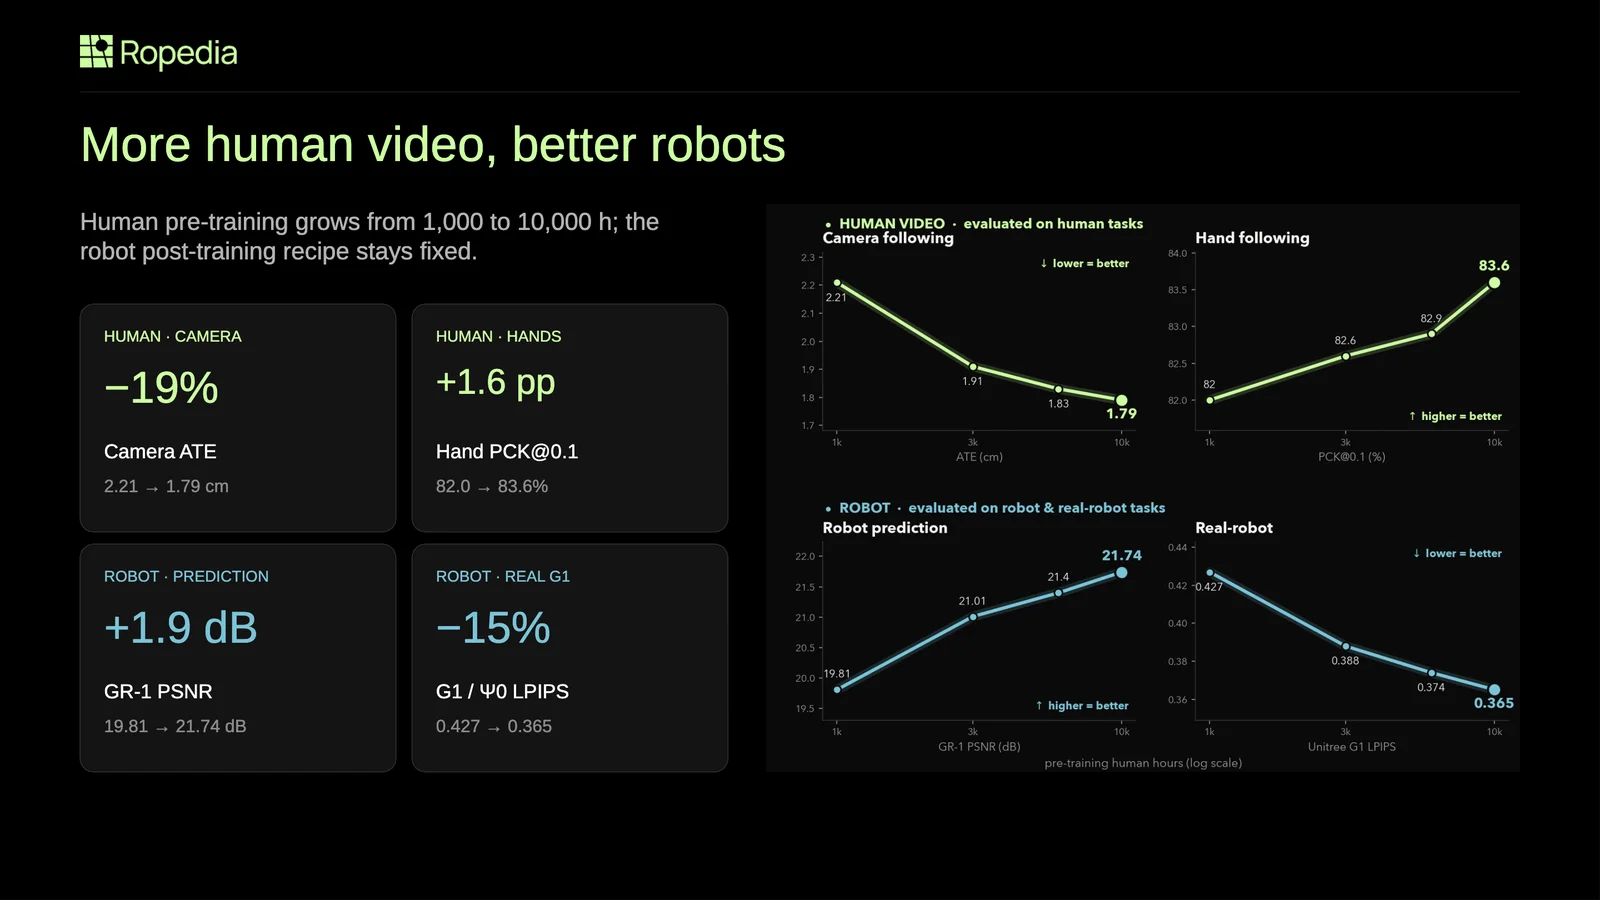
这一页展示的是我们去验证了一下 human 的 data 到底对于机器人的学习有没有帮助。这里我们具体的 setting 是我们把机器人的训练方式给定固定,然后它的变量就是说我们只改变预训练中人类视频的数据量,从 1000 小时到 10000 小时范围,我们发现所有的结果、所有指标都在变好。
随着人类视频预训练数据的上升,对于第一行来说,对于人类这一边,随着人类数据预训练数据量越来越多,它的 action following 的能力会变强,不管是相机的跟随误差还是手部姿态、手部姿态的准确率都在变好。更有意思的是,在下面这一行对于机器人来说,我们只改变预训练中 human 的 data 的数据数量,而不去变机器人方面,完全只用 human data 完全只变 human data,机器人方面是同一套 setting 去测,我们发现在 GR-1、就是 DreamDojo 那个 benchmark 上,它的这种预测精度提升了大概两个点,对于其他的数据集,比如宇树 G1 数据集,它的误差也在下降,挺下降了 15% 左右。
也就是说人类经验确实能够迁移到机器人上面去,投入更多的人类数据,机器人的预测也会更准,并且我们发现即使到 10000 小时,这个 scaling law 做这个 scaling 的趋势的曲线还是没有看到饱和的迹象。这一点可能对于我们这个领域也挺重要的,也跟其他的统计工作或者说之前的一些工作也观测是一样的。还是说机器人数据很难大规模采集,人类数据作为一个相对比较 scalable 的路线,确实对于后续具身机器人的学习是有帮助的。
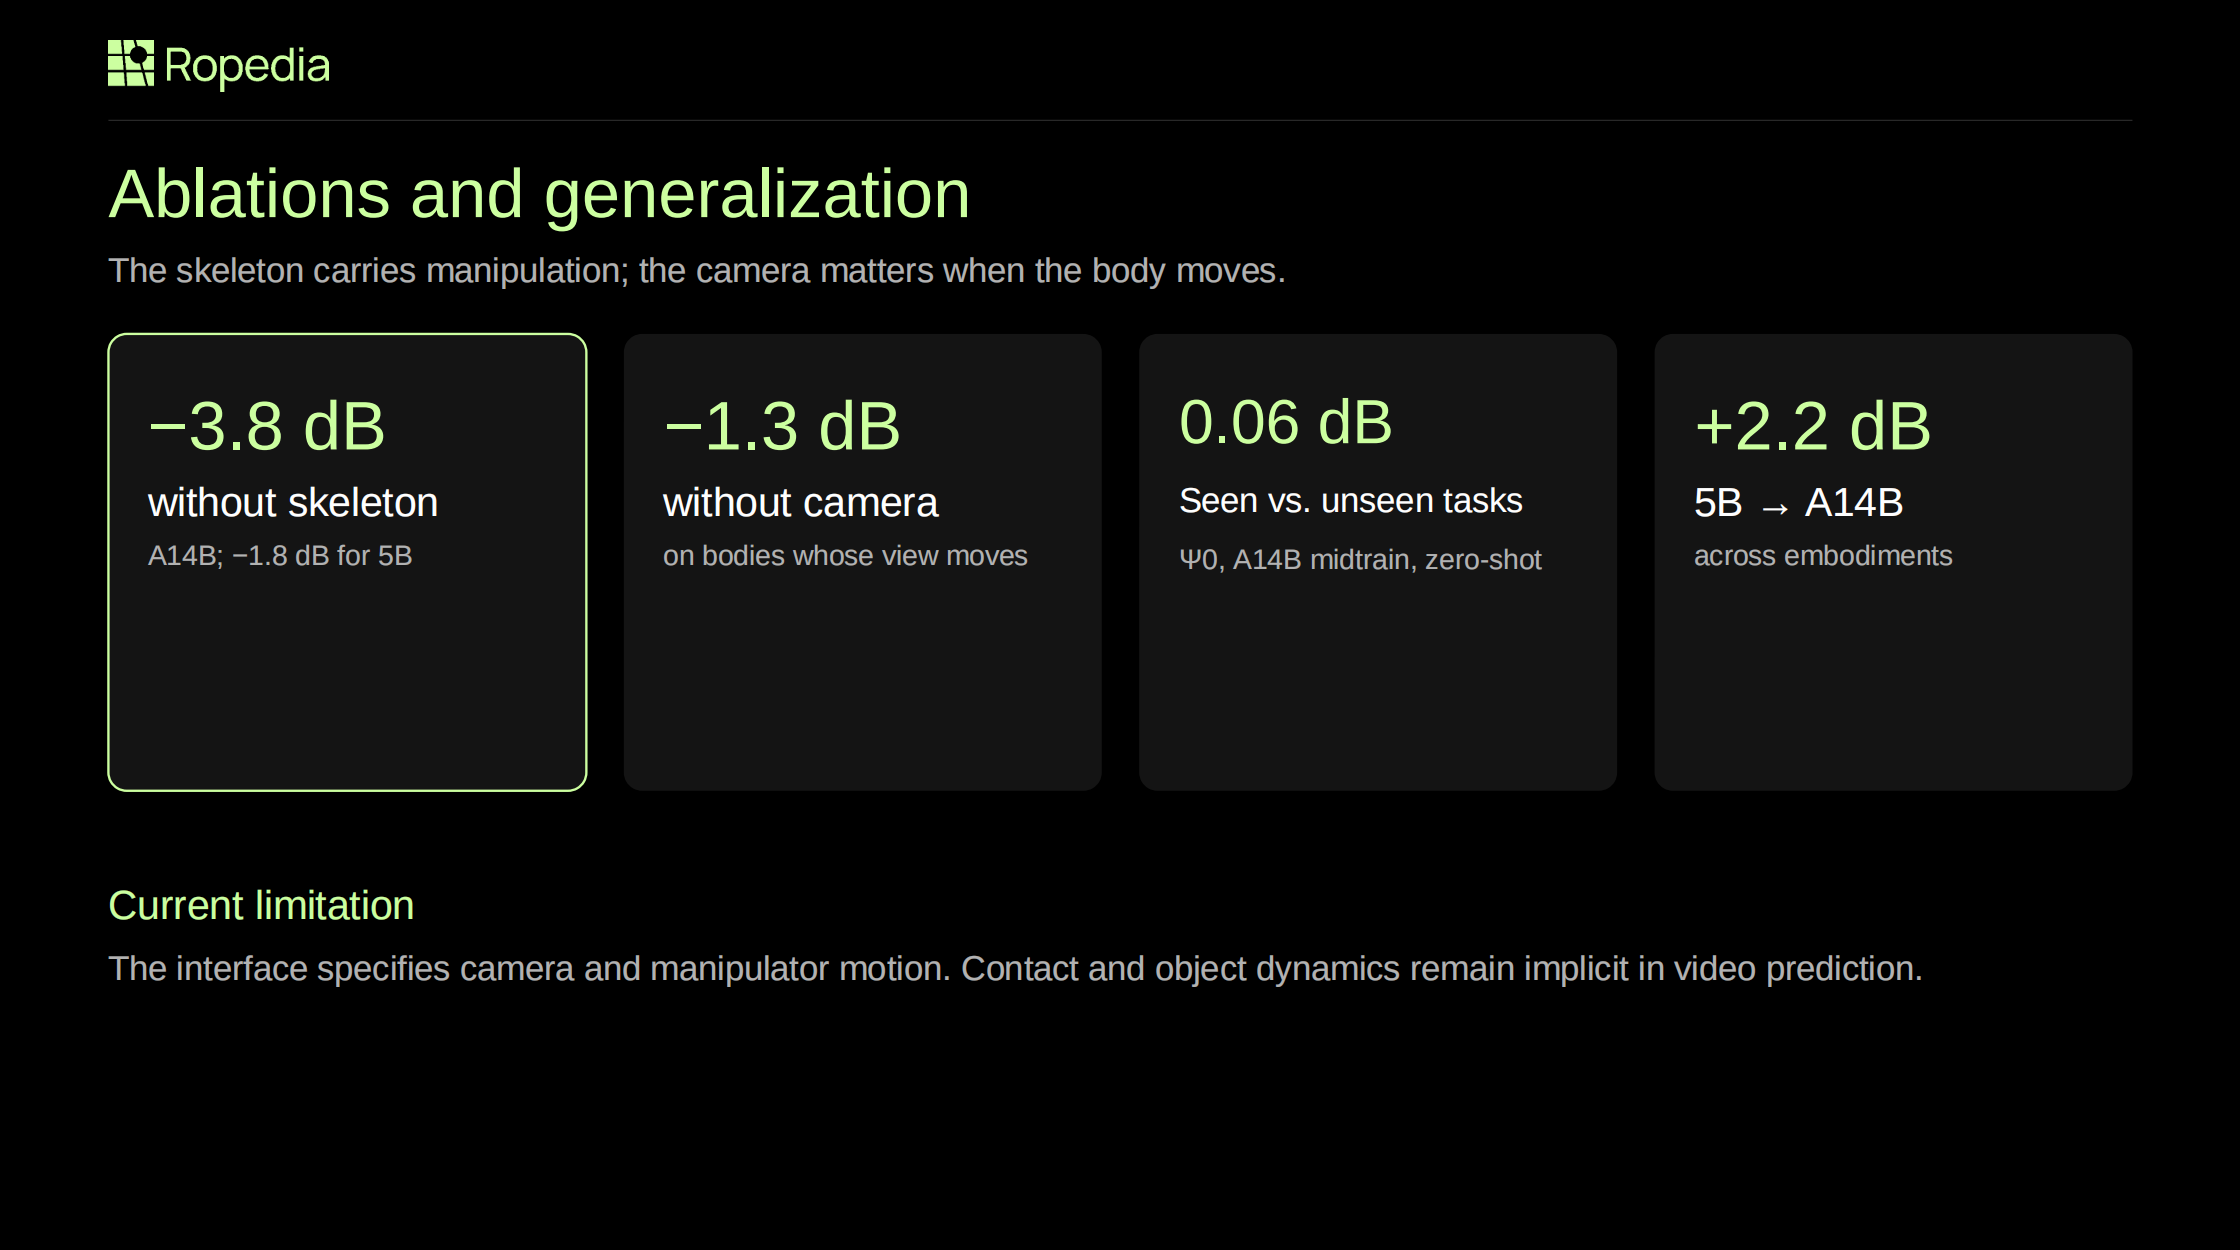
此外,我们也做了一些消融实验,比如说对于这个表征的消融实验,骨架、camera pose 做了一些消融实验,发现这两个表征还是确实是很有帮助的。
同时我们也去看了一下,模型在零样本的情况下,对于训练时见过和还没见过的任务,它们表现差异到底有多大,然后我们测下来发现只有 0.06dB 这么个 PSNR 的一个差距,所以说模型在面对不同任务不同环境的泛化性还是不错的。
我们也去对比一下我们模型,因为有两个尺寸的版本,一个是 5B 一个 14B 的,去对比一下两个性能,14B 随着模型尺寸变大,它对这种数据的利用、它本身的建模的经验是会更强的,导致于它最后训出来效果确实也会好一些。
六、下游应用
那有了这么一个视频的世界模型,它对具身到底有什么作用?这个我们之前在最开始的时候也讲过。
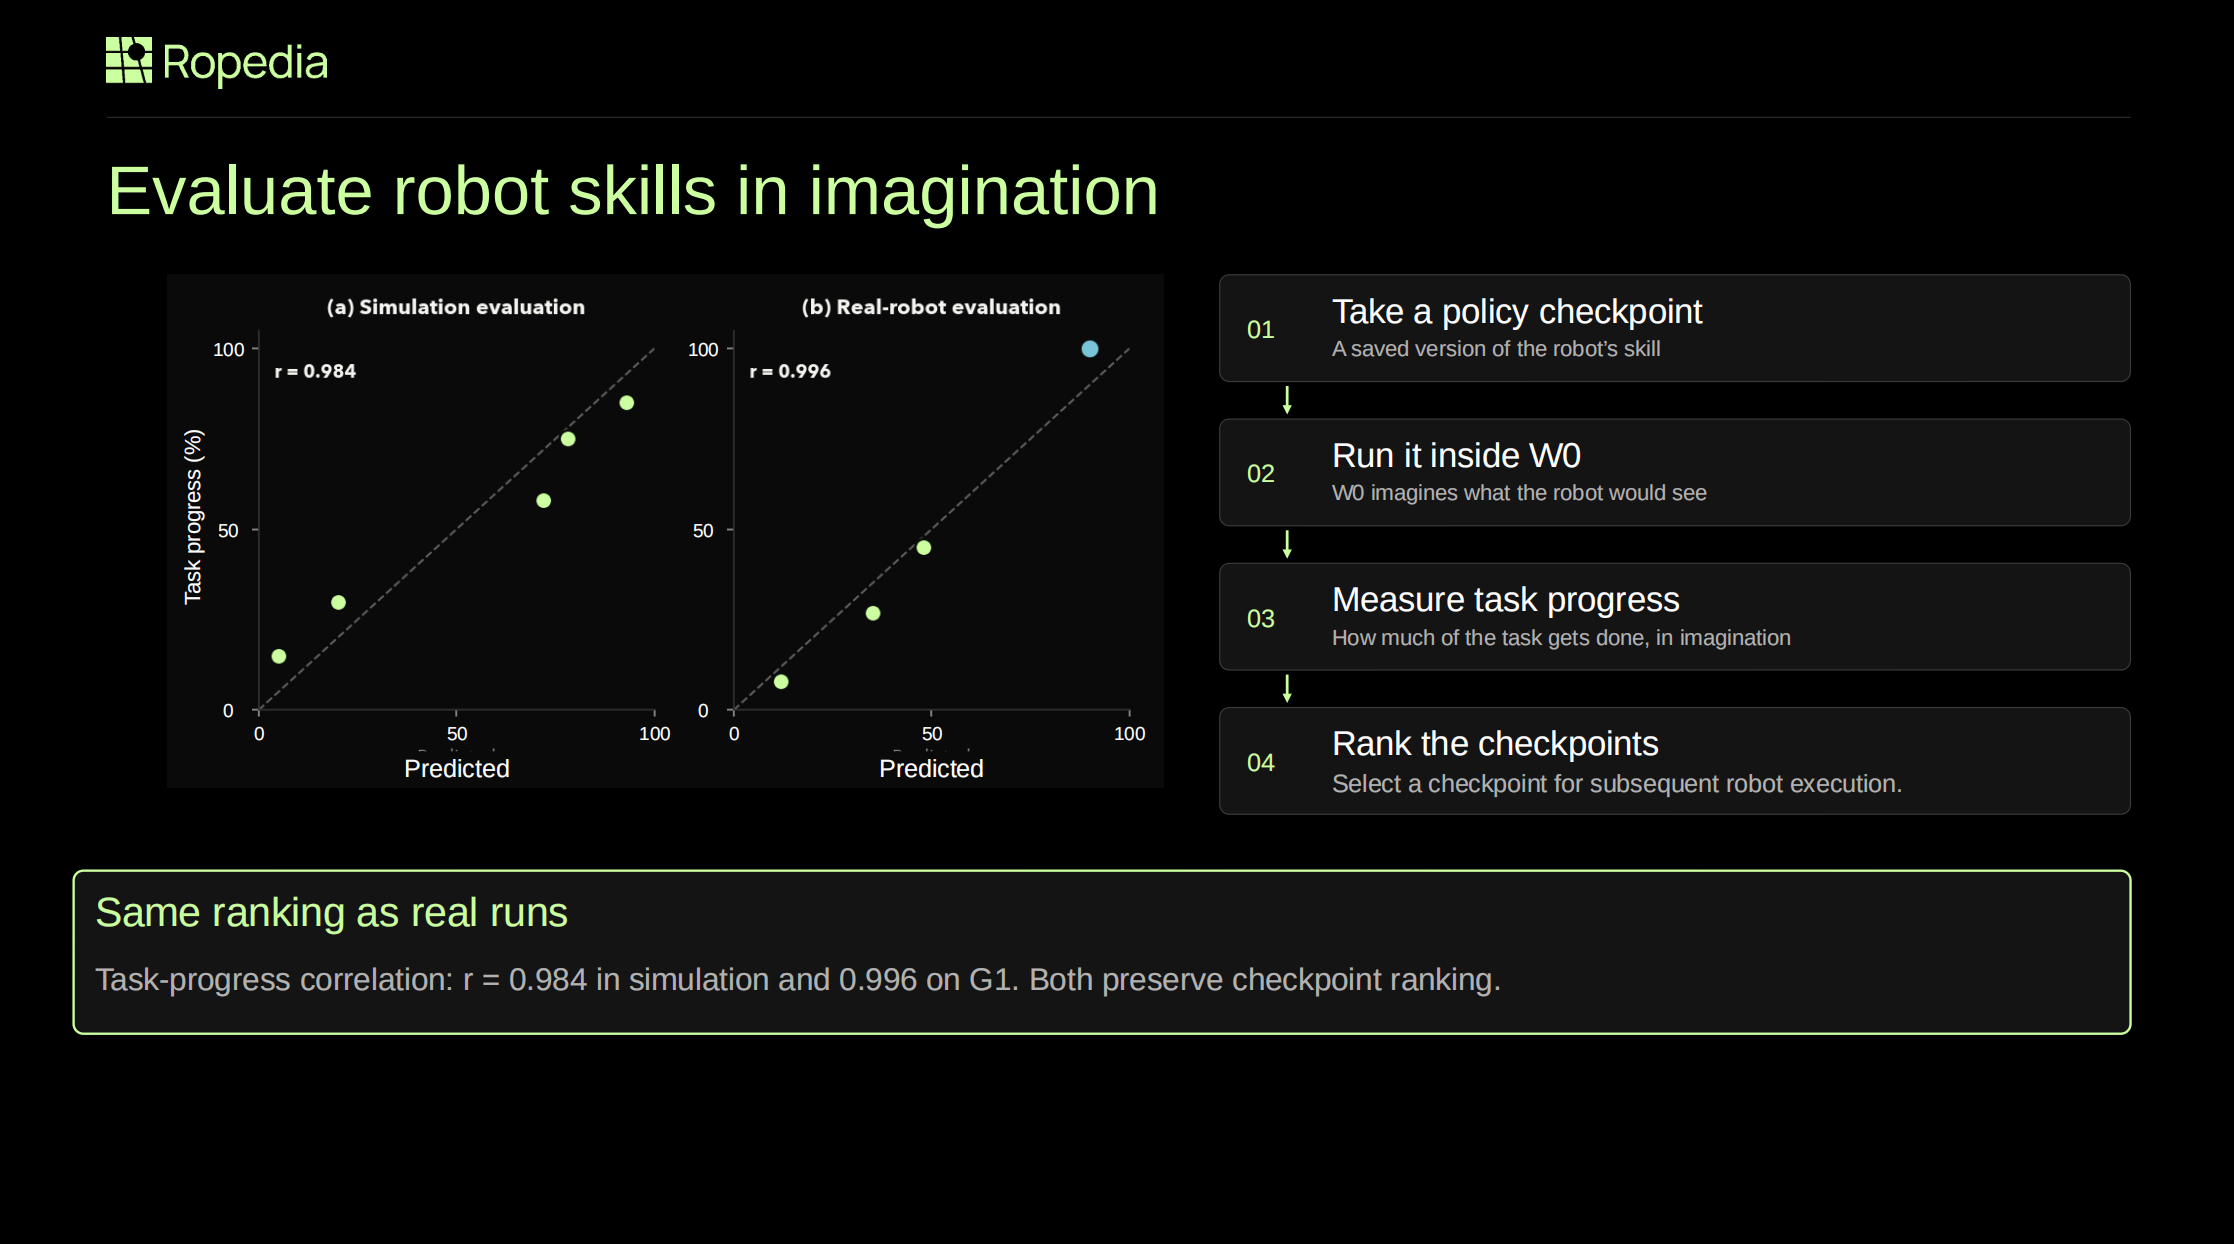
第一个应用就是说,我们可以去做评测,在世界模型的想象里面去做评测。我们这里也简单做了一个实验,就是说拿到一个 policy 一个策略的 checkpoint,我们会把它放到我们世界模型里面去跑,世界模型就可以想象出机器人执行时会看到的画面。
我们可以根据模型想象的画面任务完成了多少,和它真实去执行对应的 action 有没有完成任务或者任务的完成的进度怎么样,来做一个排名和这种类似于给它画一个拟合曲线。
左边是展示了我们模型预测和真实结果放在一起比的效果,纵轴是代表的是任务真实的完成的进度,然后横轴代表是模型它预测的进度。然后越靠近对角线,说明就越成正相关,说明是越好的。我们在仿真 simulation 和真实数据真实的评估上分别做了两条曲线,在仿真上相关系数是 0.984,在真机上是 0.996。说明对于不同 policy 的 checkpoint 的排名是和真实测试完全一样的。说明咱们世界模型对于这个机器人评测,是和在模型内部评测和在真机上评测,它们两个的相关性还是特别高的。对机器人的帮助也是之前说的,不需要真实在机器人上部署去测试,而是可以在模型内部去做一些提前的评测,就能够知道 policy 的好坏。
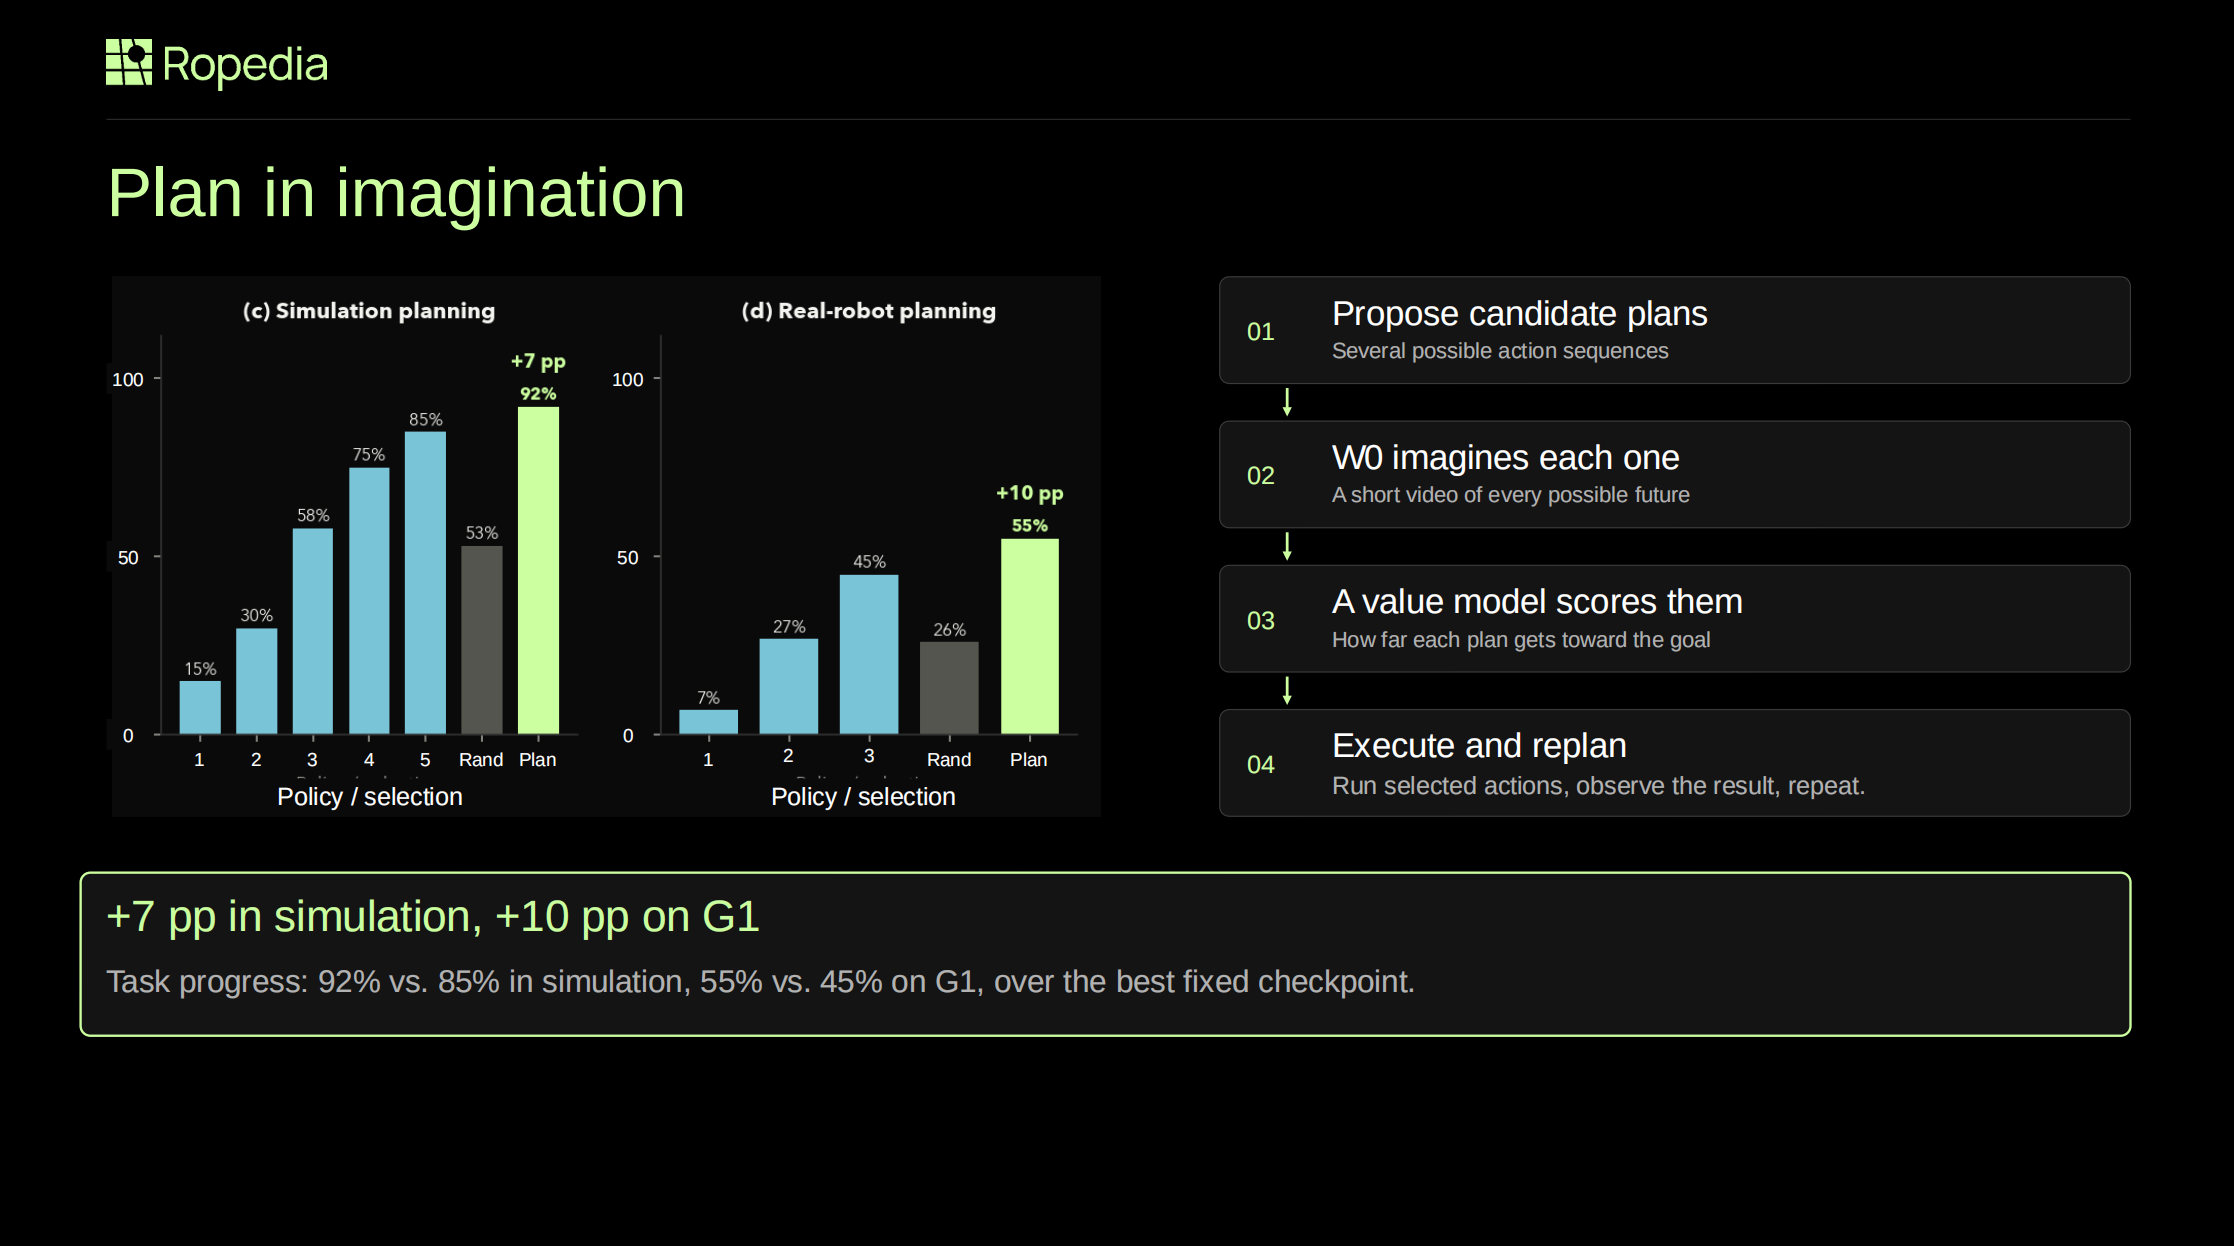
第二个应用场景就是在模型想象里面去做规划。这里的 setting 我们先给几个候选的动作序列,让模型去对每一个动作序列去想象这个序列对应后续未来的一段视频,然后我们会用一个 value model、就是一个类似于评价值的 model 给它们打分,然后看哪个离目标更近,就让它模型非常争气,最后执行完再观察结果,然后再重新规划。
左边的图里面蓝色代表的是不同的单个的固定的 policy,灰色的是从这些 policy 里面随机挑一个,绿色代表是用我们模型去规划后的结果。我们可以看到,不管是在仿真里面还是在真机上,我们模型规划的结果是比最好的单个模型还要好的,仿真里面任务的精度从 85% 到 92%,然后真机上是 45% 到 55%,说明世界模型对于这个 planning 确实是会有挺大帮助的。
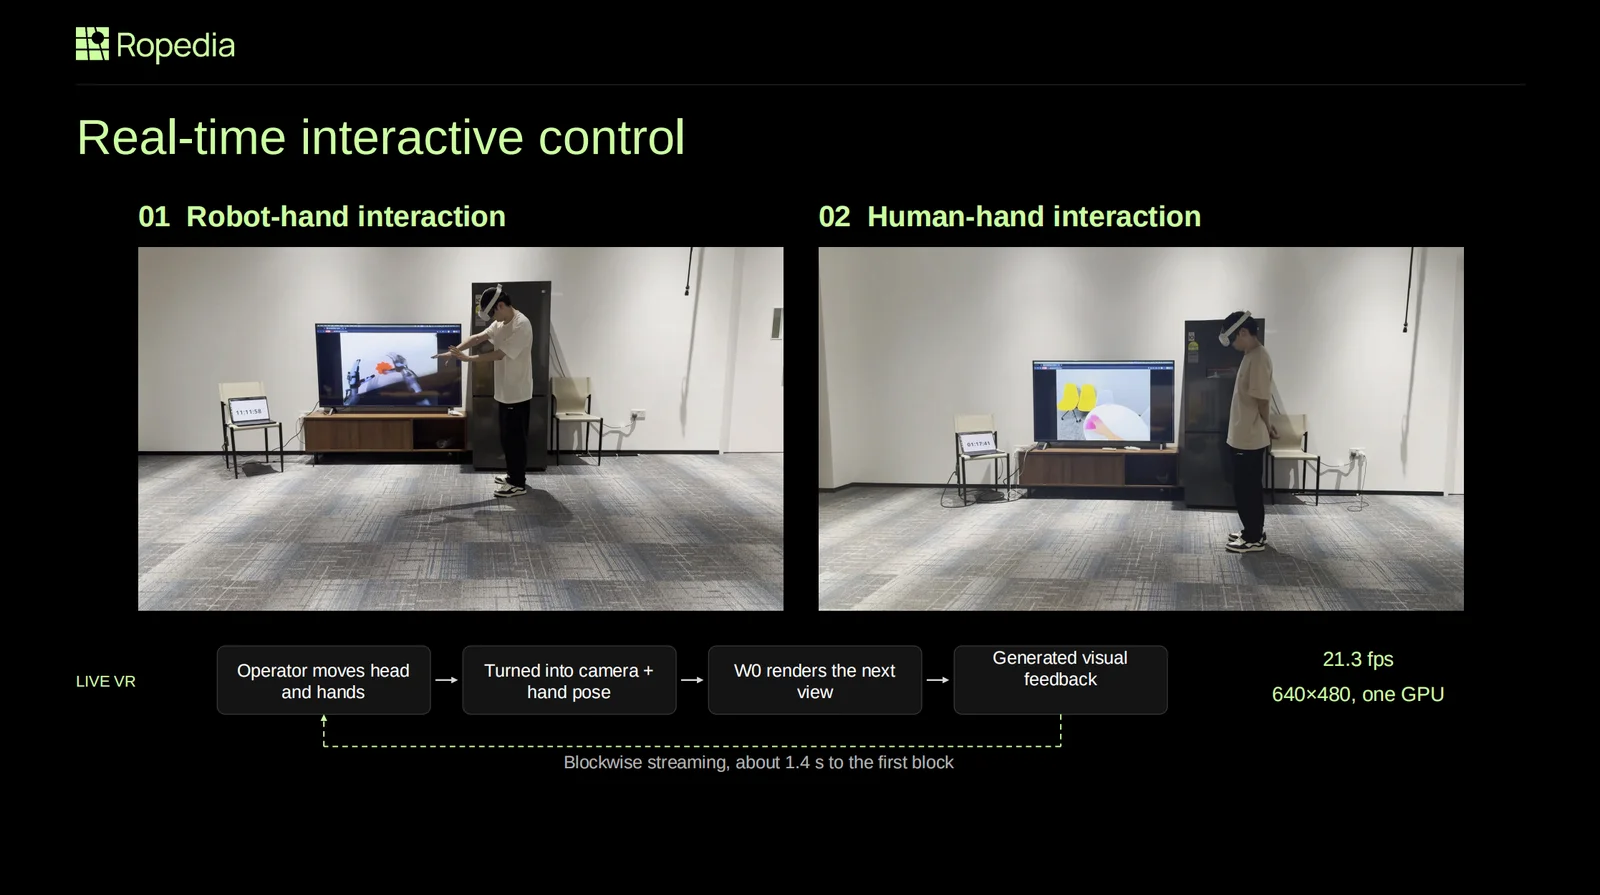
之前也提到过,我们蒸馏的模型可以做长时序、实时的交互,这里我们就做了这么一个应用。
这个操作者他可以头戴一个 VR 头显,当然我们这里用的是 Meta Quest 3,头和手的动作就可以被这个头显给实时转化成我们需要的这个 action 表征,也就是相机位置和手部的姿态。再将它捕捉到的这个位姿和手部姿态给送到我们模型里面去,我们的模型就可以根据这些去生成下一时刻的视频画面,再回传到操作者的头显里面。
这里为了给大家展示的话,就是这里接了一块显示器,显示器里面的画面就是操作者头显里面的画面。这个速度大概就单卡就能跑,速度大概是 21 FPS,用的是之前提到蒸馏出来的模型。
这里展示了两个例子,就是说不管是画面中是机器人还是画面中是 human 都可以去做一个现场的实时操作,不管是将带移动交互的都会做得比较好的效果。
这可能就意味着以后我们可能可以减少整体的需求,戴上我们的 VR 眼镜,也不需要增设场地,就可以采集一些机器人的示范数据。
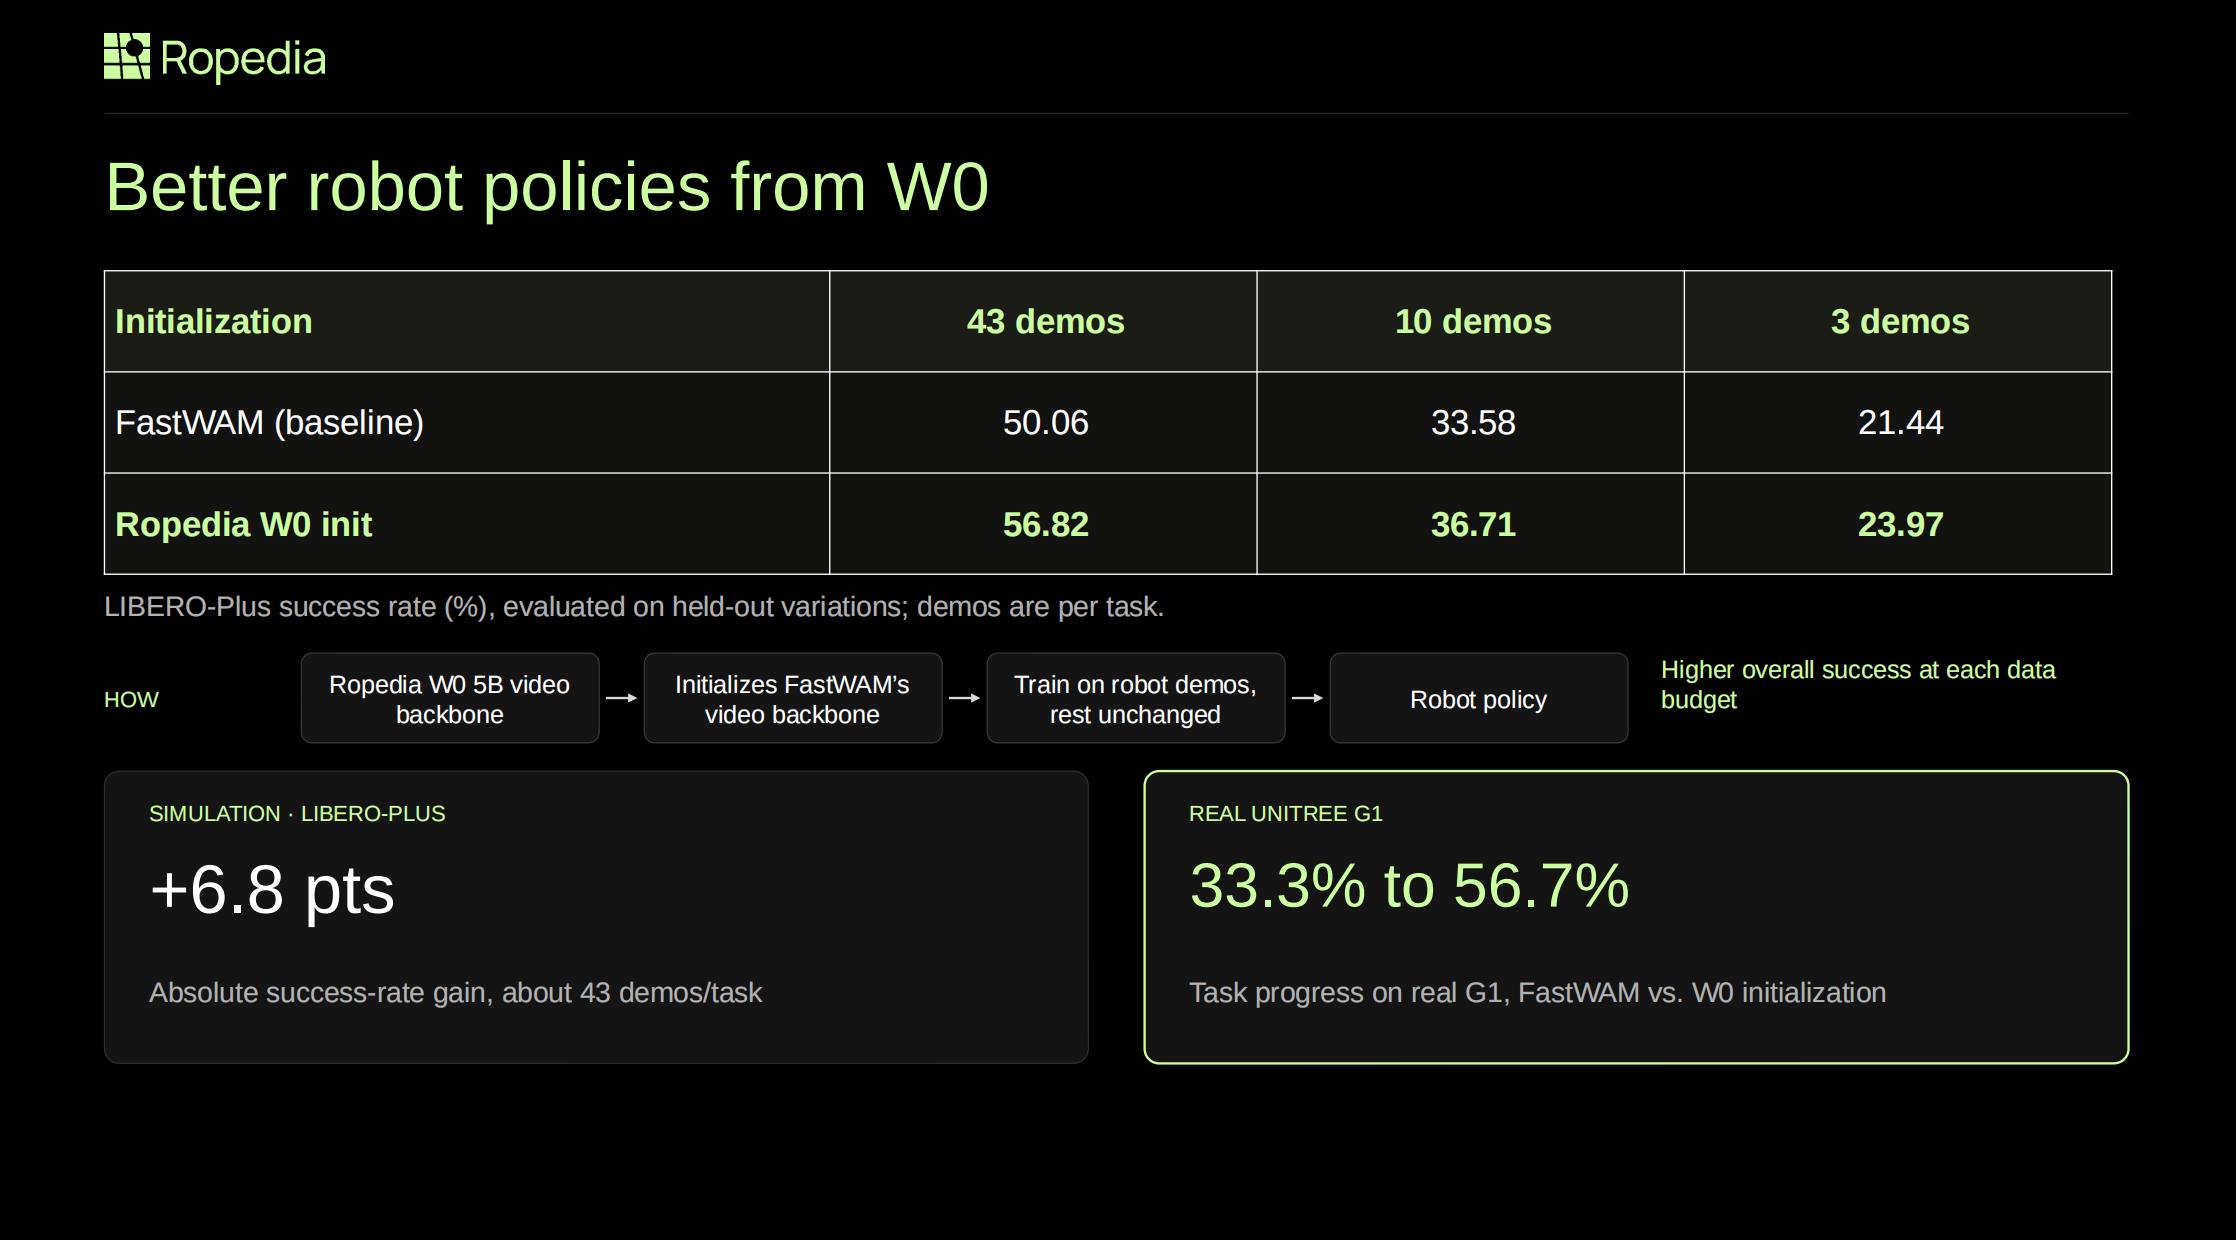
第四个也是之前最开始提到的,就是我们一个训好的具身世界模型,可以去帮助去训练更好的机器人的 policy。我们知道 Fast-WAM 它就是一个建立在视频模型上的一个机器人策略,然后这里我们把它的视频主干换成了,它用的视频主干是 Wan2.2 5B 的模型,我们把它们换成了我们训好的这个 5B 的视觉模型,其他的 setting 都一样。我们发现只换这个 base model 就可以去在不同 setting 下将这个成功率都会提升挺多的,就不管是用多少的这种 demonstration 去做后训练,用我们的模型去做初始化效果都会更好。同时我们在真机上也做了这么一个实验,对比 Fast-WAM 从 33% 的成功率提升到 56% 左右。
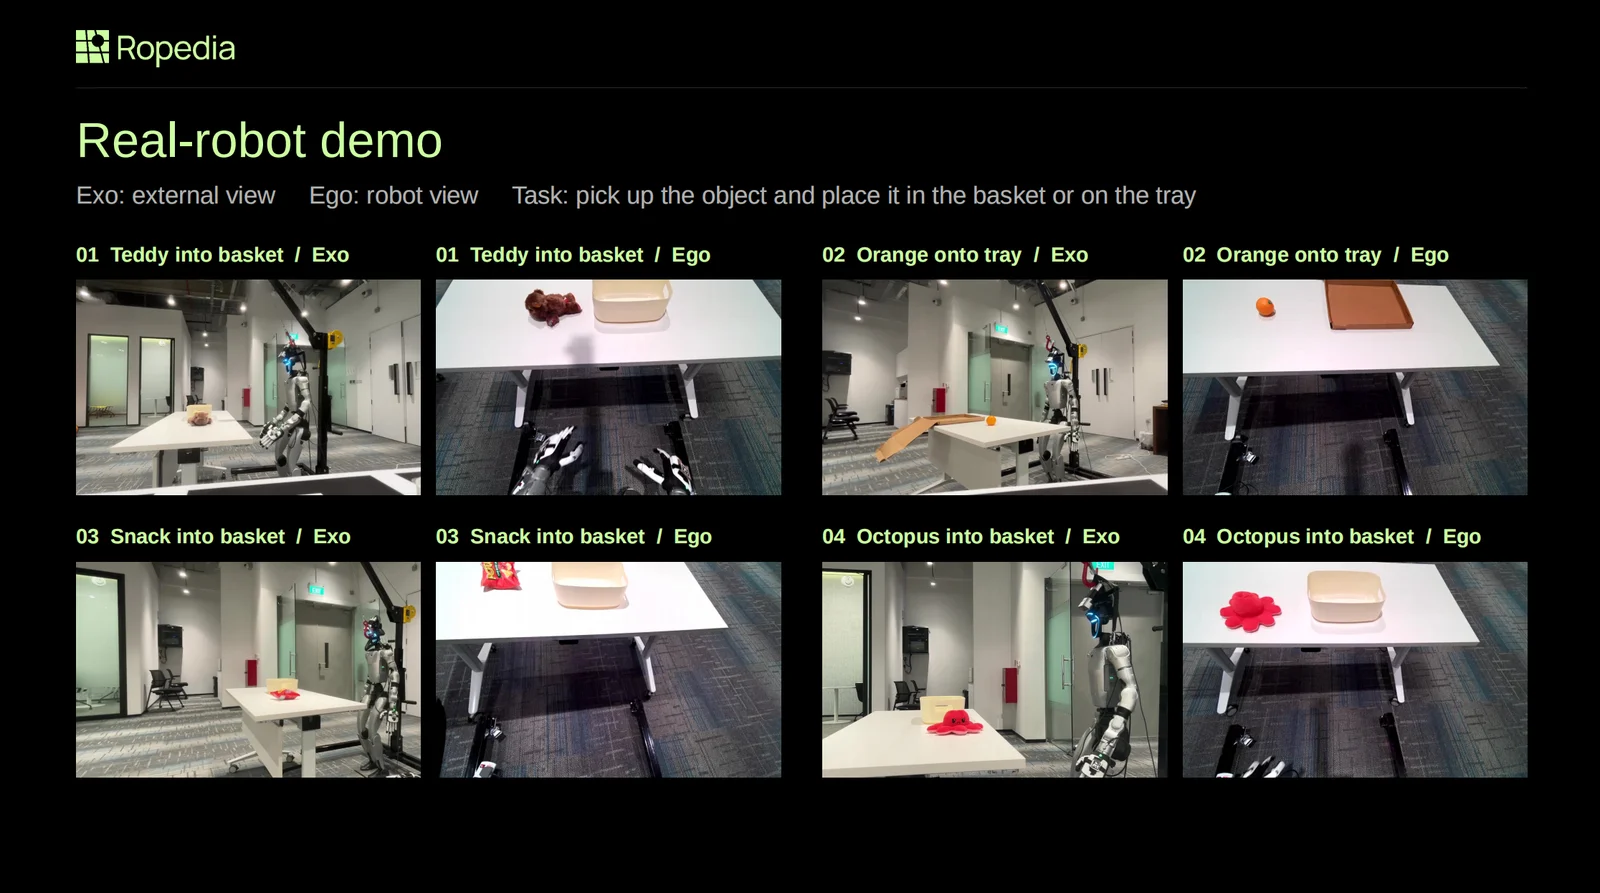
这里展示的是真机的一个视频效果。它做的是一个简单的 loco-motion,然后 pick and place 的一个任务。我们用少量的数据微调的模型,它就可以去比较好地泛化到不同的物体以及不同的摆放。
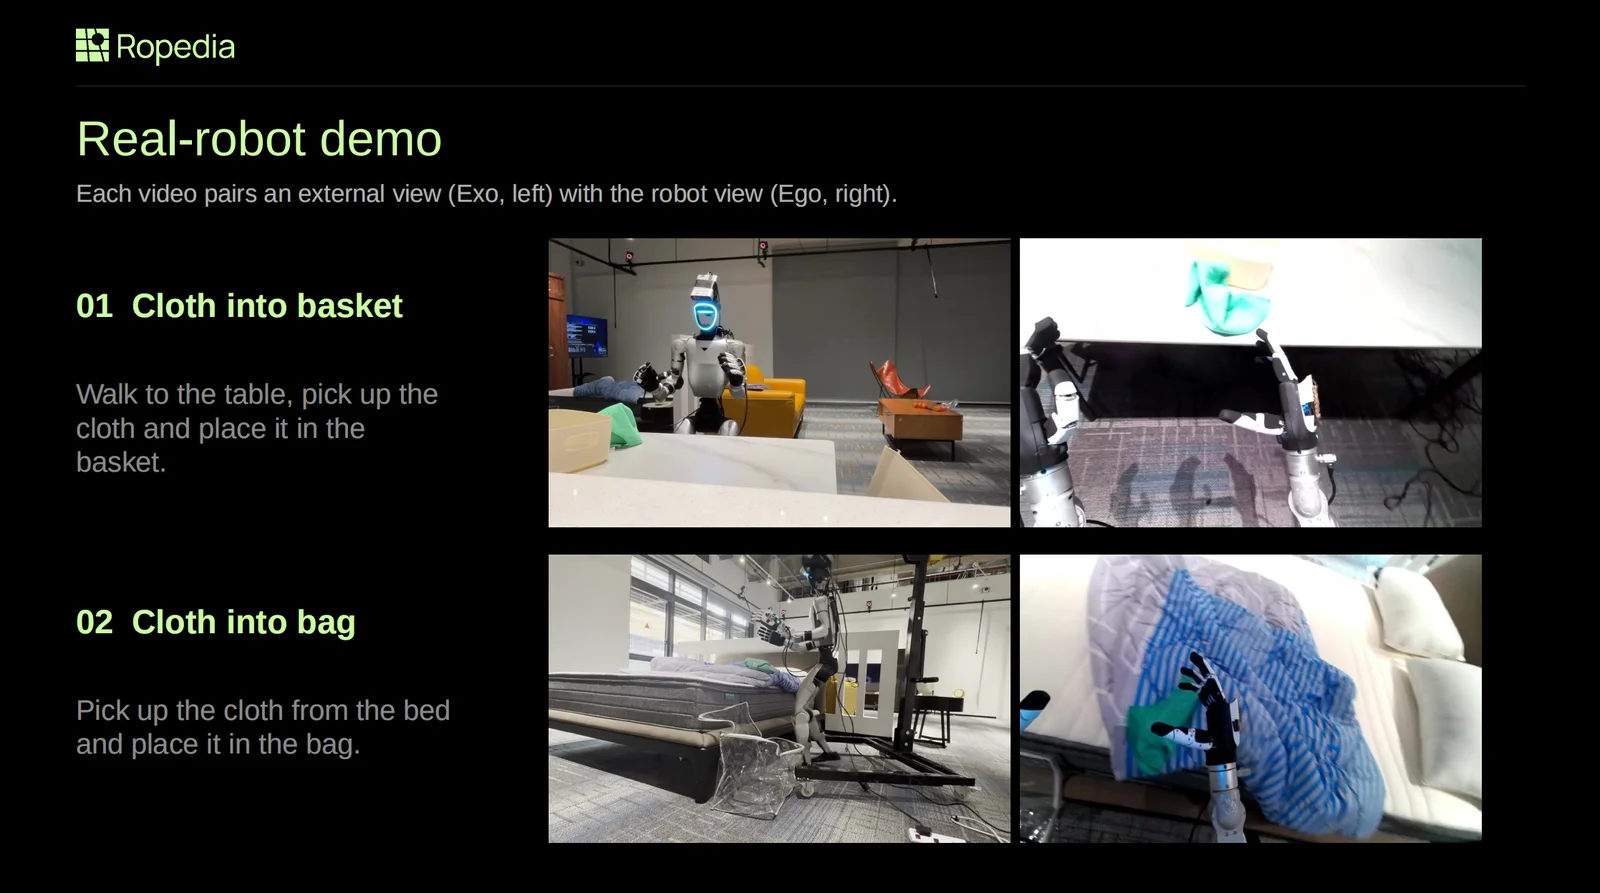
更多的一些例子,它需要把走动和操作结合起来这些例子。第一个是走到桌边,拿起这个抹布稍微擦一下桌子,再把这个抹布放到前面的篮子里面去。下面一个就是也是往前走,从床上拉起这个抹布,然后放到左边旁边袋子里面去。
七、局限性与未来方向
对于结果和应用的部分就是这些,最后简单和大家聊一下,我觉得后面还可以去做的几个方向。先说两个就是我们模型自己的一些局限性。
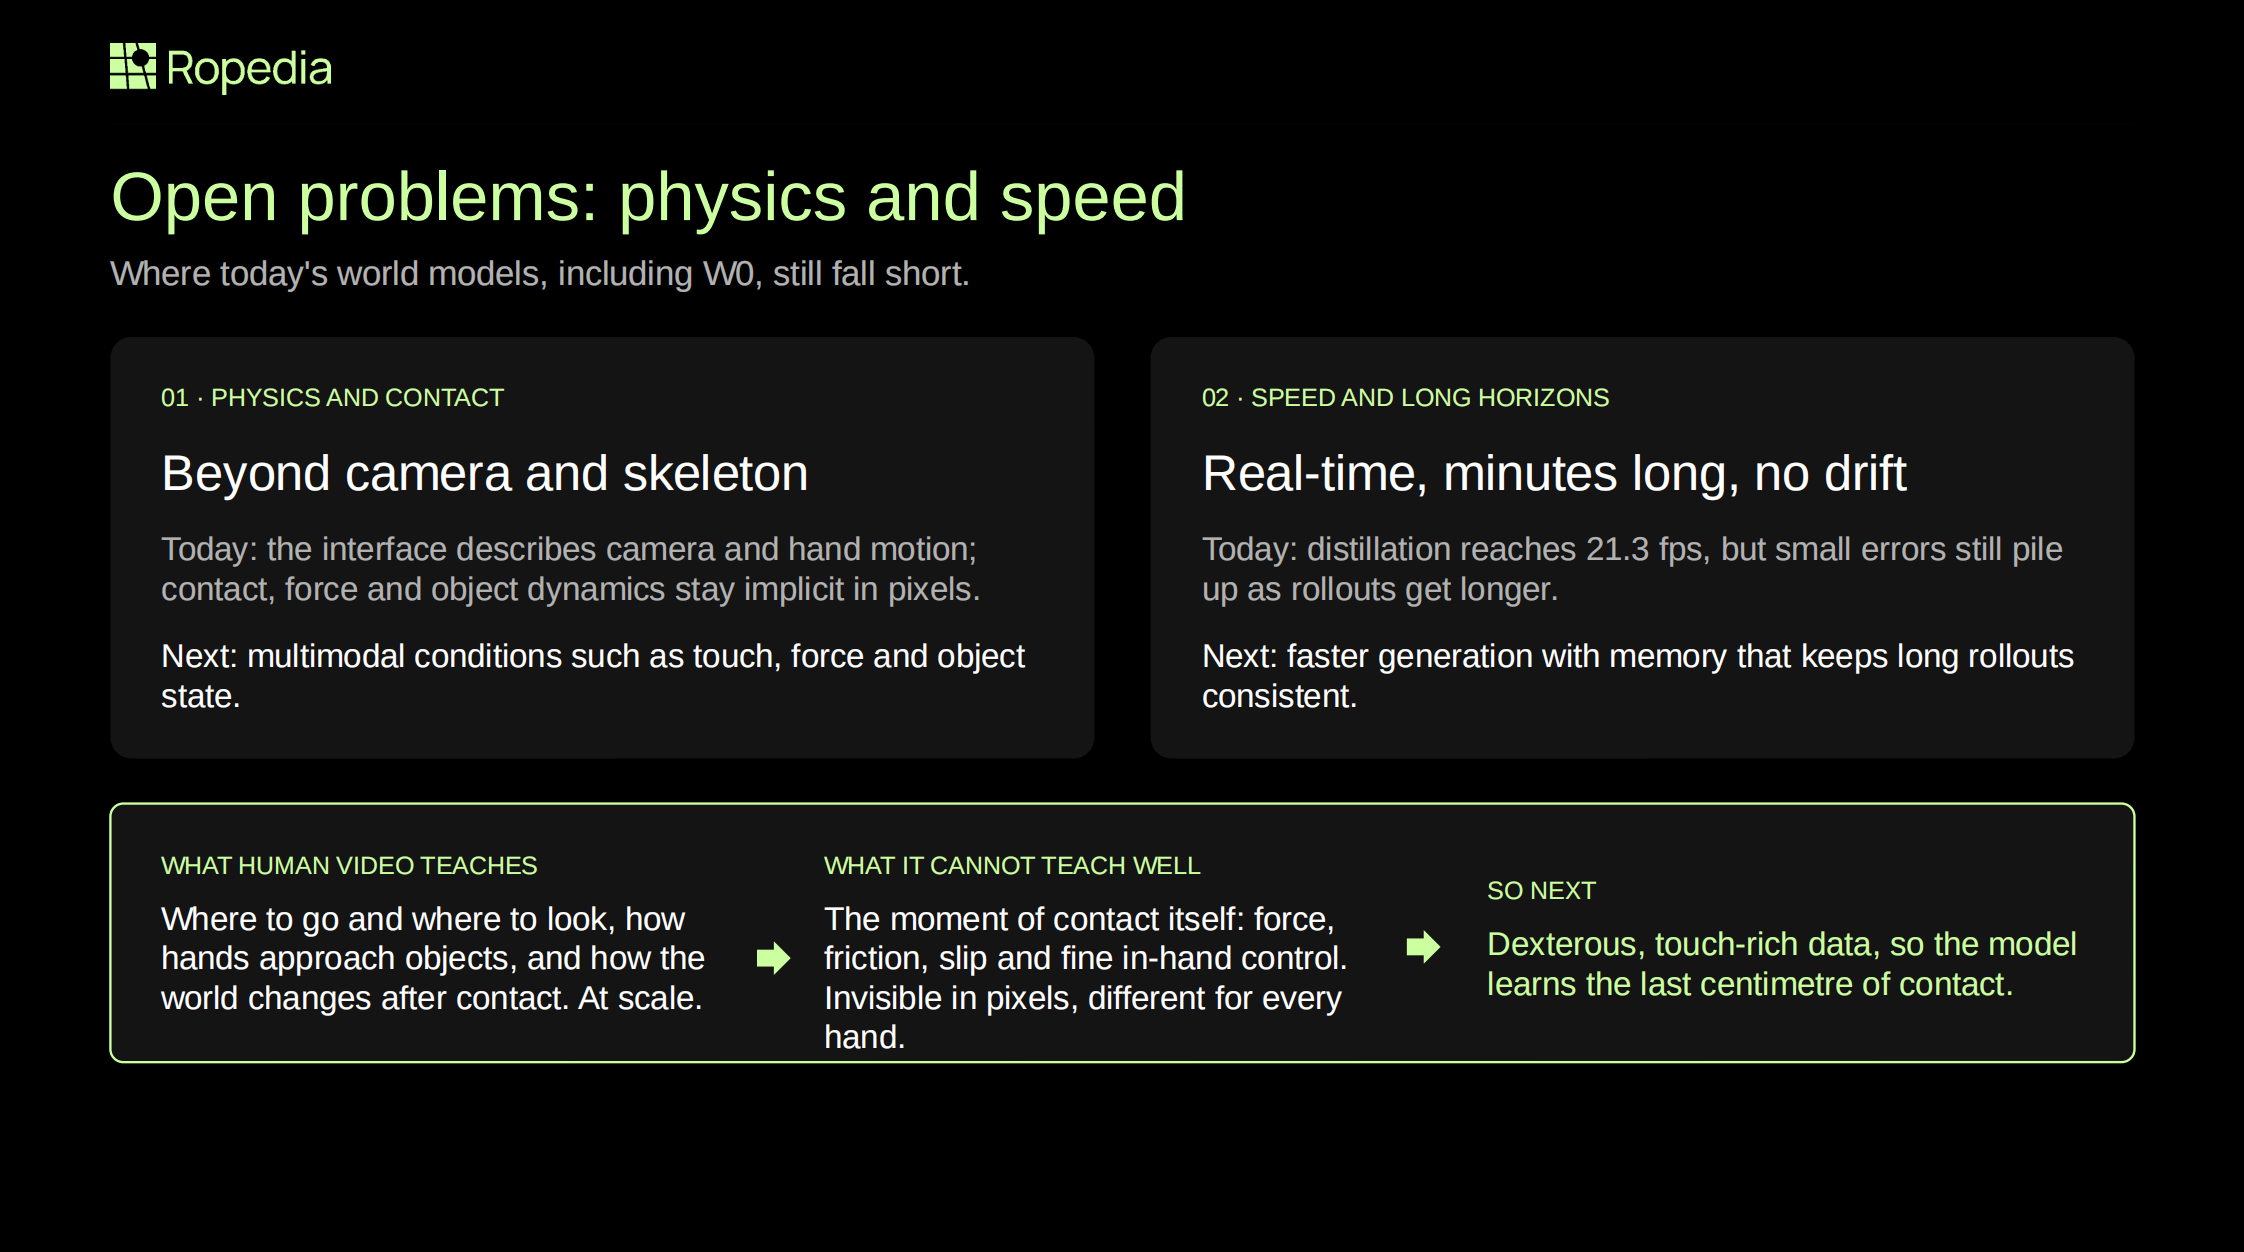
第一个是物理和交互,我们现在接口描述的是相机和手怎么动,接触或者说受力和物体本身的动力学都还隐藏在模型或者说它预测的像素里面。所以一个很自然的方向是怎么把更多模态放到 condition 里面去,比如触觉、力或者物体的状态。遥操采的数据集上已经记录了很多模态,所以其实可以作为一个尝试的起点去探索这么一件事情。
然后第二个是速度和长视频生成的问题,就是说蒸馏之后我们的模型可以做到单卡 21 FPS 这么一个实时的效果,可以做到 1 分钟或者接近 2 分钟长视频生成,但是我们要去进一步提高它的实时性、视频生成长度仍然是一个很有挑战的问题,因为之前说到的这种误差累积的问题,以及各种场景和 memory 的问题。那怎么让生成更快,同时让模型记住前面发生过什么、前面之前走过的场景长什么样,并且长时间保持一致,是接下来可能特别重要的一个问题。
对于人类的数据的话,它能够交给机器人的是去哪里、或者说看哪里、手怎么去接触接近物体以及交互之后世界状态会怎么变化,而且这个量是很大的,这个 human data。但真正执行交互的那一下,也就是说这个受力或者说摩擦打滑,或者说手里的细微调整在像素里是几乎看不到的。人手和机械人手也不一样,所以单靠视频或者说视频通过算法标注的一些模态,确实这一点是很难教会的,所以可能接下来对于灵巧精细带触觉的数据可能也特别关键,它也可能是去补充接触最后一公里比较关键的数据。
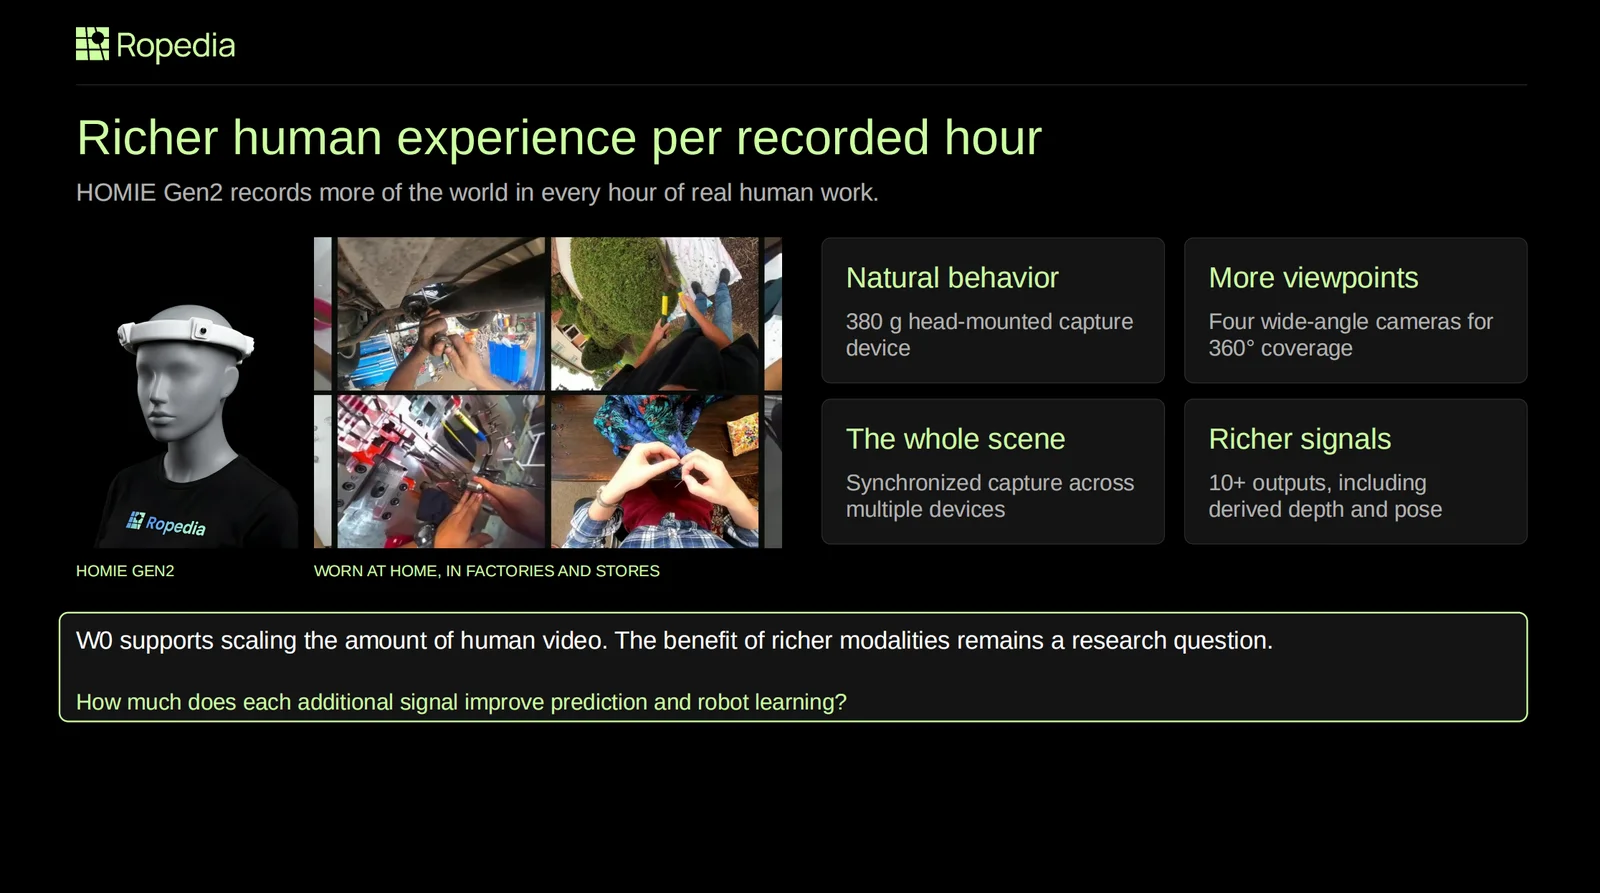
还有一个方向就是和数据有关,就是我们在做这个项目的时候也发现我们的模型可以说明人类视频越多、模型就会越好,那其实我们对于人类视频或者说对于这种广泛的数据的关注,现在大部分还停留在长度上,也就是说它有多少个小时、有多少量。但是其实我们这边也会去关注它的所谓的这种厚度,就是说对于同一个小时、每一个小时的数据,它如果有更充足更丰富的标注,那会不会更好。
我们之前也提到过,我们采集了 6000 多小时的数据,也是用HOMIE GEN2去采的,人带着就能正常工作,录到的是人自然的行为,它有四个广角相机能做到 360 度覆盖,多台设备也可以同步记录同一个场景,可以输出十多种信号,包括深度、姿态等等的信号,都是同步在同一个时间戳上的。
不过更丰富的模态到底能给预测或者给机器人学习带来多少提升,目前可能还是一个开放的问题,也希望和大家后面一起来探索。
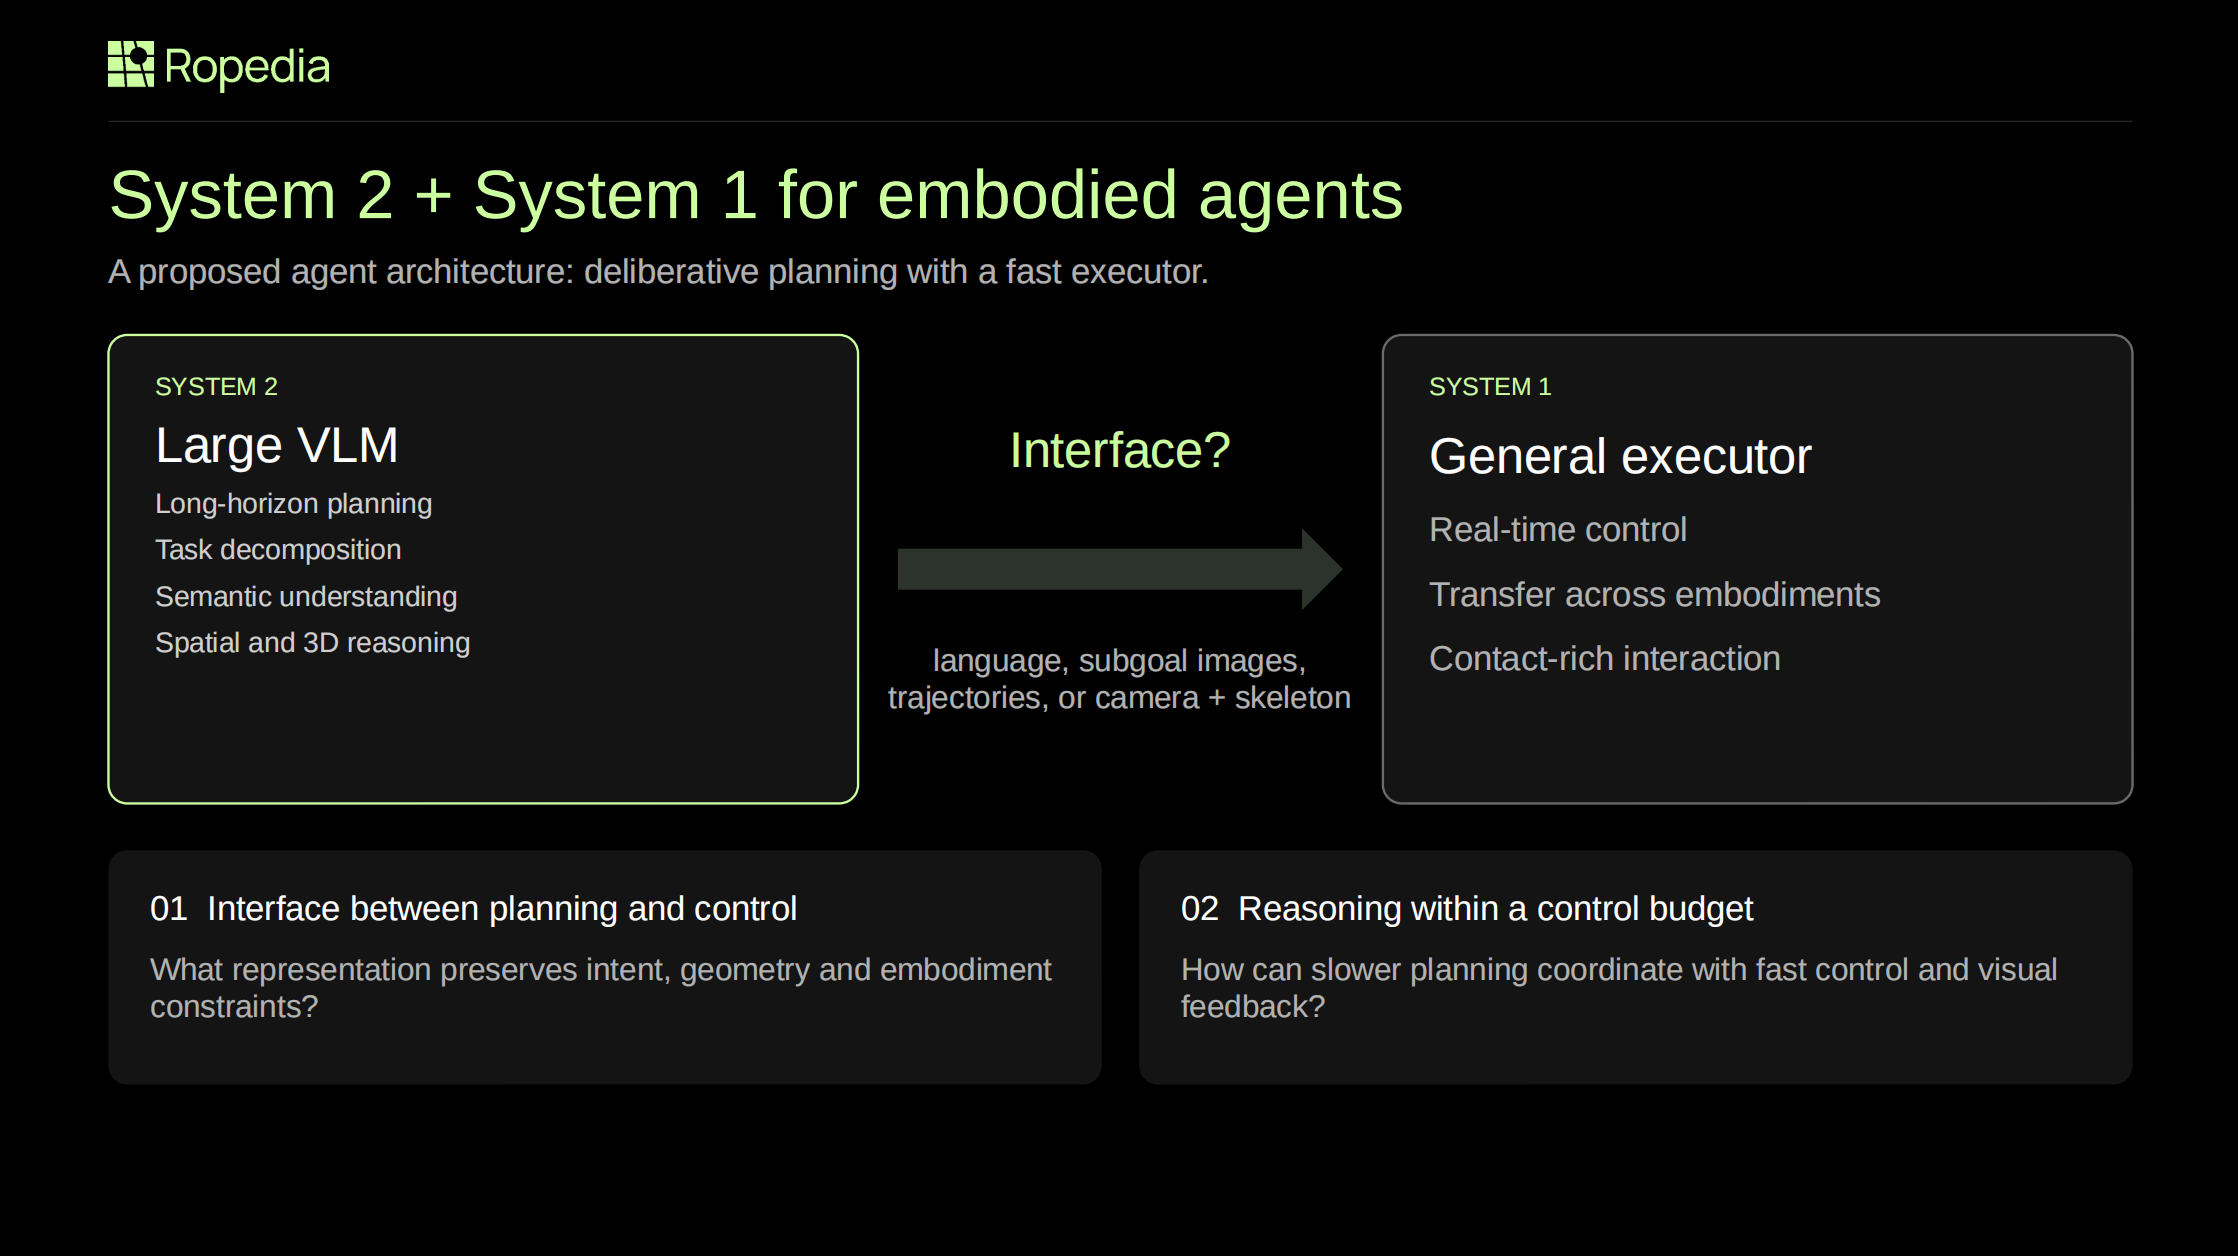
再往大一点看,另外一个我觉得很重要的方向就是 system 2 和 system 1 是怎么配合。就现在比如 GPT-6 Astra 出来之后,现在大的多模态模型能力越来越强,长程规划、任务拆解、场景理解、语义理解、空间和三维的理解,可能这些都可以交给 System 2 去做。咱们如果要去说这种 System 1 的话,它的定位可能更像一个通用的执行器,就负责实时地去控制不同的身体。
这里可能主要有两个开放的问题,第一个是 System 2 到底应该给 System 1 做什么样的 interface,就怎么样接口?语言的话可能会太粗糙了,如果直接给关节指令,又会跟具体的身体绑定得太死。中间也许可能是子目标图像轨迹或者像我们现在所使用的相机加骨架这么一些表征,当然还需要大家后续一起探讨。
第二个是 System 2、然后现在这种基模能力虽然很强,但是模型比较大、很大,然后推理的话会比较慢,具身这个领域对于控制、对实时性的要求很高,怎么样在两者之间取得一个平衡,也是一个后续比较大的开放问题。比如在一个家务的任务里面,System 2 可能几秒钟才更新一次计划,而 System 1 每秒需要去输出几十次的控制,两边的节奏怎么配合得起来,也是可能比较值得探究的一些问题。
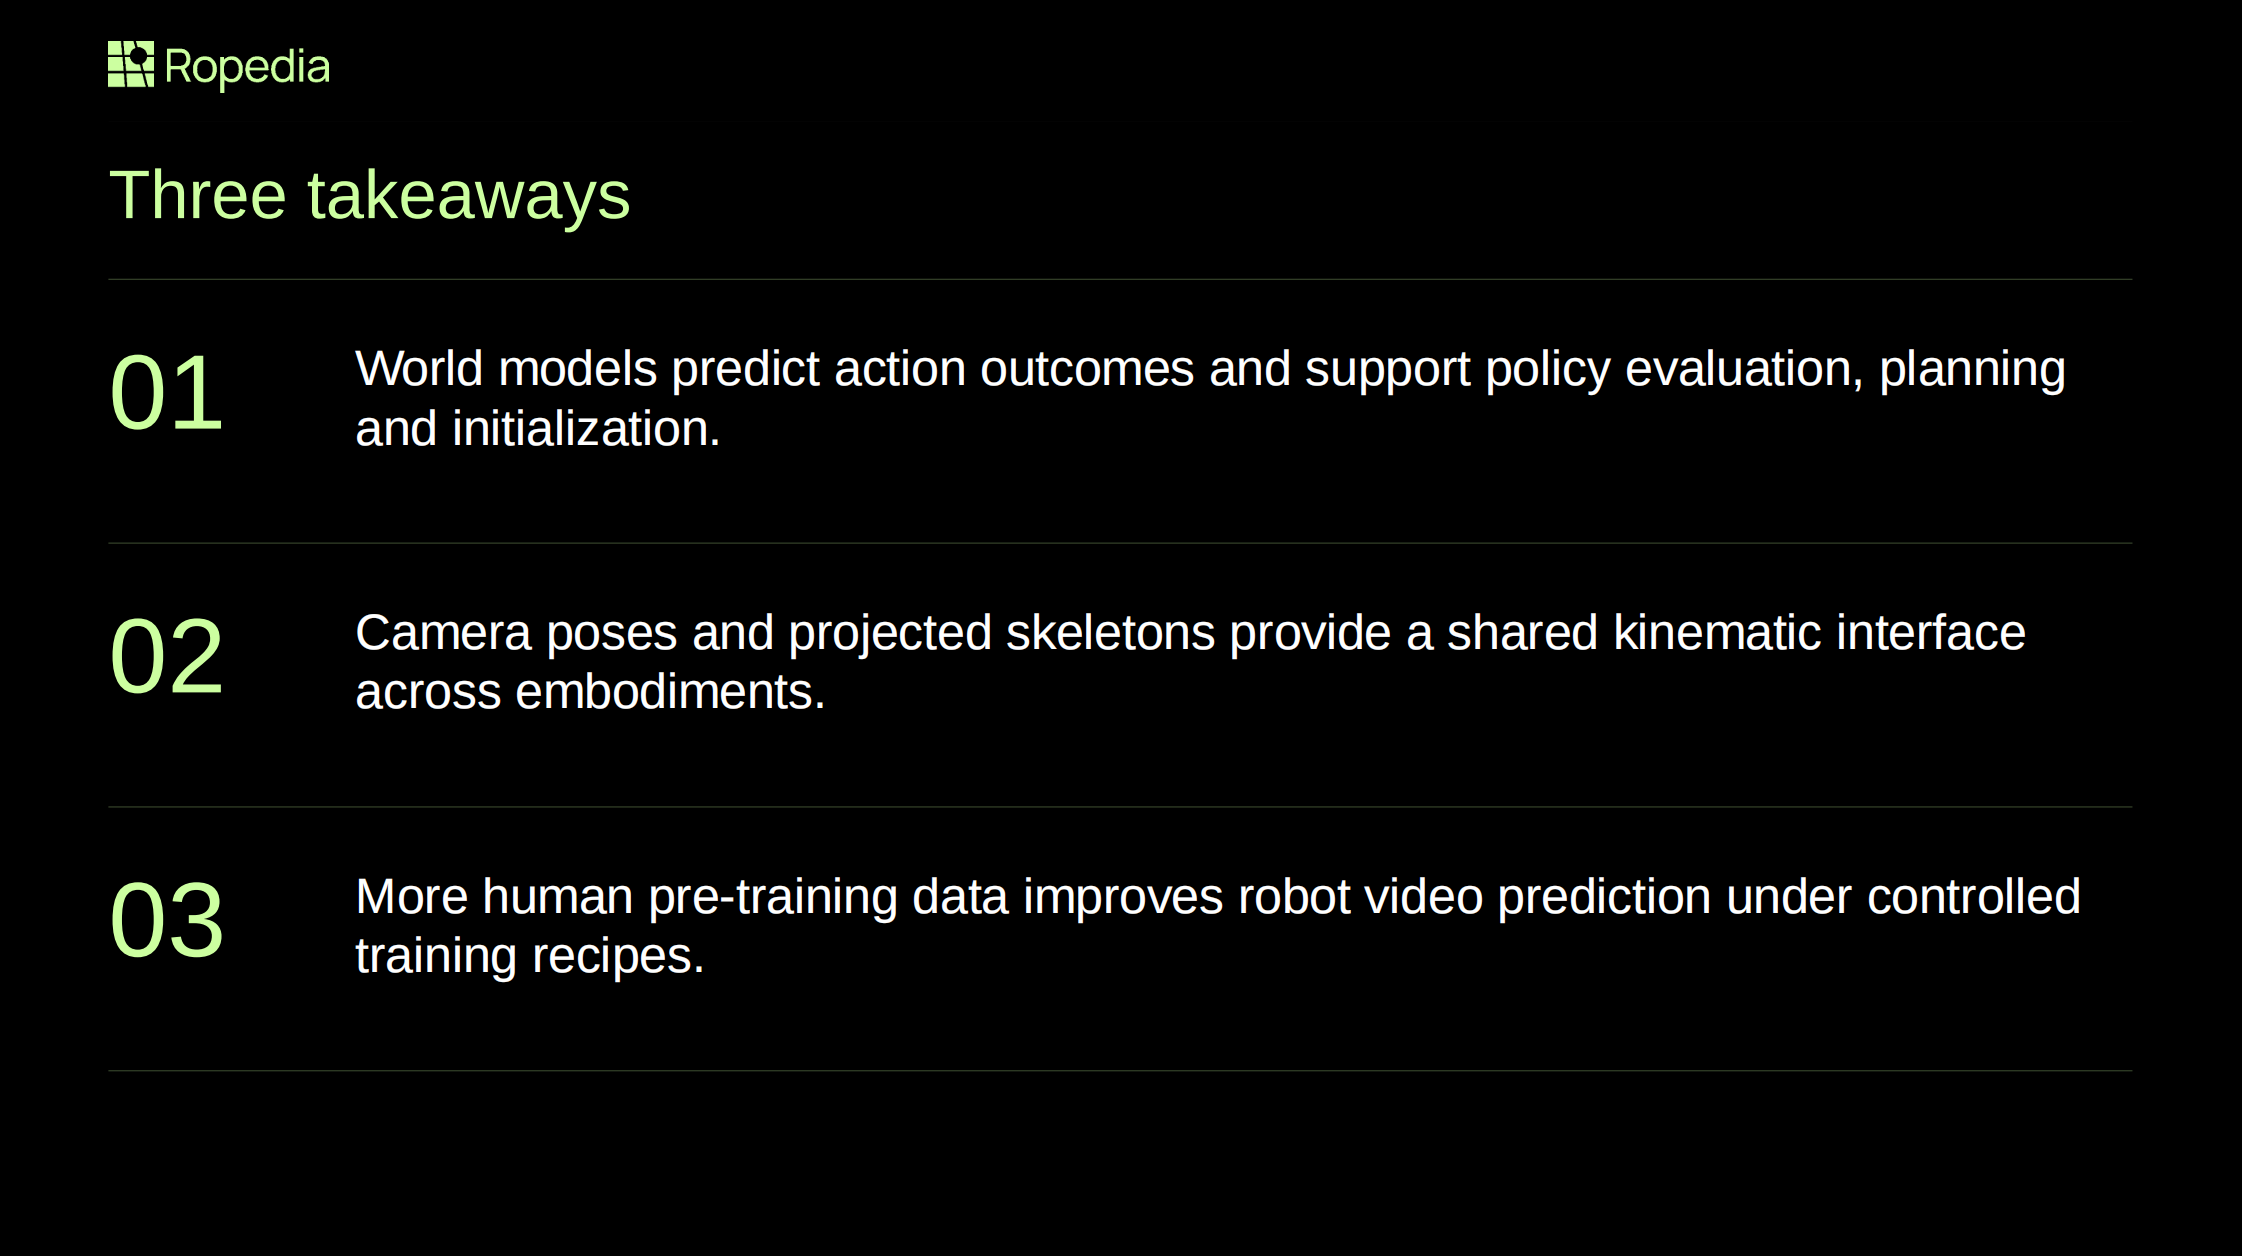
最后简单总结一下今天的分享内容。第一个是世界模型可以去预测动作结果,并且可以去赋能于机器人的学习,包括策略的评测、规划和训练。第二个是我们的工作是用相机位姿和投影的骨架来给不同的身体、不同的机器人本体提供了一套共享的运动学接口。第三个是我们发现随着人类预训练数据的越来越多,它也能够比较好地赋能于机器人的学习。
我今天的分享到这里,谢谢大家,也谢谢青稞社区提供的这次分享的机会。
AMA 互动环节
Q1:人类数据的 scaling law 有边界吗?如果持续增加人类第一人称视角视频,机器人能力是否会持续提升?
A1:对于这个问题,我的理解可能就是说人类视频它确实能够教会模型,或者说它能够赋能于机器人学习的某一些方面,但它还是会存在自己的一些局限性。它能够教会模型,比如我们这个工作里面提到的,怎么样去跟随你给定的动作,然后你动作执行后这个世界的状态会怎么变化,可能是人和机器人可以去比较好地 transfer 的。但是至于它有没有边界的话,这也是一个很开放的问题,因为目前不管是大厂还是创业公司,他们目前展示出来的资料最大也就展示了 100 万小时的人类数据下机器人性能的 scaling law 的一个曲线。人类数据我们增加到 1000 小时、1000 万小时或者 1 亿小时,会迎来一些质的飞跃,这个可能还是值得探究的问题。
但是正如我刚刚分享中讲到的,对于一些具体的交互的细节,就是说它的力反馈、受力以及机器人能不能像人一样比较聪明地去调整、面对这种打滑意外的情况,可能还是人类视频很难去教的,可能还是需要依赖于机器人自己,不管是仿真里面还是真实世界里面做一些强化学习的探索才能去习得的一些技能。
Q2:这两类数据的比例有什么讲究吗?
A2:我理解这个问题的意思可能就是说,因为我们训练分为两个阶段,第一个是只用人类数据训练,然后第二个是用人类加机器人数据做一个混合的训练。这个问题可能就是说在第二个阶段,用人类数据和机器人数据它们的比例去训练有什么讲究吗?这里我们其实没有去做一个超参的实验,就是说到底人类数据和机器人数据用不同比例,比如 1:9、2:8 这种 setting 下它性能具体怎么变。这里我们的一个基本的 insight 就是说,由于我们预训练是用的 human data,所以如果我们在第二个阶段 mid train 的时候只用机器人数据的话,它很难把预训练阶段的人类的学到一些经验给比较好地 transfer 到机器人上。所以我们在这种 mid train 的时候既用了人类数据,又用了机器人数据,就是说它既让它保持预训练时候学到的人类数据的一些带给他的一些经验和技能,然后又能在微调的时候比较好地 transfer 到他没见过的、不管是机器人还是各种本体上的一个效果。
Q3:人类经验迁移到机器人的是物理知识还是视觉运动模式?
A3:可能是跟第一个问题的回答是类似的。它能够交给机器人,就是我的动作是怎么去跟随,然后我的动作跟物体发生交互之后,这个物体和世界会怎么变化。所以视觉模式和视觉状态的物理变化知识还是可以去比较好地 transfer 到机器人那边的。对于精细的操作,它和物体交互的那一下,可能是光靠人类视频很难去教会的,还是可能得依靠机器人自己做强化学习来学到。
Q4:如何衡量有效数据量?
A4:这里可能是问的是对应我们分享里面的数据处理那一部分吧。对于我们这个工作来说,有效的数据量我们会做很多筛选。第一个是在预筛选阶段,我们会将一些对我们想要学习的这个目标无关的一些数据给删除掉,比如说我们其实想要学习的是它和物体交互的一些技能,所以我们重点保留它和物体有交互、有手物交互的一些视频数据,同时它也有视角变化,因为我们也想要去学习这种 loco-motion。对于那种比如说我就坐在桌子前、然后手也没怎么动的这么一些数据,我们就选择将它给 filter 掉,就不保留。然后这里有一条数据对应,我后面讲的就是说我们去看待这个数据的角度,可能不光是它的长度、小时数,然后也包括它的这种厚度,它各种模态的标注是否完整、是否统一到同一个坐标系或者说时间戳。
Q5:对于视野之外的操作,双手协作、精细触觉反馈和失败经验数据能涵盖多少?
A5:这个问题也是个挺好的问题。因为我们现在用的是视觉的表征,视觉的表征就注定它只能去建模它视野内的一些运动。比如说我们用的 skeleton,它就是会投影到和图像 pixel 对齐的这么一个表征,所以在图像外、它视野之外是怎么动的,理论上来说 skeleton 它是没有能力去作为一个条件去 condition 去建模的。但是对于机器人,我们刚刚也提到,对于机器人来说,由于它的 skeleton 是不需要通过视觉算法去检测的,它是通过机器人自己的 API、URDF 可以直接投影拿到,所以即使相机视角没有观测到的区域,这种画面外的 skeleton 我们也是可以拿到的。然后我们的模型的 pipeline 里面也有这个建模视野外物体操作的一些方法,就是说我们会除了会注入和图像同一尺寸 pixel-align 的 skeleton 到模型里面作为 condition,我们也会注入一个更大 FOV、就更大视野的手和手臂的 skeleton 作为 condition,作为一个可选的 condition。当然这个可选,因为对于人来、human data 来说是比较难拿到的,只能靠模型自己去猜,但对机器人来说它是确定的,所以这个可以对于机器人来说,更大视野的一个更大 FOV 的一个 skeleton map 是可以作为一个额外的 condition 注入到模型里面去帮助模型去建模它在视野之外的一些操作、反映在视野之内的内容。
比如一个例子,我们之前测过的一个例子就是说机器人的手在图像边缘的外面,但是它图像边缘是有一个瓶子的,然后机器人往往往画面内推一下瓶子,然后瓶子就会往里面走。如果我们只看图像内部的话,可能就是一个瓶子莫名其妙地往图像中央靠了一下,但是由于我们建模了视野更大、视野 1.5 倍视野 FOV 下的一个手的运动,所以这个时候模型是可以去预测图像边缘上是有手的 skeleton 的,然后它手的 skeleton 对应的 action 是可以影响图像内的一些状态的。
Q6:这种收益究竟来自于数据规模还是任务还是数据多样性?如果给你们同样的 1000 小时的预算,是增加已有任务的重复数据,还是采集全新的环境、物体和操作行为?你们有没有观察到数据多样性比单纯增加时长更重要?
A6:这一点也是很好的一个问题。对于数据的 diversity,实际上我们是有统计的。我们对比了我们的 Xp-Data 就 10000 小时的数据和目前别的工作或者别的公司公开的一些资料来对比,我们的数据在不管是场景的 diversity 还是任务的 diversity 上都是有很明显的优势的,这也是对应着我刚刚在分享中说到的,就是我们不单单关注视频的绝对时长,它到底有 10000 小时还是 100000 小时,同样我们也去关注每一条数据它到底有多少丰富的标注,同时它所有的数据里面的场景的 diversity、任务的 diversity 也是另外一个维度。
对于这个问题来说,是增加已有任务的重复数据,还是采集全新环境和物体操作的行为,这可能就对于不同应用场景有不同的需求吧。如果你想是想去训一个适用于工厂的,那就在同工厂环境,然后工厂内的事情可能大概也是差不多那几件事情,就给它重复数据就行了。但是如果我们是想目标是一个通用泛化的话,那我个人觉得还是采更加 diverse 的环境、任务、物体操作的这种数据会比单纯增加时长会更重要。
Q7:统一表征会不会掩盖本体差异?
A7:这里我理解的是,我们统一的表征相当于可以这么理解:不同本体它的差异肯定是存在的,然后我们相当于是找到一个 shared 的一个共享的中间的表征,将不同本体的原始的一些 action 给映射到中间的这么一个共享的表征。就具体来说是这样,skeleton 也好、别的也好,然后这种统一的表征,然后再去注入到模型上,其实在同一个表征,它也是通过原始不同本体的原始信号给映射过来的。所以对仅对世界模型来说,统一表征是不会去掩盖本体差异的。
Q8:觉得通用世界模型应该统一所有机器人的表示,还是只统一世界知识?
A8:对,我觉得这也是个挺好的问题。我们对世界模型的定义可能就是说它能够充当一个世界的一个模拟器,理论上来说可能也不需要去太关注不同本体它到底怎么建模,只需要去关注不同本体它和世界做交互之后,这个世界会怎么变化。那可能通用的世界模型我觉得最重要去需要去关注的是统一世界知识,在这个基础上,我觉得再可以去考虑统一不同机器人的表示。当然这个可能也得随着后面时间的发展来决定,因为现在机器人这个硬件百花齐放嘛,所以怎么样去做一个模型去表征不同的机器人是比较重要的,因为现在对于不同机器人,如果单独训一个模型的话,那成本会特别高。如果后面硬件收敛了,如果只存在几种机器人的话,那这个就不是一个特别大的问题。然后我个人觉得统一机器人的表示和目前来说,统一不同机器人的表示和统一世界知识这两件事情也是相互促进的。我们在统一的不同机器人的表征的前提下情况下,才可以比较好地将不同机器人的数据给利用起来,让它们比较好地进行一些 transfer,transfer 它们和不同机器人和物体交互的状态变化,还有它们观测到的世界的一些知识。
Q9:你们认为当前模型距离真正的物理世界模型还缺少哪些关键变量?
A9:对于我们,我刚刚也在分享说到那几个点。第一个是我现在的具身世界模型还是过多地去关注于视频生成的画质好不好看,当然对于具身世界模型来说相对会好一点,它主要关注这种 action 跟随准不准,然后和物理和物体交互它这个合理性。但是它离真正想可以去用到的具身世界模型还是有一定距离的。第一个就是说现在世界模型,当然现在只讨论基于这种 video 的 world model,它还是只能去表征视觉上的一些信息。至于这种力反馈、触觉怎么去注入到里面去帮助它更好地去建模手物交互,特别是一些特别精细灵巧的操作,还是比较困难的,因为可能光从像素还是很难去体现的,还是需要机器人真正地在做一些强化学习,才能去拿到真正的一些 knowledge。
然后第二个还是它的速度和长时序一致性的问题。因为我们对于具身世界模型的一个非常重要的用途,就是说它能不能作为一个具身的世界模拟器,给机器人去在里面去做各种规划、训练、强化学习的训练,还是评测也好,它需要做到实时可交互、能够做到长时序一致这两个特点,它才能作为一个闭环的评测器、闭环的一个环境给机器人用。但是这 2 点对于目前的 diffusion-based video world model 还是存在一个很大的 gap。
Q10:模型运行时还会有幻觉吗?
A10:对于幻觉,可能我理解的幻觉就是在一些它没有见过的比较 OOD 的这个任务或场景上,它是不是会生成一些很奇怪的内容或者很奇怪的一些交互。这个对于 generative 的 model 来说应该都是存在的。然后咱们这边的话,其实主要关注的是它手和物体交互的部分以及它视角变化带来的场景的变化,是不是能够做到一个比较好的衔接和合理性。对于短视频的一些,比如 5 秒内或者 10 秒内甚至 30 秒内的视频生成,我们的模型在这些上面还是表现得比较稳定的。然后如果对于特别长的视频,可能 2 分钟以上、3 分钟以上,这种模型运行的时候到后面还是会有一些幻觉和漂移的问题。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册