一篇机制拆解笔记。基于 Qwen2.5-7B-Instruct 上的十二次变量分解实验(screening-level:每臂 n=5 paired seeds,不做显著性检验)。
读完应能回答:为什么「把记忆塞进 KV cache」有时好使、有时会把任务框整个塌掉。
做长程 Agent 时,大家都绕不开记忆:目标、指令、历史归档——怎么让它们跨轮次还在、还被用上。
主流做法是 prompt-layer memory:每轮把系统块整段重发。成本随对话线性涨。另一个越来越常见的思路是 KV-resident memory:把记忆对象编码进推理时的 KV cache,跨轮钉住(pin),再用 attention mask 控制可见性。听起来很美——省掉每轮重发,还能做细粒度「读权限」。
但系统论文往往只报端到端输赢,很少拆开:到底是 KV 驻留里的哪几个成分在干活? 驻留本身把好几件 prompt 侧从不分开的事捆在一起了——缓存表征相对对话是 fresh 还是 stale?驻留 token 是否落在模型熟悉的结构位置?检索回来时怎么重新注入?驻留形态是否保住了「会用记忆」,而不只是「能住下记忆」?
本文是机制研究预印本的笔记版:单模型(Qwen2.5-7B-Instruct,本地 greedy 推理)、固定 44 轮受控脚本、机械打分,十二次实验一次只动一个变量——编码新鲜度、驻留形态、检索注入形态、记忆管理策略的执行面。所有数字都是 screening-level——方向和效应量可看,不要当成已确认的总体估计;文末会把边界再写清楚一遍。
问题:KV 驻留内存,到底什么在干活
先把现象摆清楚。E4 里,目标钉在 KV 里时,任务照样做得下去(代码抽取几乎不掉),但开放式自由回忆几乎没有:prompt 每轮重发是 15/20,KV 钉住只有 4/20。记忆「在」,也不等于会被主动说出来。
那重发到底买的是什么?重复曝光?共激活?还是「每轮重新编码」本身?后续实验把这几件事拆开了。
同时还有另一条线:同一张 44 行归档表,放在 prompt 里每轮新鲜重发时完美可用;换成 KV 里 stale resident,却可能把任务框塌掉——median strict 从 41 掉到 26。内容一样,形态不同,命运相反。失败形态也不是「信息丢了」,而是任务框塌掉:答案开始鹦鹉学舌填充文、把归档行当成现场数据、甚至编造数字。
下面五个发现,对应这套分解。读的时候可以对照四张机制图:分工总览、fresh encoding、塌缩形态、注入形态。
发现一:Fresh encoding 才是有效成分
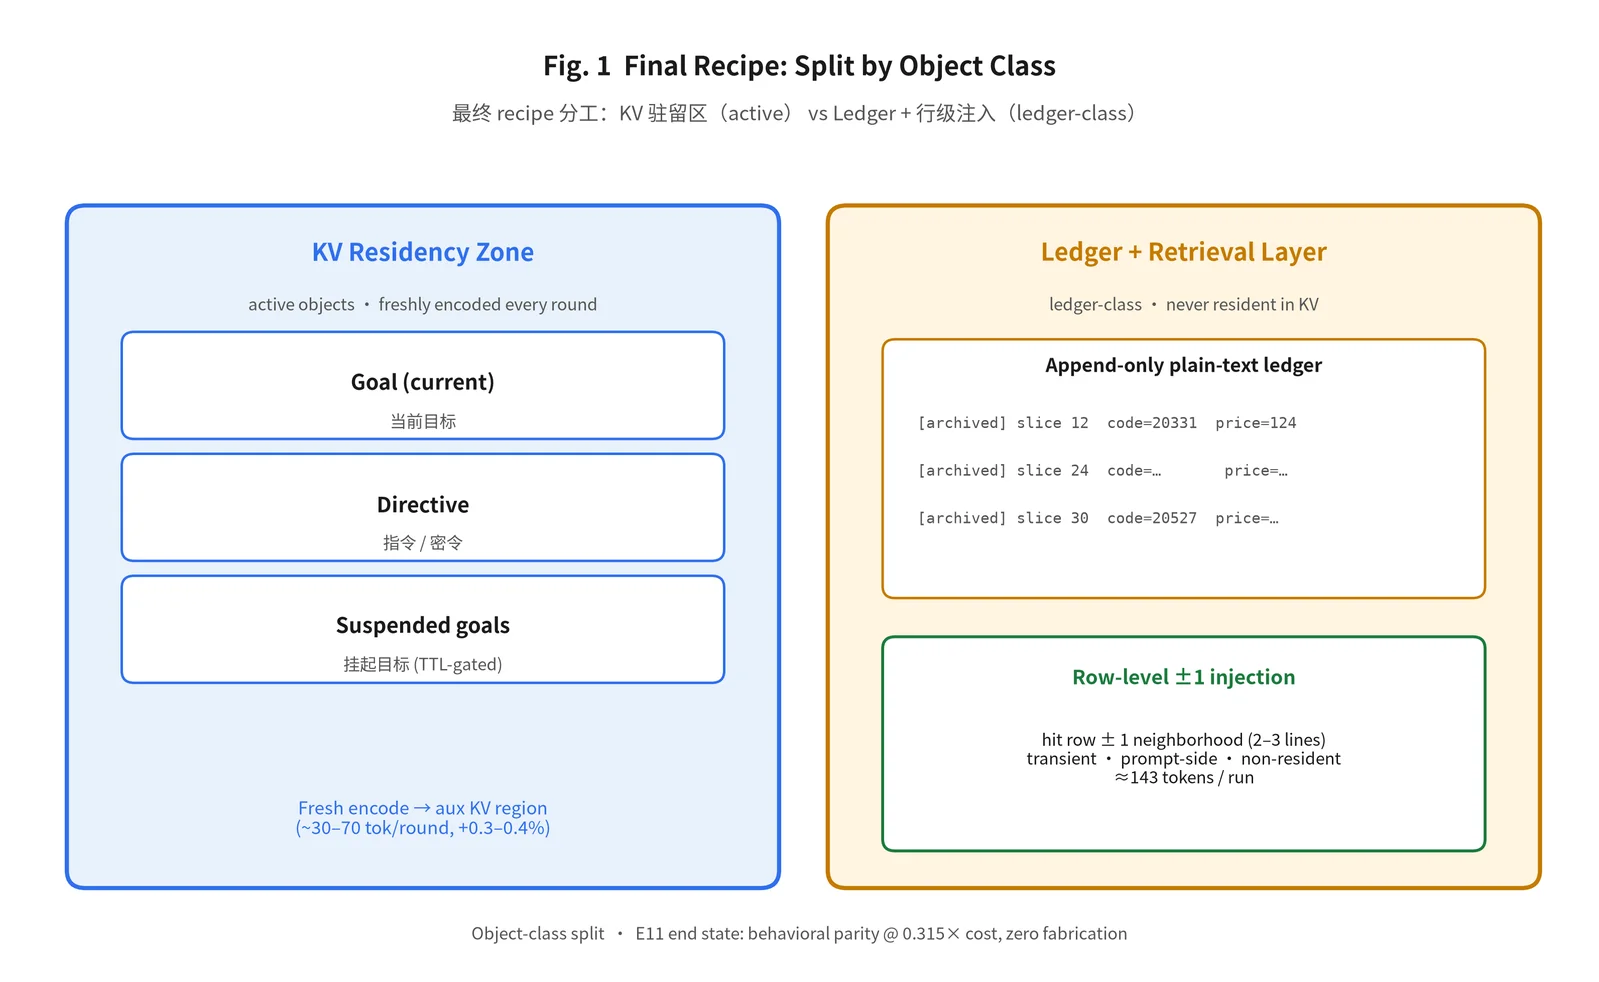
图1 · 最终分工示意:当前目标 / 挂起目标 / 指令走 KV 辅区并每轮 fresh encode;ledger 类内容不进 KV,按需行级注入。
Presence ≠ use。 驻留保住了可用性,却不保住自发使用。E5 用「把目标文本塞进瞬时材料流」测 rehearsal 假说——5 / 11 / 33 次脉冲,自由回忆却是 4 / 4 / 2(满分 20),反向剂量反应:脉冲越多,意识越差。共激活污染了目标信号,而不是在加固它。
E6 做了裁决:
| 目标怎么编码 | 臂 | 自由回忆 | 相对成本 | 任务行为 |
|---|---|---|---|---|
| 每轮新鲜,KV 辅区 | F | 20/20 | 0.3448× | 41/41 ×5 |
| 每轮新鲜,prompt | E | 15/20 | 1.00× | 41/41 |
| Stale 驻留 | G | 8/20 | ~0.34× | 40–41 |
| 塞进材料流(反向剂量) | R* | 2–4/20 | ~0.34× | 波动 |
| Sham:等长重锚定,非目标内容 | S | 1/20 | 0.3434× | 41/41 |
F 达标、S 几乎为零——有效成分是 对目标内容的每轮新鲜编码,不是「重锚定这个动作本身」。同一套 recipe 迁到指令(directive)对象:stale 驻留 5/15 → 新鲜编码 15/15,成本大约 +0.4%(E9R)。
旁路探针还提示:fresh encoding 在机制上买到的,很可能是 位置可达性(positional recency)——把驻留区拉回查询附近。固定 stale 驻留、只改目标区与当前查询的距离时,自由回忆可以从近位的 20/20 翻到远位的 8/20,而任务抽取本身几乎不受伤。协议层面我们仍把「每轮新鲜编码」叫作有效成分;机制词汇上,它买的是位置可达性。
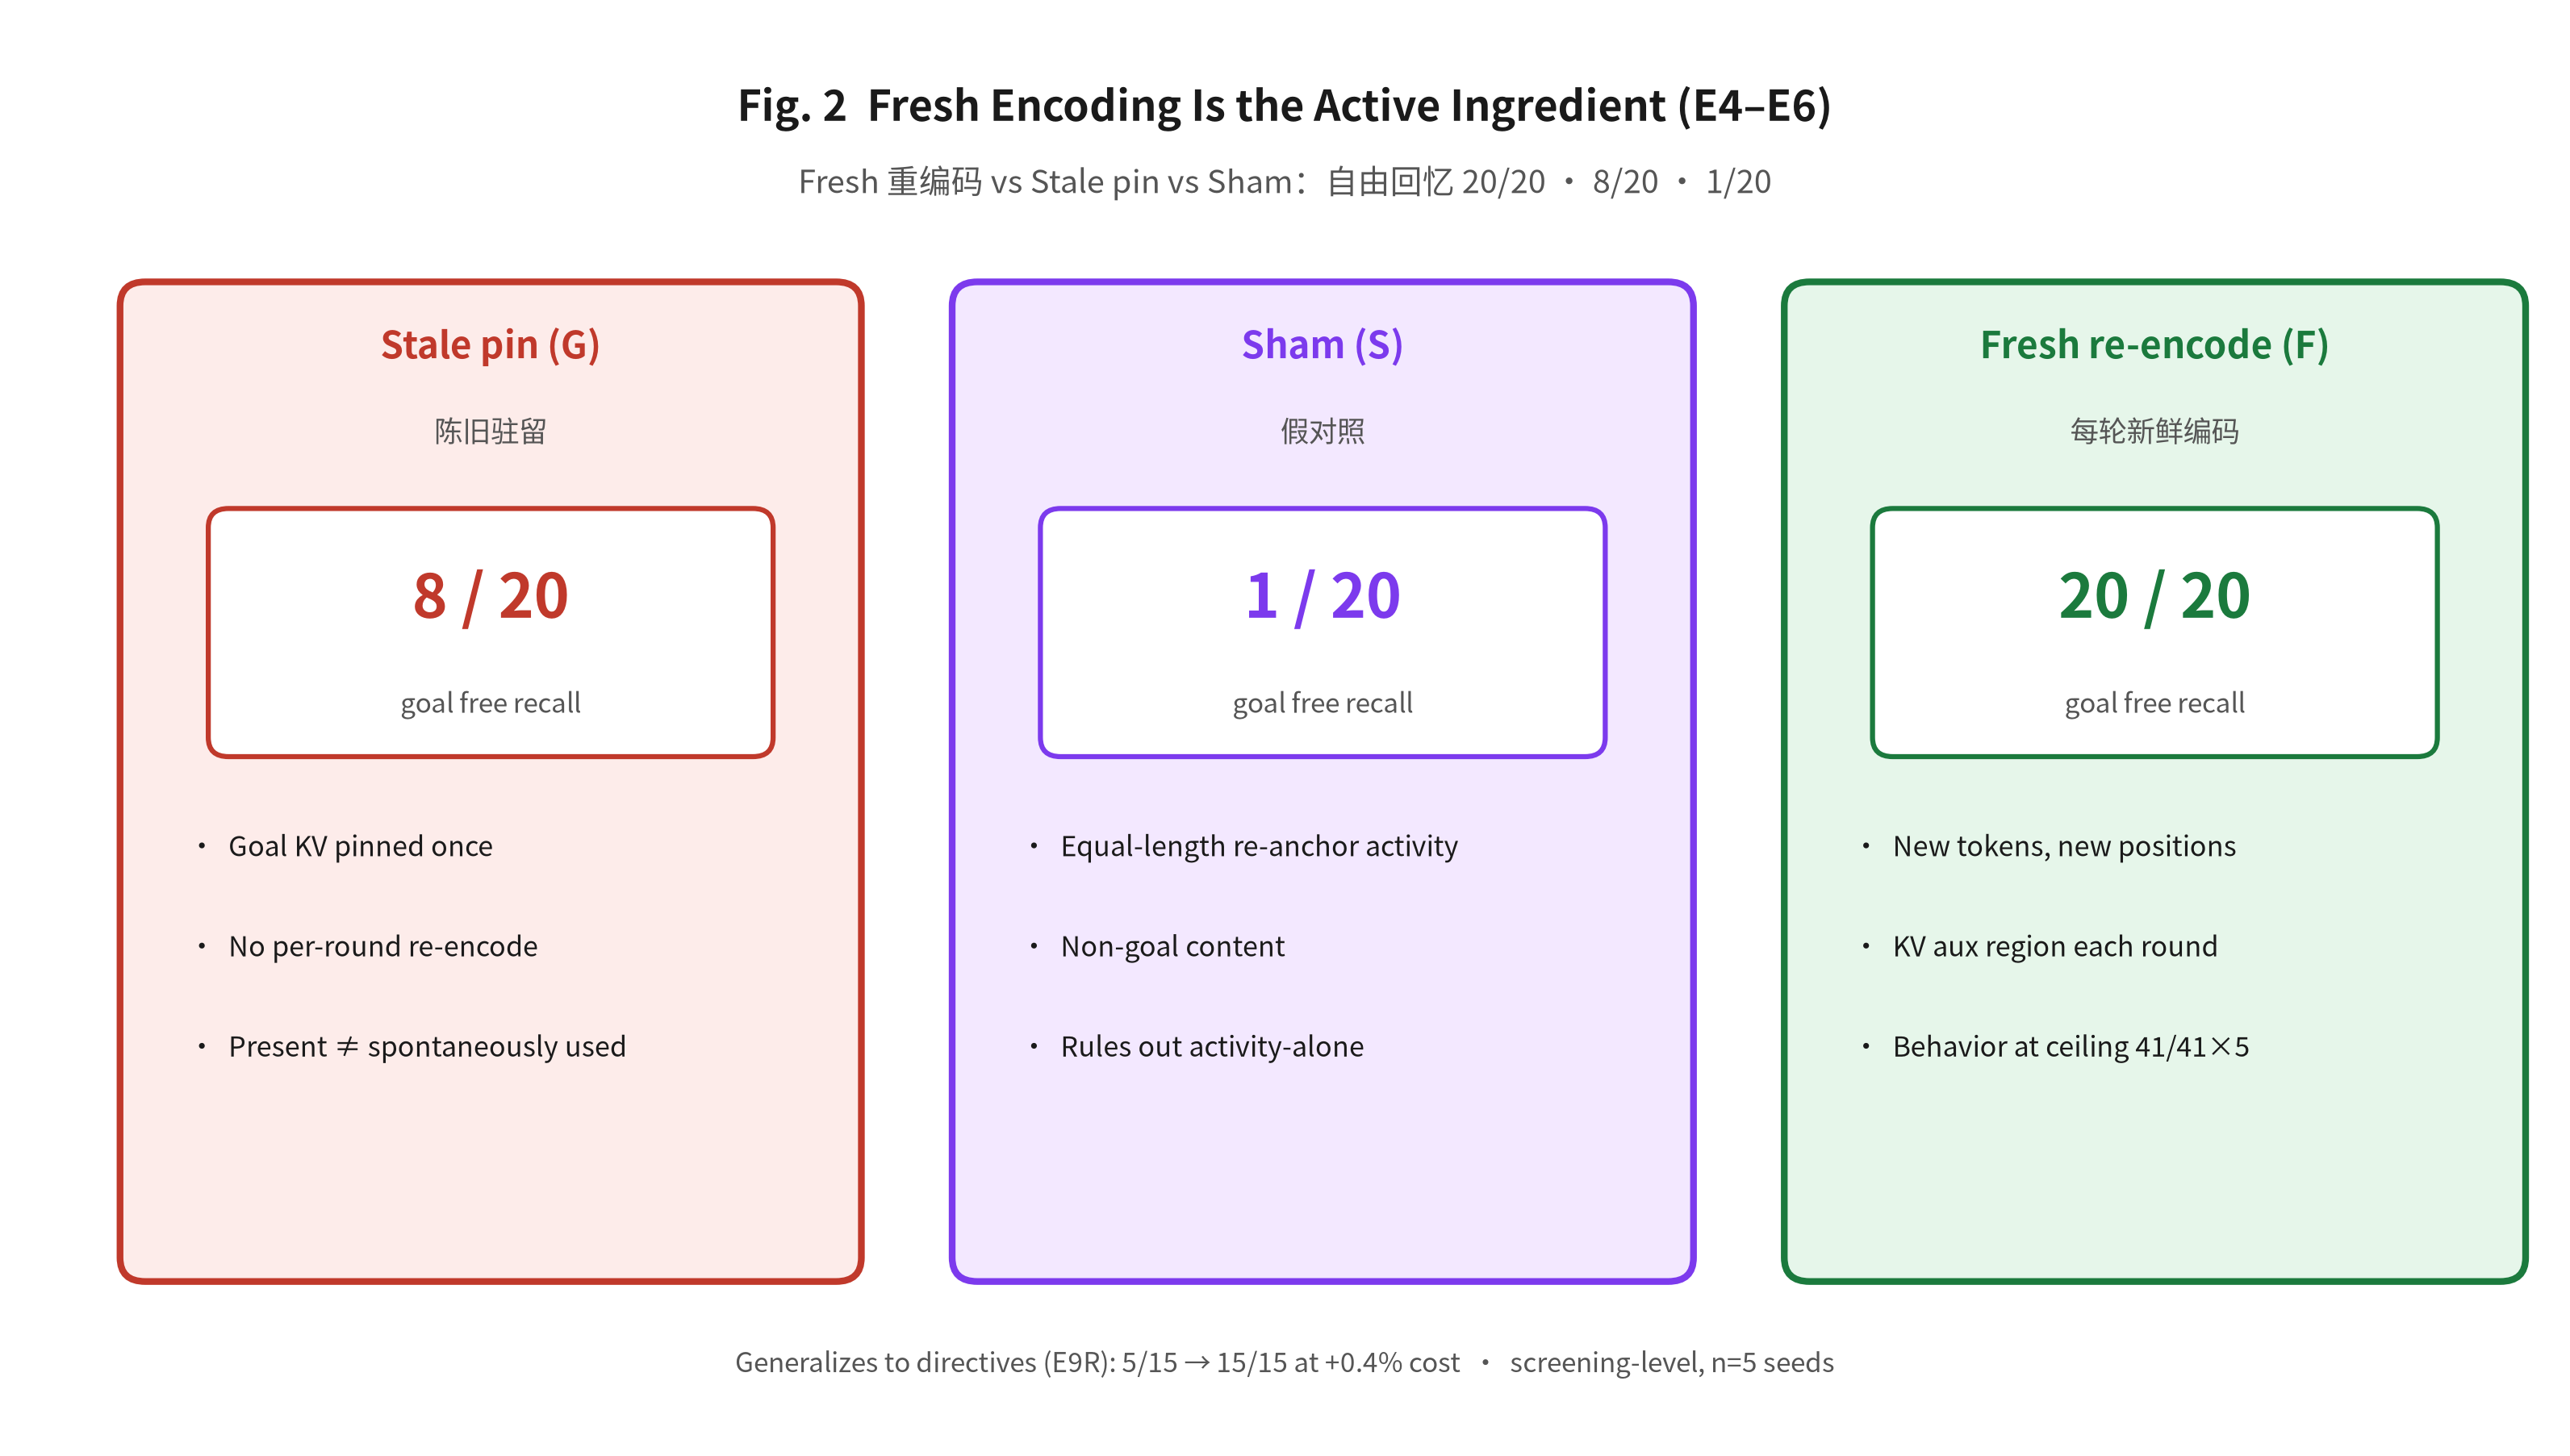
图2 · Fresh encoding 裁决(E6):F 20/20,stale 约 8/20,sham 1/20——重锚定活动本身不够,要编的是目标内容。
发现二:Residency form 决定同一内容的命运
把 OS 风格记忆管理器接到两种执行面上(E7):P 在 prompt 侧执行同一套策略决策;K 通过 KV 装配执行。决策时机完全配对。
结果很刺眼:K 五个行为门全挂,成本门却过了(约 0.34×);P 全满分。 Strict median:K 26 vs P 41,五个 seed 同向掉分。更有意思的是时间线——K 前 27 轮可以完美,塌缩集中在第 31 轮相位切换附近:任务框丢失(答案开始鹦鹉学舌填充文)、源混淆(把归档行当现场数据)、编造。不是「记不住了」,是 task-frame / retrieval-mode collapse。
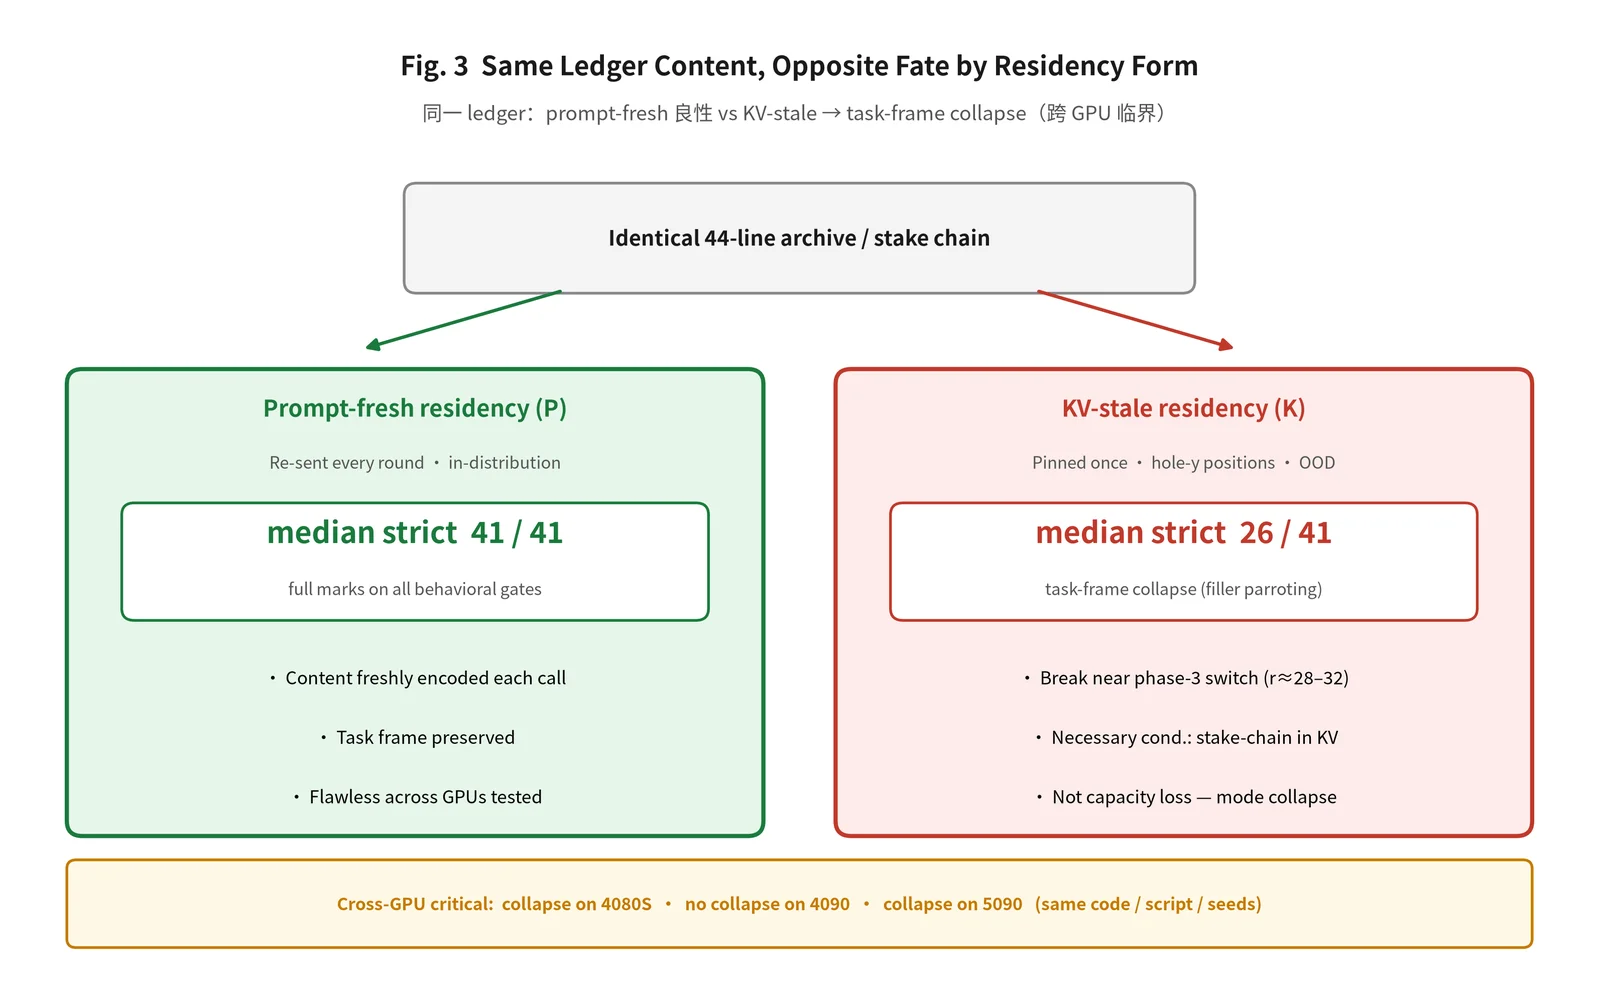
图3 · Residency form(E7–E9):同一 44 行内容,prompt-fresh 无恙;KV-stale 可触发任务框塌缩;跨 GPU 呈临界现象。
跨硬件更扎眼:同一代码、同一脚本、同一 seed——4080S 塌、4090 不塌、5090 又塌。E8 因 form-band 违规整实验降级为描述性,诚实记录写的是「塌缩形态在这台机器上未复现」——这正是预注册纪律该拦住的假复现。
结构突变把模型推向临界边界,bf16 数值路径细节(累加顺序、GPU 型号)决定落在哪一侧。两件事倒是跨机复现的:指令 stale 失败(dir 5/15)和成本优势(约 0.34×)。工程含义直白:不要把 ledger 类内容以 stale 方式钉进 KV。
发现三:消融链钉死必要条件——stake-chain 的 KV residency
塌缩窗口里几件事叠在一起(read-back 页入残留、相位切换、stake chain 涨到七百多 token)。单靠观察分不开。E9-D 做去除式诊断:
- 切掉 stake chain 的 KV 驻留 → 塌缩消失(strict 回到 41/41、40/41,含原先失败最集中的第三相位)。
- 从不页入 read-back → 塌缩依旧 → masked read-back 被排除。
- stake 不进 KV、只在提问轮 flash 进 prompt → 不塌,但进度题能力归零(j4c 0/4)。
同一张 44 行表,按形态有四种命运:stale KV 驻留 → 塌;不进 KV → 行为满分;提问轮整链 flash → 不塌但用不上;prompt 每轮新鲜 → 处处满分。必要条件钉在 stake-chain 的 KV residency。
发现四:检索注入有分布约束——整链涌现败,行级窄窗成
Ledger 既然不该常驻 KV,按需回来时怎么注?
两种「整链涌现」都失败了:
1、 Call-level KV gating(E8):链一直在 KV 里,只在提问轮把 attention 打开 → 进度题 6/20(对照不门控 17/20、prompt 20/20)。模型面对的是「四十多行突然一起冒出来」——本身就是一次结构突变。
2、 提问轮 prompt flash(E9-D):不塌,但 j4c 0/4——闪现是分布外打断,答对靠的是「每轮都新鲜在场」,不是「提问时突然送达」。
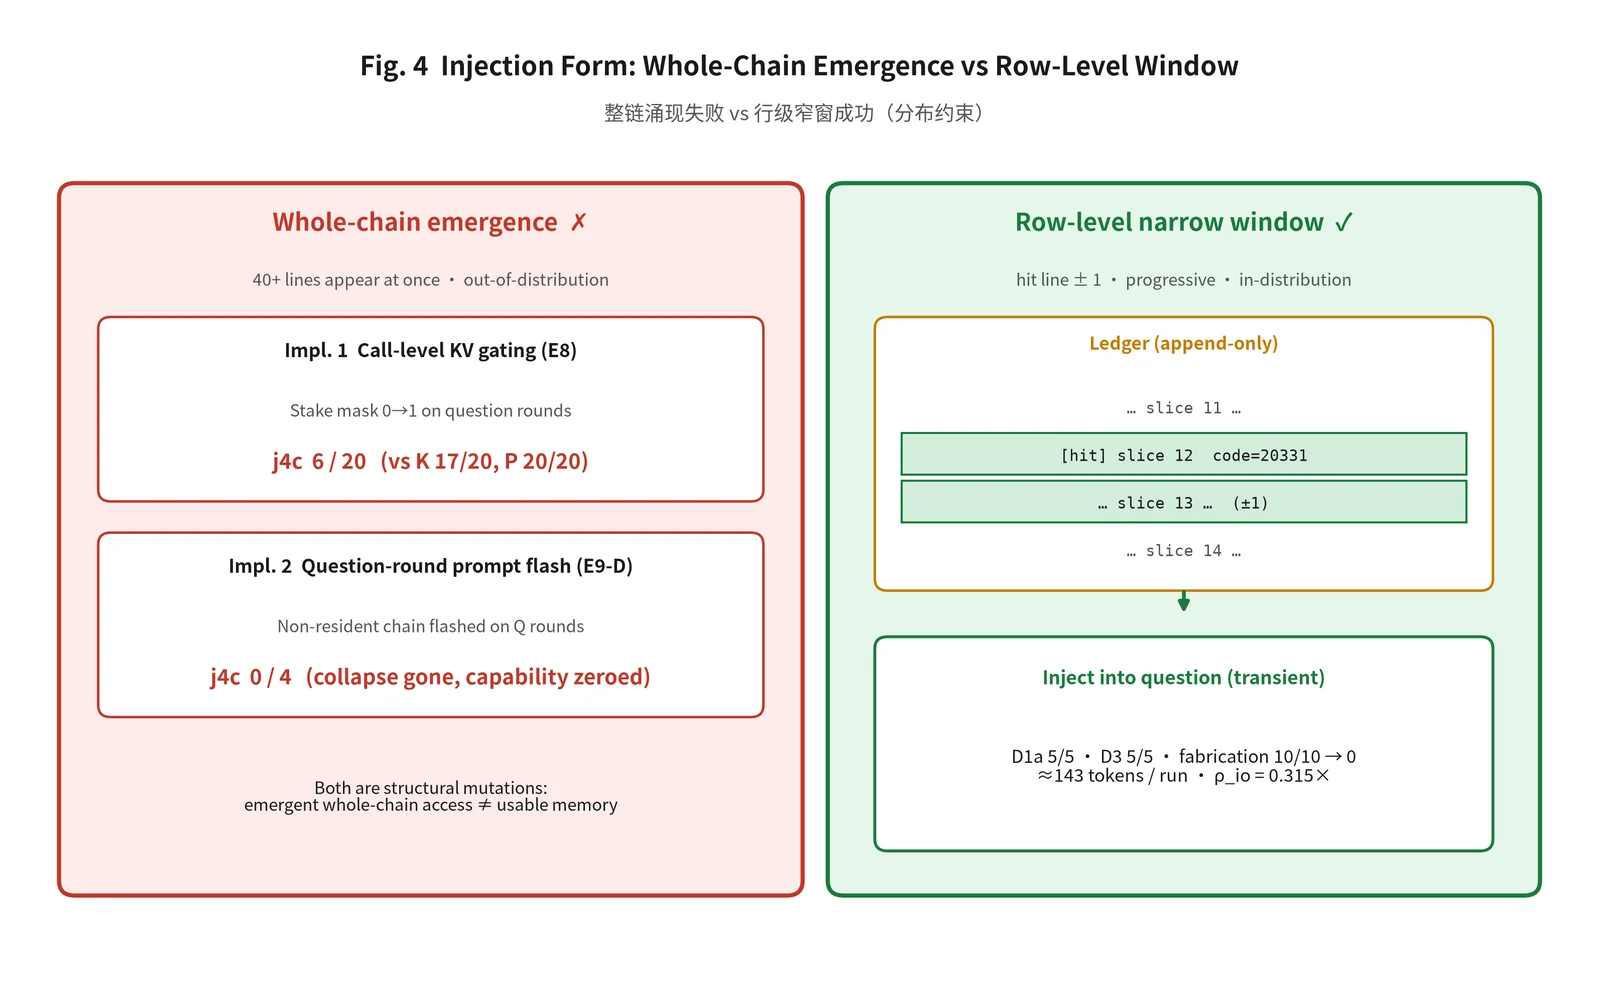
图4 · 注入形态(E8 / E9-D / E11):整链涌现两种实现都失败;行级窄窗(命中行 ±1)修好深历史检索,约 143 tokens/run。
行级窄窗(E11):从问题里抽出 slice N,在账本里找到对应行,把 命中行 ±1(2–3 行) 临时塞进该轮 user message——瞬态、非驻留。深历史紧急查找 5/5、源引用 5/5;编造从无检索基线的 10/10 → 0;开销约 143 tokens/run,相对完整 prompt baseline 仍是 0.315×。
概括一句:注入必须渐进、窄窗,才能留在分布内;整链涌现本身就是突变事件。(诚实边界:注入行带真值,测的是「检索→正确消费」链,不是裸模型记忆。)
发现五:二阶决策总量打平,剖面互补
一阶指标问「记没记住、说没说出」;Agent 还要「用对」。E10 加了六类决策事件。主分(四类可达集)Kf 15/20 vs P 15/20——总量打平,剖面几乎镜像:
- 深历史查找 / 源引用:prompt 有常驻账本 → 5/5;KV recipe 账本已离场 → 0/5 并编造。
- 冲突优先级权衡:KV 辅区当前目标信号干净 → 5/5;prompt 每轮重发挂起目标 → 过曝偏置 → 0/5。
- 近场例外补救:KV 近场注意力尖 → 5/5;prompt 长上下文把近场埋住 → 0/5。
E11 加上行级检索后,KV recipe 六类全 5/5、零编造——理想形态不是一边碾压另一边,而是 KV 的干净目标信号 + 近场锐度,配上可咨询的窄窗账本。顺便一提:E10 判分曾抓到会反转标题的裁判 bug(修完后「KV 决策优势」变成总量打平)——机械裁判必须配对抗自测和人工答卷审计,数字才站得住。
最终 recipe:分裂,而不是铁板一块
十二次实验留下的不是「全上 KV」或「全上 prompt」,而是按对象类分工:
KV 驻留区(active 对象)
当前目标 + 挂起目标 + 指令,每轮 fresh encode 进辅区(约 30–70 tokens/轮,成本 +0.3–0.4%);read-back 用 TTL=2 门控页入。Ledger 类对象构造上不进 KV。
检索层(ledger 类)
Append-only 纯文本账本,提交时记账;深历史问题触发机械检索,hit ±1 瞬态注入。
相对完整 prompt baseline(各项行为门已在天花板):
- 严格任务分、指令保真、旧目标回忆、决策主分:parity
- 决策六类全 5/5(prompt 自身仍有两类掉分)
- 编造:0
- 计费成本:0.315×(input+output,无前缀缓存的保守口径)
两处边界要带着看:计费 token 不含 attention FLOPs——驻留省的是重发,不是读;检索行带真值——测的是消费链。
方法边界(请带着读)
1、 单模型:仅 Qwen2.5-7B-Instruct;32B 等规模未复验。
2、 受控合成脚本:44 轮、机械真值——归因清楚,生态效度未买。
3、 Screening-level:每臂 n=5 paired seeds,报方向与效应量,不做显著性检验;很多是 5/5 或 0/5 分裂,当机制筛查读,不当总体估计。
4、 无外部系统对照:只做机制变体相对自身 prompt 天花板的内部比较。
5、 Greedy、单轨迹;跨 GPU 临界性说明系统贴着边界。
6、 0.315× 是无前缀缓存下的计费比;厂商侧缓存会收窄 gap。
方法论本身也有故事:机械裁判配对抗自测与人工答卷审计,曾抓住会反转标题结论的判分 bug;form-band 规则曾拦住跨 GPU 漂移下的假复现声明。这些是「能信数字」的前置条件,不是装饰。
Takeaway
如果只带走三句话:
1、 Active 记忆要 fresh encode——驻留不等于会用;每轮重编码(买位置可达性)才是便宜有效成分。
2、 Ledger 不要 stale 钉进 KV——同一内容,形态可以决定命运,塌缩还可能跨硬件临界。
3、 检索回来要窄窗——整链涌现是突变;hit±1 一类渐进注入才留在分布内。
开放问题仍在训练侧:重装配 cache 带着训练没见过的 hole-y positions;stale 表征会随对话推进衰减——inference 侧的 fresh encoding 是对后者的补丁,不是根治。
两条都指向同一类训练侧目标:原生可驻留的 memory register,按「可驻留、位置可达、新鲜治理」来设计,并拿这份失败目录当负例。欢迎对数字、图示和叙事拍砖;预印本级笔记,筛查结论,不代替正式发表。
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册