先说个场景。
你让机器人去桌上拿那个蓝色杯子,它答得挺快:好,蓝色杯子。
然后手伸过去,抓了个空。
不是它不认识。它认识,甚至能告诉你杯子里有没有水。但它指不准——杯柄在左边还是右边,杯口离桌沿还有几厘米。就差这么一点,手就空了。
第一反应往往是“手”的问题:控制不够精细、动作不够稳。但把这两篇论文翻完,结论可能正好相反:卡住的可能是“眼睛”。

而且这事儿还有个更麻烦的地方:不光要准,还得快。
闭环控制里,定位慢一步,动作就晚一步。可现在的 grounding 模型为了准,经常要在密集场景里吐一长串坐标 token,延迟直接吃掉控制频率。准和快,像鱼和熊掌。
最近,小鹏、北京大学、香港大学等机构同天放了两篇工作,正好一人管一个:GroundingPI 管“准”,GroundAnything 管“快”。
先说 GroundingPI:它把“坐标”变成了“字”
平时见到的 grounding,大概两条路。
一条是外挂检测头,精度可以,但跟语言模型是两张皮。另一条是让模型直接把坐标当文本吐出来,比如“左边 123,上边 456”,统一是统一了,可代价吓人——比如 SEED1.5-VL,一个框要吐 148 个 token,密集场景一张图几十个框,光吐坐标就能吐到天荒地老。
GroundingPI 的做法很“程序员”:既然文本能当 token,坐标为什么不能?
它干脆把坐标也做成词。把画面切成 1000 个格子,每个格子的编号就是一个 token,跟“杯子”“杯柄”这些词躺在同一张词表里。模型想指一个位置,就跟说一个词一样自然。查无此物的时候,它就输出一个 None。
说白了,它让“指哪”从外挂功能,变成了模型的母语。

论文:GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives
链接:https://arxiv.org/abs/2609.39601
项目主页:https://groundingpi.github.io/
代码:https://github.com/groundingpi/GroundingPI
模型:https://huggingface.co/GroundingPI/GroundingPI
训练上分三段:先做基座 VLM(投影对齐、多模态联合预训练、通用视觉理解,一共 500.41B tokens),再做 SFT 把坐标和输出协议对齐(221.17B tokens),最后上 GRPO——每张图每个问题采样 8 条回答,奖励拆成“覆盖度 0.7 + 严格定位 0.3”。
数据这块也没全靠公开集。他们做了个数据引擎:多个教师模型分别标,按字段级“接受 / 拒收 / 未决”来融合,再由一个统一的 grounding 专家迭代补标。不是简单投票,是“有疑点的再取证”。

效果如何?
34 个 grounding benchmark、44 个 baseline、11 类感知能力,平均 73.68%,比 GPT-6 Astra 的 71.54% 高一点。
注意,就一点。
真正值得看的是分项:密集小目标,Dense200 上 74.53 对 65.04;指代,HumanRef 上 88.56 对 83.01;OCR 和版面也赢(SROIE 72.47 对 53.57)。
但反过来也得说清楚:GUI 差得挺明显,ScreenSpot-Pro 只有 65.78,Astra 是 93.17;空间指向 RefSpatial 也是 75.50 对 85.93。所以谁要跟你说“全面超越 GPT-6”,把这两行甩过去就行。

比跑分更狠的,是“换双眼睛”之后动作真的变好了
这才是这两篇论文最值得聊的部分。
他们把 8 个预训练基座——通用 VLM、视频生成、grounding、具身基座各两个——接到同一个 π0 风格 Action DiT 上,动作数据、训练预算、推理流程全部固定,只换“眼睛”。
结果:RoboTwin2.0 Full 66.20%;只训 Clean、测 Randomized 的 Clean2Random 上 17.60%,第二名 Rex-Omni 是 14.10%,相对高 24.8%。
更离谱的是数据效率。RoboCasa-GR1 上只给 50% 的演示数据,它跑到 28.75%,比所有基线用 75% 演示的最好成绩(27.75%)还高。只用了 50% 的演示数据,反而更能打。
但这里得说句实话:满数据 ID 上它 37.75%,还是低于 RynnBrain 的 39.00%。论文自己写得很老实——优势在“少数据”,不在“满数据”。这一点挺难得的——很多工作只挑好看的数字讲。
数据配方那段也挺干货。他们把感知能力拆成六组:基础定位、密集定位、指代、基础点选、机器人点选、OCR/版面/GUI,然后一组组拿掉,看下游掉多少。
结果是,拿掉密集定位,RoboCasa 的 ID/OOD 直接掉 4.67/3.47 个百分点,妥妥的空间核心。而 OCR 单独用最弱,放进组合里却最有用——作者由此猜它是“感知催化剂”,也老老实实承认:这只是假设,得做匹配干预才能证明。

再说 GroundAnything:它解决的是“快”
自回归的问题很直白:一个字一个字往外蹦,密集场景一张图几十上百个框,序列化长度就是延迟。
GroundAnything 换了个想法。它说,grounding 本质是“从图里抽视觉证据”,对象、位置、关系之间是有依赖,但有依赖不代表必须从左到右生成啊。
于是它用块状扩散,并行去噪:先一起冒出一堆空间假设,再一起精修。

论文:GroundAnything: Reconciling Parallel Decoding with Precise Visual Grounding at Flash Speed
链接:https://arxiv.org/abs/2609.39600
项目主页:https://groundingpi.github.io/groundanything/
打个比方,自回归像挤牙膏,一次挤一点;扩散像先糊一版草稿,再拿橡皮擦一起改。改的是整张图上的所有框,不是“下一个框”。
训练路径也挺少见的:先做 grounding 预训练,再把自回归模型直接转成扩散模型(AR 和 diffusion 联合目标),然后 SFT、GRPO。AR 版本也留着了,叫 GroundAnything-VLM。

结果:30 个 grounding benchmark 上,AR 版平均 72.42%,跟 Astra 的 71.35% 基本打平;扩散版用熵引导解码,平均 61.75%,比主打速度的 LocateAnything(53.32%)高一截。速度上,可选的 self-speculative 模式相对 AR 版本 4.51 倍加速,COCO F1mIoU 只掉 0.74 个百分点。

一句话:准和快,可以不是二选一,取决于你让模型怎么“开口”。
所以这场分享,值得听什么
不是听“又刷新 SOTA 了”。SOTA 这事儿,每周都有。
值得听的是三件事。
第一,一个 4B 的模型,怎么从“预训练到底该训什么”这个第一性问题倒推:先把感知拆成可训练的能力项,再一项项配数据。这个思路,比模型结构本身更值钱。
第二,那张六组配方的消融表。做 VLA、做具身的人,最缺的就是这种“数据该往哪投”的证据。
第三,如果你不做具身,这也算个好案例:所有人都在卷更大的模型,有人回头去卷更对的预训练目标,而且还真赢下了几个关键项。
最扎心的问题是:如果下一代通用模型把 grounding 追平了,专用感知基座还剩什么价值?这个,留到 AMA。
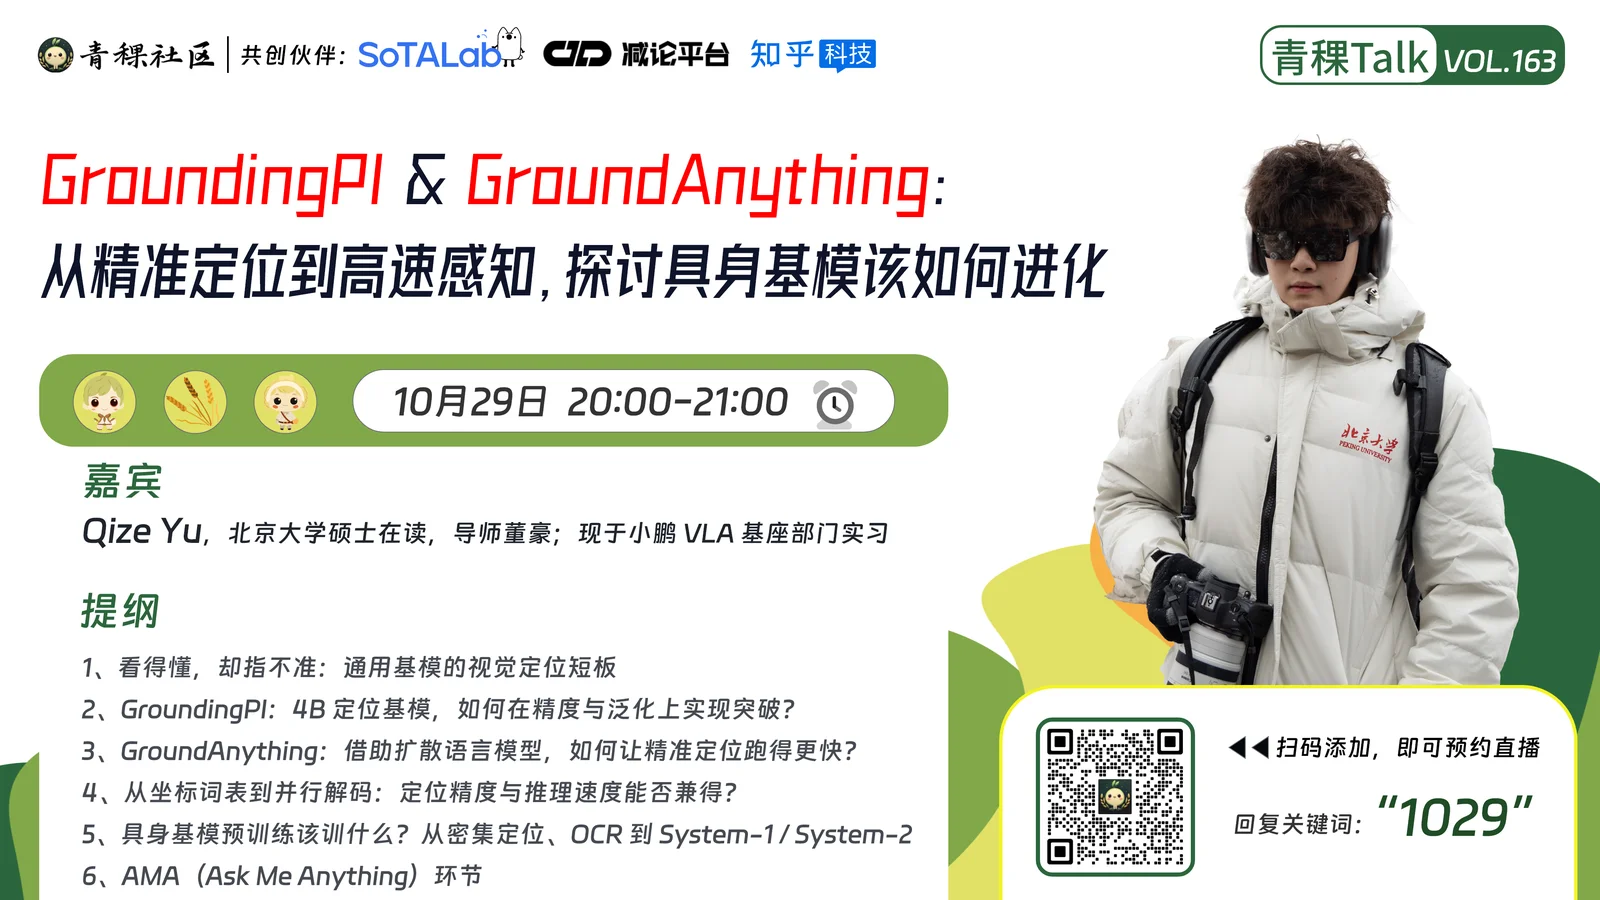
10月29日(周四)晚8点,青稞Talk 第163期,青稞社区邀请到 GroundingPI 与 GroundAnything 共同第一作者、北京大学硕士生(小鹏 VLA 基座部门实习生)Qize Yu,聊聊《GroundingPI & GroundAnything:从精准定位到高速感知,探讨具身基模该如何进化》。
嘉宾介绍
Qize Yu,北京大学硕士在读,导师董豪;现于小鹏 VLA 基座部门实习,研究方向为具身感知与 VLA 基座模型。GroundingPI 与 GroundAnything 共同第一作者、项目负责人(project lead),两项工作于 2026 年 9 月 30 日同天发布,代码与权重均已开源。
分享内容
GroundingPI & GroundAnything:从精准定位到高速感知,探讨具身基模该如何进化
1、看得懂,却指不准:通用基模的视觉定位短板
2、GroundingPI:4B 定位基模,如何在精度与泛化上实现突破?
3、GroundAnything:借助扩散语言模型,如何让精准定位跑得更快?
4、从坐标词表到并行解码:定位精度与推理速度能否兼得?
5、具身基模预训练该训什么?从密集定位、OCR 到 System-1 / System-2
6、AMA(Ask Me Anything)环节
直播时间
10月29日(周四)20:00 - 21:00
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册