论文:Bellman Policy Optimization
链接:https://arxiv.org/abs/2609.15987
作者:Zhuoqing Song、Haotian Xu
1. 为什么 RLVR 会变成离策略学习
可验证奖励强化学习(Reinforcement Learning with Verifiable Rewards,RLVR)使用来自自动检查器的奖励来训练语言模型,例如验证数学答案是否正确,或运行生成代码的测试。模型生成回答,验证器为回答打分,这些奖励再用于指导策略更新,以提高未来回答的期望奖励。
在实践中,用于一次更新的回答往往来自另一个策略。在同步训练中,将 rollout batch 划分为多个 mini-batch,会使后续优化器更新使用由较旧策略生成的数据。在异步训练中,rollout worker 可能落后于 learner;在 partial rollout 中,一条回答甚至可能跨越多个策略版本。训练引擎与推理引擎之间的数值差异也会带来额外偏差。When Speed Kills Stability、off-policy RL、KPop 和 IcePop已经讨论了这些背景。它们共同导致的结果是:正在优化的策略不同于生成训练数据的策略,即产生了离策略学习问题。
flowchart TD
    A["rollout 策略 μ 生成回答"] --> B["训练策略 π 发生变化"]
    C["同步训练:后续 mini-batch"] --> B
    D["异步训练:worker 滞后"] --> B
    E["partial rollout:跨模型版本"] --> B
    F["训练—推理数值差异"] --> B
    B --> G["π ≠ μ:离策略学习"]
    G --> H["IS 修正或 BPO"]
图 1|RLVR 中离策略性的主要来源。 同步 mini-batch、异步 staleness、跨版本 partial rollout 和训推数值差异,都会让训练策略 \pi 偏离实际采样策略 \mu。
最直接的修正:重要性采样
令 x 表示 prompt,y=(y_1,\ldots,y_T) 表示回答,R(x,y) 表示终局奖励。我们的目标很简单:
然而,数据来自 rollout 策略 \mu。处理这种差异最直接的方法是重要性采样(Importance Sampling,IS):
只要在 \pi_\theta 赋予正概率的地方,\mu 也赋予正概率,这就是严格的测度变换。对于自回归生成,序列权重是各 token 概率比的乘积:
这里,\mu 表示真实的采样过程。如果一次 partial rollout 在生成过程中切换了模型版本,那么分母必须使用实际生成每个 token 时对应的条件概率。
困难在于方差。 对于很长的回答,这些比率的乘积可能变得极大或极小,最终只剩少数轨迹主导整个更新。因此,在长回答 LLM RL 中,未经修改的序列乘积 IS 通常并不是实用选择。GSPO,§4.1 使用长度归一化的序列比率:
并在序列级别执行裁剪。长度归一化降低了权重对回答长度的敏感性,但也改变了优化目标:s_\theta 已经不再是严格的 IS 权重 W_\theta。
2. Token 级 IS 实际上近似了什么
Token 级 surrogate 是对序列目标的一阶近似,参见 Stabilizing Reinforcement Learning with LLMs。令 r_t=1+\Delta_t,则
固定 \mu,可得
当 \pi_\theta=\mu 时,两者的梯度一致。但对于一条 T=16384 且 r_t=1.001 的轨迹,
$
W_\theta=1.001^{16384}\approx1.29\times10^7, \qquad W_{\mathrm{lin}}=1+16384\times0.001=17.384.
$
微小的 token 级偏差会沿着长回答不断累积,从而使一阶近似变得不可靠。
KPop 发现,低概率 token 的训练—推理 log-ratio 波动更大,因此固定的 ratio mask 可能会不成比例地丢弃这些 token。
3. BPO:结合策略镜像下降与贝尔曼方程
动机:构造一种数学定义清晰、且不依赖重要性采样的策略优化方法。
我们使用两个关键工具:
- 策略镜像下降(Policy Mirror Descent,PMD):一种基于 rollout 策略优势 A^\mu 的策略改进方法。
- 基于 rollout 策略 \mu 的贝尔曼方程。
基于 rollout 策略优势 A^\mu 的策略镜像下降(PMD)
PMD 是一种策略改进方法。在每个前缀状态 s=(x,y_{<t}) 上,它通过权衡期望优势与 KL 惩罚来更新 rollout 策略 \mu:
参数 \eta>0 控制更新步长。对 action probability 的优化可以解析求解:
要刻画 PMD 目标的最优解,并不需要构造 PMD 目标的 IS 估计量。 对上式两边取对数,然后对 a\sim\mu(\cdot\mid s) 求平均。
利用 \mathbb E_{a\sim\mu}[A^\mu(s,a)]=0,
可得 \log Z_\mu(s)=D_{\mathrm{KL}}(\mu\|\pi^+),
因此
这个条件在所有位于支持集内的状态和动作上都成立。接下来可以利用贝尔曼方程消去剩余的 A^\mu(s_t,y_t) 项。
基于 rollout 策略 \mu 的贝尔曼方程
固定 rollout 策略 \mu。其价值函数 V^\mu(s) 表示:从前缀 s 出发,继续使用 \mu 完成回答时的期望奖励。由于回答本身也由 \mu 生成,因此不需要 IS 修正。
对于自回归生成,追加一个 token 后,状态会确定性地转移为 s_{t+1}=(s_t,y_t),其中 s_t=(x,y_{<t})。在只包含终局奖励、且 V^\mu(s_{T+1})=R(x,y) 的情况下,贝尔曼方程给出
这些恒等式沿每条轨迹都成立。对时间步求和后,所有中间价值项都会望远镜消去,只留下观测到的奖励和 V^\mu(x);后者可以直接利用该 prompt 在 \mu 下的多条 rollout 进行估计。
BPO 的核心:PMD 的无 critic 重构
沿一条回答对 PMD 条件求和,并代入 \sum_t A^\mu(s_t,y_t)=R(x,y)-V^\mu(x),即可得到一个只包含策略概率、终局奖励和 prompt baseline 的条件。将它的残差定义为
BPO 的核心公式就是下面这个对 PMD 的无 critic 重构:在 rollout 分布下最小化轨迹残差的平方,
其中,\phi(x) 是 prompt 上任意的正权重函数;下文会给出它的具体选取方式。
该目标定义在 \mu 下,不需要任何 IS 权重。BPO 定理 1 证明,它与 PMD 具有相同的最优解。
flowchart TD
    A["PMD 最优性条件"] --> C["逐 token 的优势条件"]
    B["贝尔曼方程"] --> D["优势沿序列望远镜求和"]
    C --> E["轨迹级残差 δ"]
    D --> E
    E --> F["平方残差目标"]
    F --> G["线性化 + 二元 KL 近似"]
    G --> H["实用 BPO loss"]
图 2|BPO 的推导路线。 PMD 给出逐 token 的最优性条件,贝尔曼方程把中间状态价值沿轨迹消去,最终得到不需要单独训练 critic 的轨迹级目标。
4. 与 score centering 共享的梯度
BPO 在残差变量上,将平方损失围绕 \pi=\mu 时的残差进行线性化。对于奖励方差非零的 prompt,它取 \phi(x)=1/\operatorname{Std}_{y\sim\mu}[R(x,y)]。利用同一组回答估计该尺度和 V^\mu(x),可得到 group-normalized advantage \hat A,此时 token 梯度为
当使用相同的 advantage 权重并固定 \mu 时,这也是全词表 score centering 的核心梯度。 参见 Score Centering Stabilizes Off-policy Reinforcement Learning,§4 和附录 A.3。
Score centering 的推导从 drift 出发。在一个固定前缀上,定义
score g_t(v)=\nabla_\theta\log\pi_\theta(v\mid s_t),
其均值为 \bar g_t=\mathbb E_{v\sim\mu(\cdot\mid s_t)}[g_t(v)]。
于是
减去 \bar g_t 即可消除 drift。它与 BPO 的联系来自
BPO 通过近似其 PMD 重构得到这一表达式;score centering 则通过减去 score 的均值得到它。
5. 两种实用近似
BPO:二元 KL + 平滑
BPO 使用“采样 token 与词表其余部分”构成的二元 KL,来替代完整的 reverse KL。记 p_t=\pi_\theta(y_t\mid s_t),q_t=\mu(y_t\mid s_t),则
固定 q_t,可得恒等式
BPO 对这个补概率比率加入平滑:
其实用的逐 token 损失为
其中,\operatorname{sg} 表示对乘子停止梯度,C 用于设置上限;mask 沿用 GRPO 风格、依赖 advantage 符号的裁剪规则,只是将裁剪对象换成 \omega_t:
Score centering:top-k 概率与建模后的尾部
Score centering 保存 sampler 的 top-k 概率(默认 k=128),并使用 trainer 的概率来近似其余部分。在一个固定前缀上,令 p_v=\pi_\theta(v\mid s_t)、q_v=\mu(v\mid s_t),并令 H 表示 sampler 的 top-k token 集合:
利用 \sum_v p_v g_t(v)=0,修正项可以化简为
在损失函数中,各系数均做 detach。
简言之,两者的差别只在于如何近似 \nabla_\theta D_{\mathrm{KL}}(\mu\|\pi):BPO 使用二元近似,而 score centering 使用 top-k 近似。
BPO 与 score centering 对比
| 对比维度 | BPO | Score centering |
|---|---|---|
| 理论出发点 | 从 PMD 最优性条件出发,利用贝尔曼方程将逐 token advantage 沿轨迹望远镜消去,得到无 critic 的轨迹级残差目标 | 从 off-policy policy gradient 的 score drift 出发,直接减去 behavior policy 下的平均 score |
| 完整形式的目标梯度 | 线性化后得到 -\hat A\,[g_t(y_t)-\mathbb E_{v\sim\mu}g_t(v)] | 直接构造 -\hat A\,[g_t(y_t)-\mathbb E_{v\sim\mu}g_t(v)] |
| 两者何时等价 | 在使用相同的 \hat A、固定同一个 \mu,并且都精确计算 full-vocabulary reverse-KL 梯度时,两者给出相同的 token 梯度 | 同左;这是“梯度等价”,并不意味着两者的原始推导、完整目标函数或实用近似完全相同 |
| KL / 平均 score 的实用近似 | 将词表压缩成“采样 token”与“其余 token”两类,使用二元 reverse KL | 保存 sampler 的 top-k token 及其概率;对尾部使用 \hat q_v=\rho p_v 建模 |
| 最终修正形式 | 对采样 token 的 score 乘以标量 \omega_t=(1+\epsilon-q_t)/(1+\epsilon-p_t) | 在采样 token 的 score 上减去 top-k score 的加权和 \sum_{v\in H}(q_v-\rho p_v)g_t(v) |
| 梯度方向 | 仍与采样 token 的 g_t(y_t) 共线,只改变该 token 的梯度大小 | 一般不再与 g_t(y_t) 共线;top-k 中其他 token 也会直接贡献梯度方向 |
| rollout 侧需要保存的信息 | 每个采样 token 的 behavior probability q_t;每个 token 为 O(1) | 每个位置的 top-k token ID 与 behavior probability;每个 token 为 O(k),论文默认 k=128 |
| trainer 侧计算 | 只需采样 token 的当前概率 p_t 和常规 NLL,容易作为 GRPO/PPO loss 的标量权重接入 | 需要取得 top-k token 的当前概率并对相应 score 求加权和,计算和实现更复杂 |
| 近似精度 | 二元化会丢失“其余词表”内部的概率重分配信息;只有采样 token 与补集的总质量被保留 | top-k 显式保留主要 probability mass;k 越大、尾部模型越准确,就越接近 full-vocabulary centering |
| 数值稳定手段 | 加性平滑 \epsilon、上限 C,以及依赖 advantage 符号的 clipping mask | 通过 top-k 截断与归一化系数 \rho 建模尾部;损失中的系数 detach |
| 与 importance sampling 的关系 | 不使用 p_t/q_t;补概率比率是从二元 reverse-KL 梯度导出的 mismatch-correction weight | 不使用 p_t/q_t;通过减去 behavior policy 下的平均 score 消除 action-independent drift |
| 理论保证 | 近似之前的轨迹级平方残差目标与 PMD 具有相同最优解;实用 BPO loss 还包含线性化、二元 KL、平滑和裁剪等近似 | 主要保证是去除 score drift;通常不直接继承 BPO“与 PMD 具有相同最优解”的定理 |
| 多 behavior policy / partial rollout | 原则上可以让每个 token 使用实际生成它的 \mu_t 和 q_t | 原则上可以让每个 token 使用实际生成它的 \mu_t 及对应 top-k 分布;但保存与通信成本更高 |
| 二者都没有自动解决的问题 | 错误或高噪声的 advantage、跨 behavior policy 混合后不再合适的 group baseline,以及未被 rollout 元数据正确描述的采样过程 | 与 BPO 相同;score centering 修正的是 score drift,而不是 advantage estimator 本身 |
| 工程取舍 | 更轻量、通信开销低、适合直接替换现有 token-ratio loss | 更接近 full-vocabulary 修正,但需要更高的 rollout 存储、通信与反向计算开销 |
核心结论: 如果主要目标是以最小系统改动稳定 off-policy 训练,BPO 更像一个轻量的标量重加权方案;如果能够承担 top-k rollout 元数据和额外反向计算,并希望更完整地逼近 \mathbb E_{v\sim\mu}g_t(v),score centering 更直接。两者都不能替代对 advantage estimator 和真实 behavior policy 的正确建模。
6. 实验结果
论文在 Qwen3-30B-A3B-Base 上比较了 BPO、GRPO-ClipHigher、GSPO、CISPO 和 DPPO;训练数据为 DAPO-Math-17k 的英文子集。实验只改变 policy loss。每个 rollout batch 包含 256 个 prompt,每个 prompt 采样 16 条回答,再拆成 8 个 mini-batch。训练共运行 400 个 rollout batch,即 3,200 次优化器更新;最大回答长度为 16,384 token。所有方法均使用 rollout-router replay。
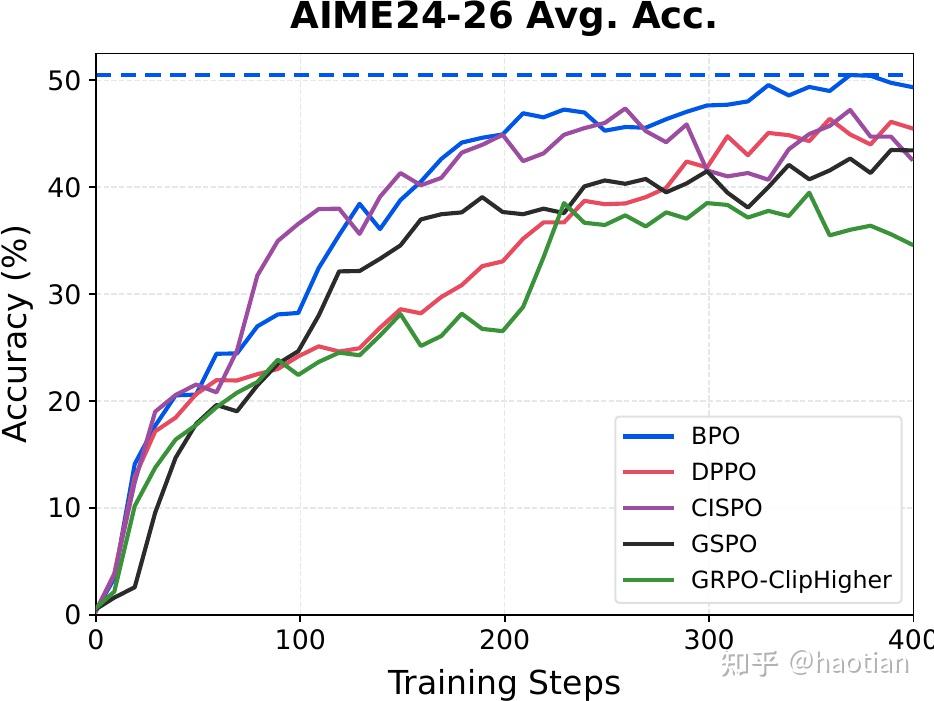
图 3|训练过程中的评测准确率。 曲线表示 AIME 2024–2026 上 Avg@32 准确率的平均值;每题采样 32 条回答来估计 Pass@1。蓝色虚线表示 BPO 的峰值平均准确率。来源:BPO 论文图 1。
| 方法 | AIME 2024 | AIME 2025 | AIME 2026 | 平均值 |
|---|---|---|---|---|
| GRPO-ClipHigher | 45.6 | 34.8 | 38.0 | 39.5 |
| GSPO | 50.3 | 35.5 | 44.6 | 43.5 |
| CISPO | 52.7 | 39.0 | 50.4 | 47.4 |
| DPPO | 55.8 | 39.2 | 44.2 | 46.4 |
| BPO | 57.4 | 41.0 | 53.0 | 50.5 |
Avg@32 准确率(%):对每道题采样 32 条回答,并对正确性取平均,以估计 Pass@1。每一行报告该方法在三个基准上的平均准确率达到最高时所对应的 checkpoint。来源:BPO,表 1。
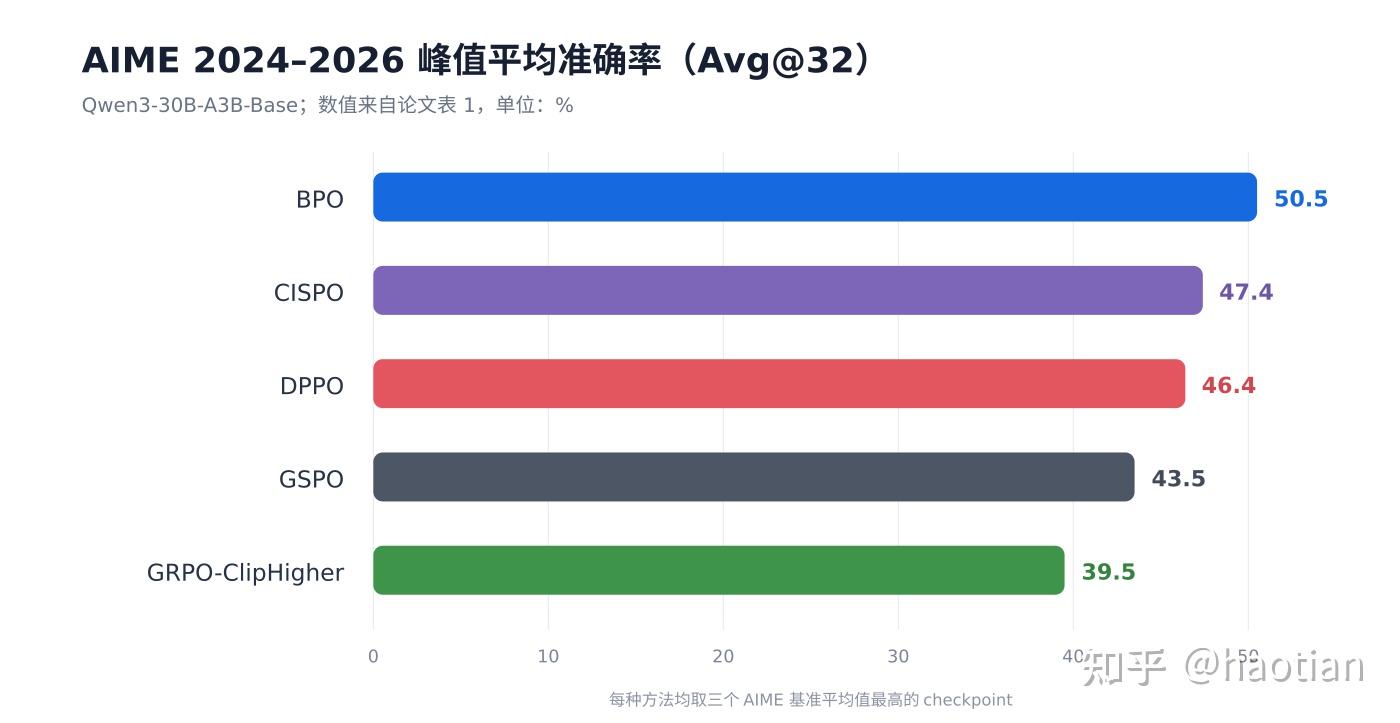
图 4|峰值平均准确率对比。 BPO 在五种方法中取得最高的三基准平均准确率;柱长直接对应上表的“平均值”列。
BPO 的峰值平均准确率比 GRPO-ClipHigher 高 11.0 个百分点,比这一指标下最强的基线 CISPO 高 3.1 个百分点。在训练结束这一固定时间点,BPO 达到 49.4%,而此时最强的基线 DPPO 为 45.5%。
作者:haotian
https://zhuanlan.zhihu.com/p/2084586770000261374