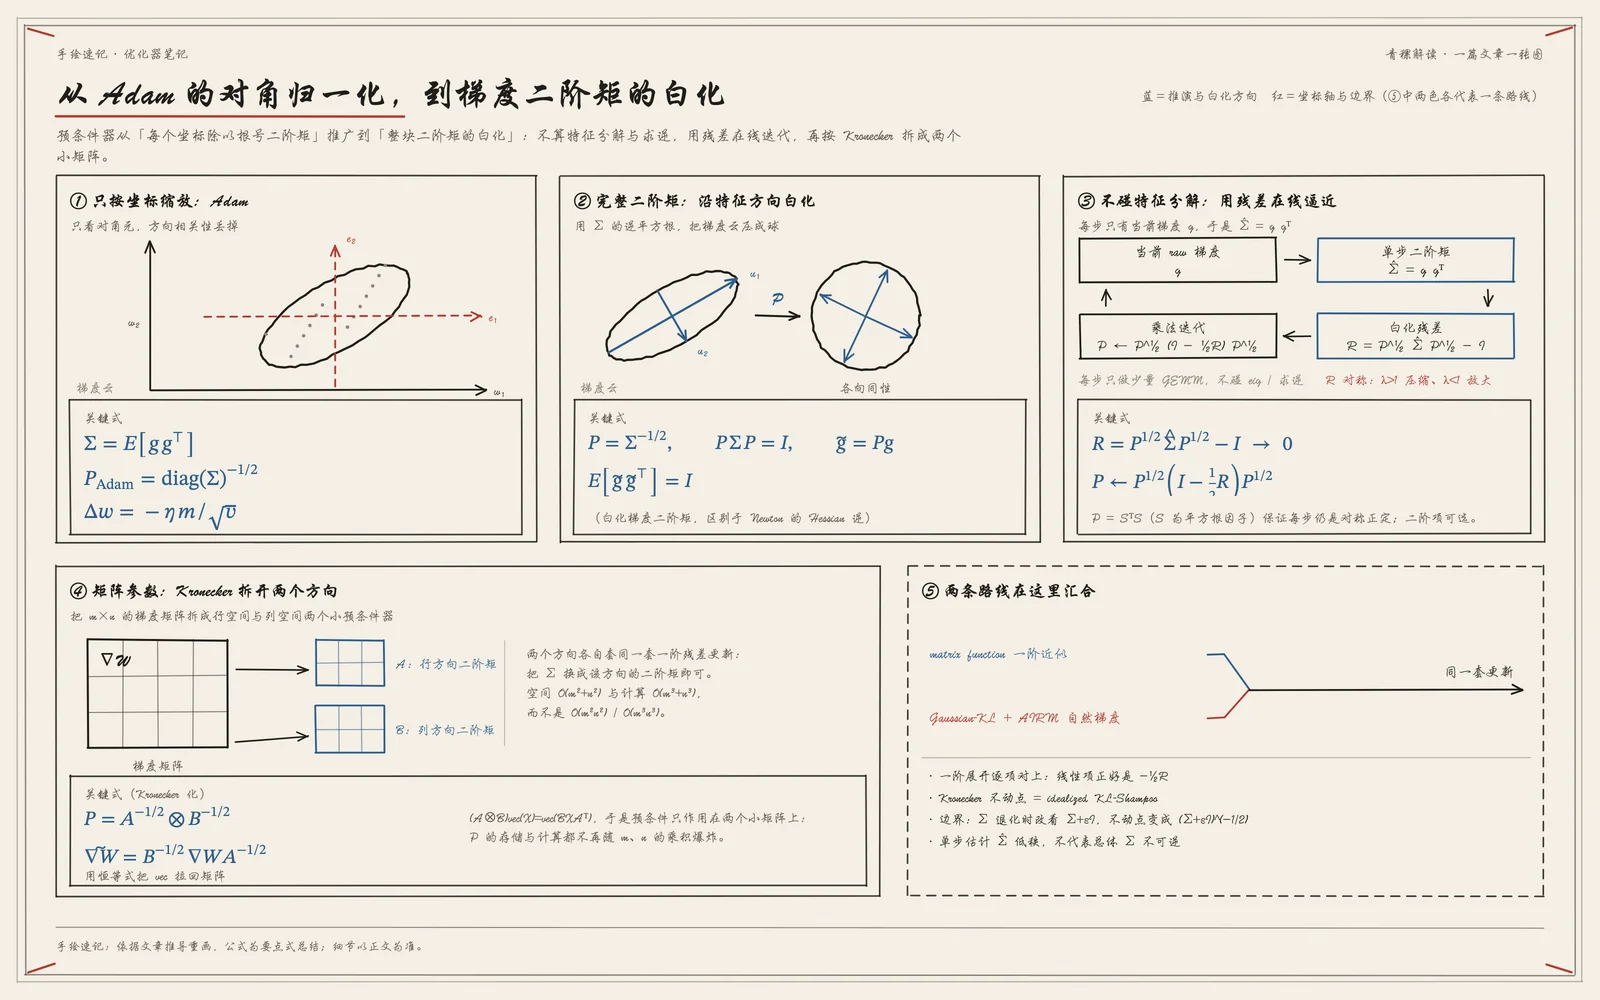
Adam 的核心操作之一,是利用梯度的二阶矩对更新做归一化。对第 i 个参数坐标,Adam 维护 v_{t,i}\approx \mathbb E[ g_i^2],计算参数更新 \Delta \theta_i\propto-\frac{ m_i}{\sqrt{ v_i}}.
如果把梯度二阶矩写成 H=\mathbb E[ g g^\top],那么 Adam 实际上只保留了 H 的对角部分
因此 Adam 的预条件器可以写成
从这个视角出发,不免得到一个很自然的问题:
如果不局限于二阶矩对角元,而是保留梯度不同方向之间的相关性,会得到什么样的优化器?
不妨直接推广,
由于 H 是梯度 covariance,它天然是对称半正定矩阵。为了让通常意义下的 inverse square root 有定义,下面先假设 H\succ0;如果 H 存在退化方向,实际实现中通常对它加入一个很小的 damping,使用 ( H+\varepsilon I)^{-1/2}。在这个假设下, P 也是对称正定矩阵,即 P\succ0.
此时参数更新变成
注意这里的 -1/2 次方和 Newton 法里的 H^{-1} 是两件不同的事情。Newton 的 H 是 Hessian,并通过 - H^{-1} g 求解局部二次模型;这里的 H 是梯度二阶矩,目标更接近 whitening / RMS normalization。
1. 与其直接计算 H^{-1/2},不如求解 whitening 方程
直接维护 P= H^{-1/2} 的问题很明显:矩阵 inverse square root 很贵。但 P= H^{-1/2} 有一个等价条件 P H P= I. 通过这个转化
可以定义预条件后的梯度 y= P g,那么理想状态就是
也就是说
2. 在线训练中,可以直接估计 P H P
实际训练过程中通常没有精确的 H=\mathbb E[ g g^\top],但每一步都有当前梯度 g_t. 于是可以构造 C_t=( P g_t)( P g_t)^\top,它满足
所以 C_t 是 P H P 的一个估计。因而 P H P= I 就可以在线写成 C_t- I\to 0.
需要注意,真正要求的是 \mathbb E[ C_t]= I,而 C_t- I 只是一个 noisy stochastic residual。
到这里,原问题已经可以简化为
3. C_t- I 包含了什么信息?
这一节,我们先来看看这个 C_t- I 可以如何理解。由于 C_t 是一个对称阵,不妨对其做特征分解,
这里 U 的列向量给出了当前 C_t 的特征向量,而 \lambda_i 则是对应的特征值。如果 \lambda_i>1,说明这个方向被放得太大,应当压缩;如果 \lambda_i<1,说明这个方向仍然太小,应当放大。因此 C_t- I 实际上就是一个各向异性的白化误差。
相比之下,Adam 只能看到 \operatorname{diag}( H),因此只能逐元素调整;而此处 C_t 中的 off-diagonal 信息则允许 optimizer 识别旋转后的高方差方向和低方差方向。
4. 如何实际迭代更新 P?
现在真正的问题只剩下 C_t\to I 应该对应什么样的 P 更新?
最直接当然是定义一个平方损失函数
但直接对上式求梯度需要计算 H,复杂度很高,而且更新后也未必始终保持 P\succ0 这样一个约束。
考虑到 GPU 做乘法运算比较高效,一个直接想法是乘法迭代,
那么只要 P\succ0 并且 A 可逆,就有 P^+\succ0. 于是问题进一步变成应该选择什么 matrix function f 来定义 A=f( C_t),使得 C_t\to I 对应 P\to H^{-1/2}。
5. 从 matrix function 看理想 correction
暂时先考虑一个最简单的 whitening 问题。假设随机向量 y 的 covariance 是 C_t=\mathbb E[ y y^\top],如果直接做 y^+= A y,那么 C_t^+= A C_t A^\top. 若取对称矩阵 A= C_t^{-1/2},自然直接就有 C_t^+= I. 所以 inverse square root 本身就是最自然的一种 whitening correction.
这提示我们可以把 preconditioner update 写成某种
不过,将这一操作放进在线优化器后,情况会有所不同。训练过程中观察到的 C 往往不是精确的全局协方差,而只是由当前 mini-batch 得到的随机估计,因此直接做 A= C^{-1/2} 过于激进。因此,更自然的做法不是每一步都“完全 whiten”,而是只向 whitening fixed point 移动一部分。
一种简洁的构造是
当然,真正计算 C^{-\eta/2} 本身仍然需要 matrix function,工程上不划算。这时候就可以来引入近似。
6. 对 matrix function 做近似
如果当前 C 已经不离 I 太远,令 C= I+ E,则 C^{-\eta/2}=( I+ E)^{-\eta/2}. 做一阶 Taylor 展开有
于是自然得到
作为最低成本的一阶 matrix-function approximation.
这个形式特别适合 optimizer,其中的矩阵 C 来自一个 Gram matrix,运算均为正常的加减法,没有特征分解、求逆、矩阵对数这些相对昂贵的操作。
当然如果愿意多付出一些计算开销,可以继续保留二阶项:
特别地,取 \eta=1,
可以把以上方法理解成
而这和 Muon / Newton-Schulz 一类方法的工程哲学其实很接近:避免 eig/SVD,把 matrix function 改写成少量 GEMM。
7. 如何在实现中维护 preconditioner 更新?
上面的这种乘法迭代可以直接作用在 P 上,但在实际实现中,我们还希望每一步都显式地保持 P 的对称正定结构。一个自然的参数化方式是引入其平方根因子 R,写成 P= R^\top R。这样,更新不再直接修改 P,而只需要做更新 R^+= R A.
由于 ( R A)^\top( R A)= A^\top R^\top R A,而这里的 A=f( C) 是 C 的对称 matrix function,满足 A^\top= A,所以新的因子确实对应于 P^+= A P A.
于是,一个极简版的在线算法可以写成
然后用 P_t= R_{t+1}^\top R_{t+1} 预条件来做真正的参数更新。值得注意的是,这里第一个 y_t 是用当前的 raw gradient g_t 来做计算,而真正的更新 u_t 则可以用新的预条件 P_t 来处理梯度的动量 EMA 来算。这是因为动量中包含参数跨时间的 correlation,因此更新 P_t 用 raw gradient 更能反映当前的 whitening 状态。
8. 从向量预条件器到矩阵参数
到目前为止,我们讨论的都是向量情形:
然而,在真实神经网络中,参数通常是形如 W\in\mathbb R^{m\times n} 的矩阵,将其展平维度会变成 d=mn,对应的 full preconditioner 需要具有 P\in\mathbb R^{mn\times mn} 这样的 shape,显然计算开销过大,无法直接实现。因此,需要引入结构化 approximation。一种自然的选择是 Kronecker factorization
其中 P_a\in\mathbb R^{m\times m}, P_b\in\mathbb R^{n\times n}. 对于矩阵梯度 G\in\mathbb R^{m\times n},利用 Kronecker 与向量化的恒等式,有
于是可以直接定义预条件后的矩阵梯度 Y= P_a G P_b,这样就不必构造巨大的 mn\times mn covariance,而只需分别考察两个 mode 上的 covariance:
理想的 fixed point 对应于
可以证明,这两方程与 idealized KL-Shampoo 的 Kronecker covariance fixed point 等价。于是,两边都可以进行与前面相同的一阶更新
同时维护
并做更新
就得到一个实际可实现的 Kronecker 版本。只需存储两个较小的矩阵,而不需要面对 mn\times mn 的完整计算量。后者空间上需要 O(m^2n^2),而 Kronecker 版本只需 O(m^2+n^2),计算上也从 O(m^2n^2) 降到 O(m^2n+mn^2+m^3+n^3),显著降低了开销。
9. KL-Root-Kron 的正式推导
以上到此的推导,是在@涮月亮的谪仙人对发在群里的一份报告的理解基础上补充而来的。
下面回到原报告的逻辑。报告并非从 inverse-root matrix function 出发,而是先在 Gaussian-KL 目标上定义 KL-Root-Kron,再利用 SPD manifold 上的 affine-invariant metric 推出相应的在线更新。具体来说,报告首先定义
将 Gaussian-KL 展开,可以得到
另一方面,利用 KL 散度对可逆线性变换的不变性,\mathcal{J}( P) 也可以写成
因此,这个目标仍然是在形式化 P H P\rightarrow I.
问题在于,若直接对 P 使用 Euclidean gradient,仍然会出现 P^{-1} 项,
解依然为 P= H^{-1/2},依然需要求逆。接下来真正关键的一步,是在对称正定矩阵上使用 affine-invariant metric(AIRM)。在这个度量下,Riemannian gradient 是 Euclidean gradient 的 P-共轭,即 P(\nabla_{ P}\mathcal{J}( P)) P。令当前样本对应的 C= P g g^\top P,便有
正好消去原本的 P^{-1} 项。接着采用 congruence update P^+= A P A,其中取 A= I-\frac{\eta}{2}( C- I)。对这个更新做一阶展开:
可见它正好匹配负的 AIRM natural-gradient direction。
从严格几何推导看, A= I-\frac{\eta}{2}( C- I) 是与 AIRM natural gradient 一阶匹配的 congruence update;而从 matrix-function 角度看,它又恰好是 C^{-\eta/2} 在 C\approx I 附近的一阶近似。
注意前面的推导都假设 H\succ0。但实际的梯度二阶矩可能只有半正定性:如果某些方向始终没有梯度分量, H 就会存在零特征值。
此时,对任何有限的正定矩阵 P,都有 \operatorname{rank}( P H P)=\operatorname{rank}( H)<d,因此 P H P= I 不可能成立。
也就是说,原 whitening 目标没有可供迭代收敛到的有限正定解。这里说的是总体二阶矩 H 的退化,单步估计 C_t 的低秩本身并不意味着 H 不可逆。
实践中需要将二阶矩替换为 H_\kappa= H+\kappa I\succ0,其中 \kappa>0,相应的目标变成
本文主要解释理论上的 whitening 关系和更新方向,因此其余公式暂时省略这一项,统一在 H\succ0 的假设下做分析讨论。
10. 从两条路线回看 KL-Root-Kron
本文尝试解释了 whitening update 的直观来源。从 Adam 的 diagonal gradient second moment 出发,预条件器是 P_{\rm Adam}=\operatorname{diag}(\mathbb E[ g g^\top])^{-1/2};将它推广到完整的矩阵二阶矩,则得到 P=(\mathbb E[ g g^\top])^{-1/2}。
接着不直接计算 inverse root,而是利用等价条件 P H P= I 在线构造 C_t=( P_t g_t)( P_t g_t)^\top,并将 C_t- I 作为 stochastic whitening residual。
从 matrix-function 的角度,希望施加类似 A\approx C^{-\eta/2} 的相对 correction。为了避免真正计算 matrix function,采用一阶近似再通过
持续维护 SPD preconditioner。最后,为了让这套方法能够用于大模型中的矩阵参数,施加 Kronecker、diagonal 或 block 等结构化约束。
而原报告则进一步说明,这种更新可以从 Gaussian KL 目标以及 SPD manifold 上的 affine-invariant natural gradient 严格推出,同时其 Kronecker stationary equations 与 idealized KL-Shampoo 一致。
作者:Himalalps
https://zhuanlan.zhihu.com/p/2078425222001308317