当全世界都在疯狂给大语言模型堆算力、卷数据、扩上下文时,我们是否曾停下来质疑过那个统治了整个生成式AI时代的底层铁律——Next Token Prediction(下一个词预测)?
人类说话写文章,从不是大脑里机械地蹦出一个字才去想下一个字;我们永远是 “先有概念与意图,后有遣词与造句”。
近日,来自上海人工智能实验室与上海交通大学LUMIA Lab等联合团队,重磅发布了 NCP-ArchPreview 技术报告。
📄论文链接:https://huggingface.co/papers/2609.10715
🤗 Checkpoints:https://huggingface.co/collections/ArchSpace-Collection/ncp-archpreview
🐱💻GitHub Repo:https://github.com/LUMIA-Group/ncp_olmo_eval
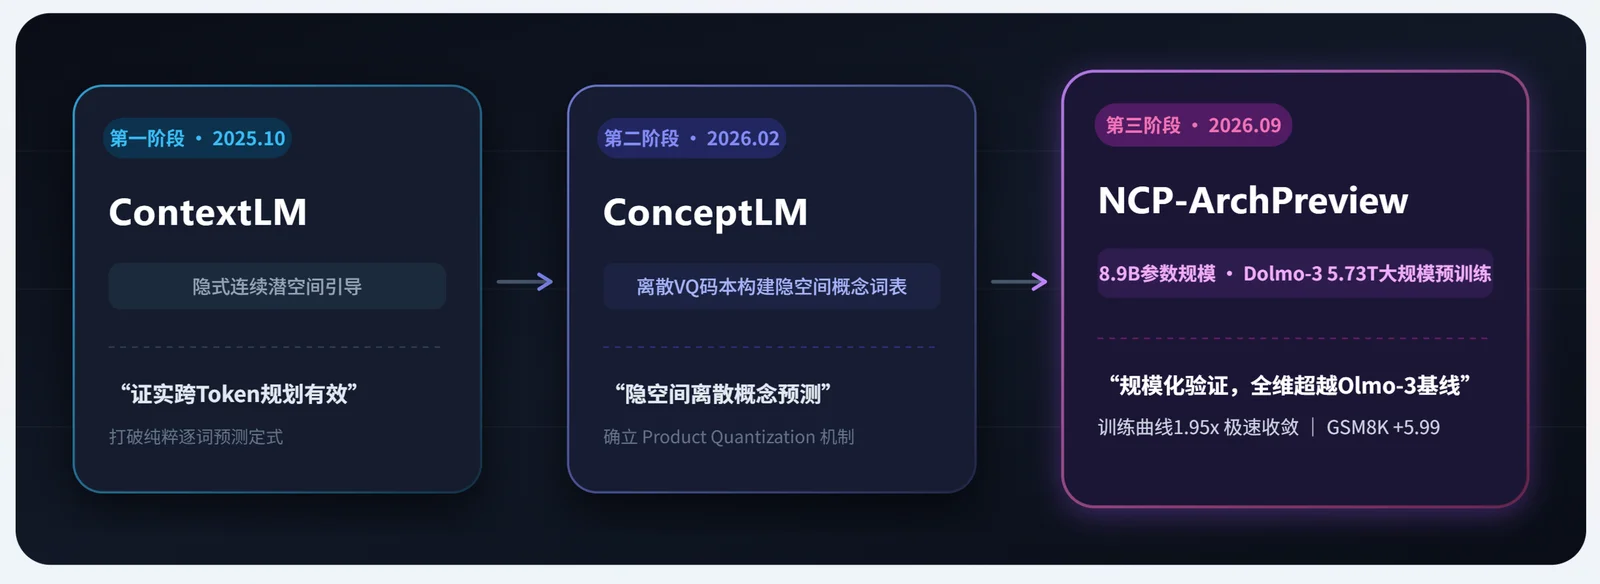
伴随这一报告的公开,一条清晰贯穿了一年多、由浅入深、层层突破的原创架构演进脉络跃然纸上:
从最初隐式建模上下文的 ContextLM,到确立离散语义概念空间的ConceptLM,再到如今在 5.73万亿(5.73T)Token 工业级预训练中大放异彩的 NCP-ArchPreview(8.9B)。
今天,我们就来聊聊这项让大模型告别“字面近视”,实现“概念级规划”的系列工作。
痛点与思考:统治大模型的 NTP,为什么遭遇了“语义近视”?
大语言模型(LLM)的繁荣,建立在极简而优雅的 Next Token Prediction(NTP)之上。然而,随着模型规模冲向百亿、万亿,这一范式的局限也愈发明显:
1、 粒度过细与缺乏前瞻:Token 只是表层的符号切片,一个完整的概念(如“全频带阻塞干扰”)往往横跨多个 Token。只监督下一个 Token,如同“盲人摸象”,模型缺乏跨步长的全局语义规划能力。
2、 多词预测(MTP)的局限:尽管业界尝试过 Multi-Token Prediction(同时预测未来几个词),但它依然受困于表层的 Token 空间,学习难度呈组合级爆炸,且在小参数模型上很难见效。
回望其他领域:计算机视觉已从预测像素走向预测潜空间语义(如 V-JEPA、Latent Diffusion);强化学习与机器人也早已转向轨迹级抽象。语言建模的监督信号,为什么不能跃迁到更高的抽象层?
为此,团队开启了一场系统性的架构探索:能不能让模型在潜空间(Latent Space)中直接预测“概念”(Concept),并用高层概念反哺、引导底层的逐词生成?
演进三部曲:Next-Concept-Prediction 是如何一步步炼成的?
这项研究并非一蹴而就,而是历经了三次关键的技术跨越:
第一步:初探水温 —— ContextLM 与隐式上下文预测
论文:Context-level Language Modeling by Learning Predictive Context Embeddings
链接:https://arxiv.org/abs/2510.20280
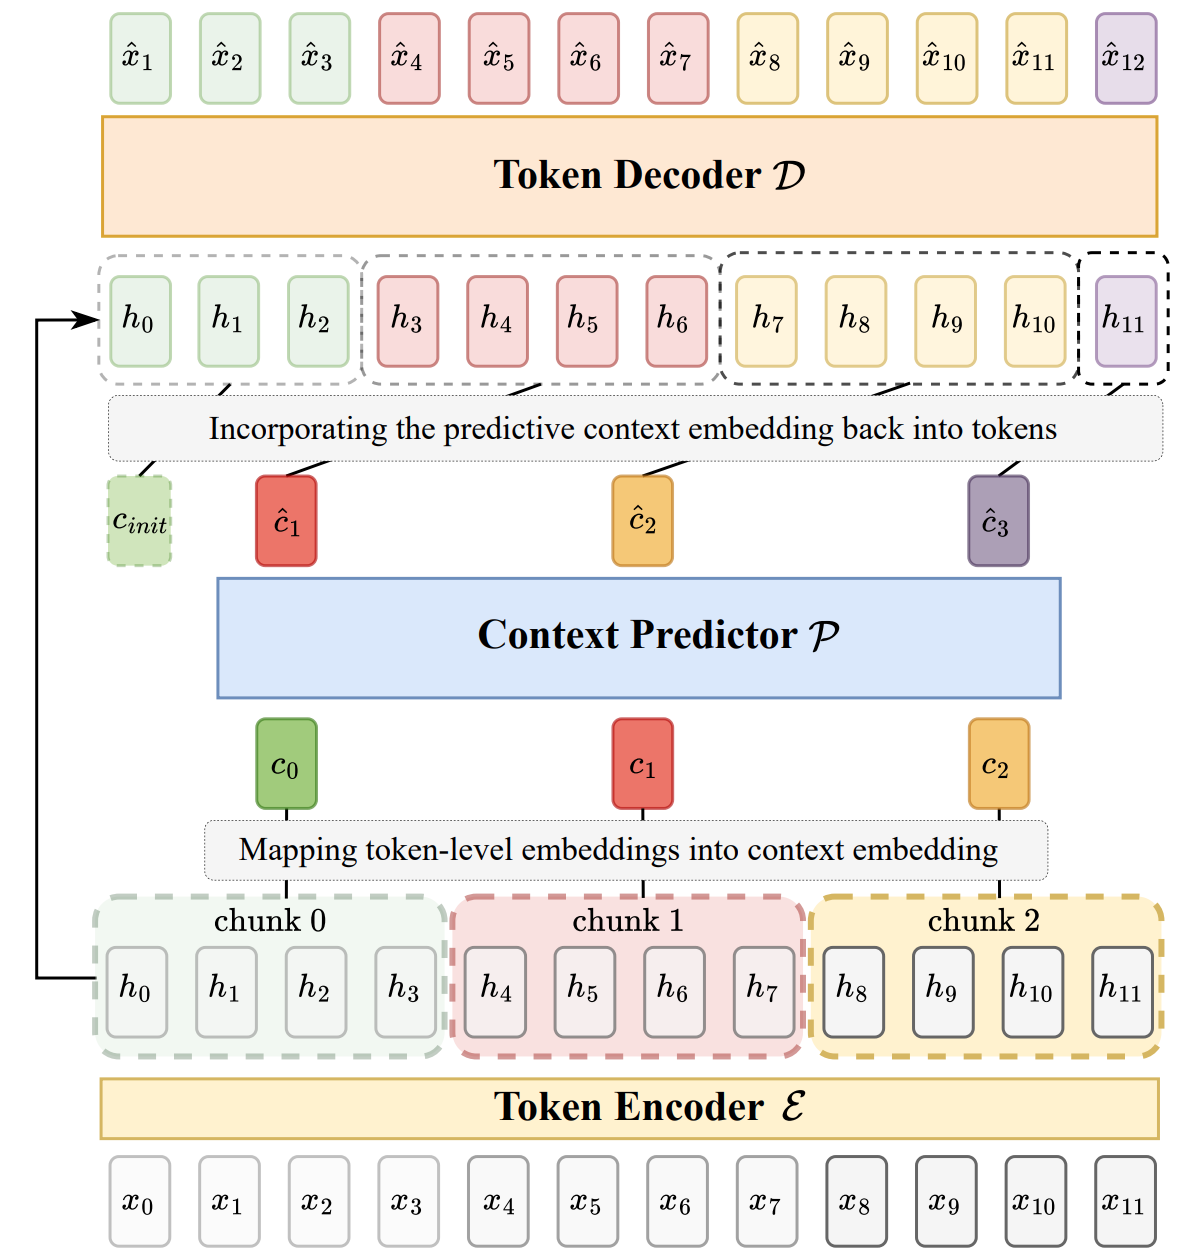
团队最初的思考是:如果让模型在生成前,先预测一段 Token 的连续语义表示,管用吗?
于是有了 ContextLM。它的核心设计包括:
- 将模型解耦为 Token Encoder、Context Predictor 和 Token Decoder;
- 将相邻的几个 Token(如 w=4)做均值池化,提炼为连续的 Context Embedding,构成连续潜空间;
- 由 Predictor 在潜空间里自回归预测下一个 Context范围内的tokens,再广播注入 Decoder 指导下一个词的生成。
在不打破自回归因果的前提下,ContextLM 带来了显著的效率提升:
- 帕累托前沿外推:在 GPT-2 和 Pythia 架构上,ContextLM 仅用 61% 的参数量(省 39%)、77% 的训练数据 和 80% 的 FLOPs,就追平了基线困惑度(PPL);
- 注意力可视化清晰表明,模型对长距离指代和核心语义实体的关注度大幅提升。
但这留下了下一个追问:连续潜空间缺乏显式约束,依赖输出端每个token的cross-entropy loss来更新。潜空间中的概念,是否应该像单词一样,拥有自己离散、确切的“语义词表”?
第二步:确立范式 —— ConceptLM 与离散概念空间的诞生
论文:Next Concept Prediction in Discrete Latent Space Leads to Stronger Language Models
链接:https://arxiv.org/abs/2602.08984
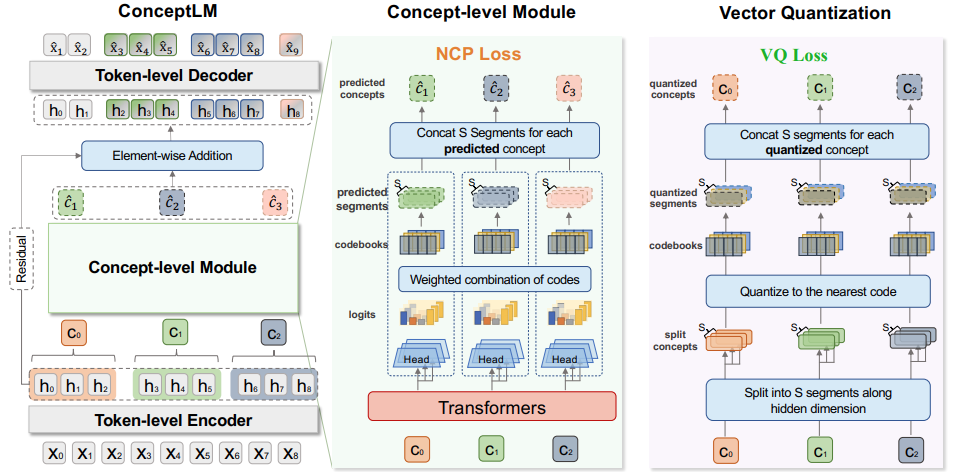
为了给潜空间预测立下“规矩”,团队正式提出了 Next Concept Prediction (NCP) 范式,并打造了 ConceptLM:
1、 乘积量化(Product Quantization)构筑概念词表:利用向量量化(VQ)将连续潜状态切分为多个分段(Segment),每个分段在小型 Codebook 中查找最近邻。虽然每个小词表仅有 64~128 项,但组合起来的离散概念空间高达 NS,既轻量又极其庞大。
2、 可微的软预测(Weighted Combination):在预测未来概念时,模型输出 Codebook 上的概率分布,并以加权求和的方式重构连续概念向量,巧妙避开了离散采样的不可微难题。
3、 双轨联合训练:LNTP+LNCP+LVQ。NCP 迫使 Encoder 捕捉跨词的高层语义,而 Decoder 则在预测概念的指引下吐出具体的 Token。
实验证明,离散量化的引入极大增强了泛化性:
- 从零训练的 GPT-2/Pythia 模型在下游 13 项基准上全面碾压基线;
- 并在 Llama-3.1-8B 上通过仅 9.6B Token 的微量续训练,验证了即插即用的迁移能力。
至此,NCP 的理论闭环与机制验证全部就绪。但它能否经受万亿级(Trillion-token)超大规模工业预训练的洗礼?
第三步:万亿训练数据验证 —— NCP-ArchPreview 迈向万亿级潜空间大模型
技术报告:NCP-ArchPreview Technical Report: Moving towards Latent Space Language Models through Next Concept Prediction
链接:https://arxiv.org/abs/2609.10715
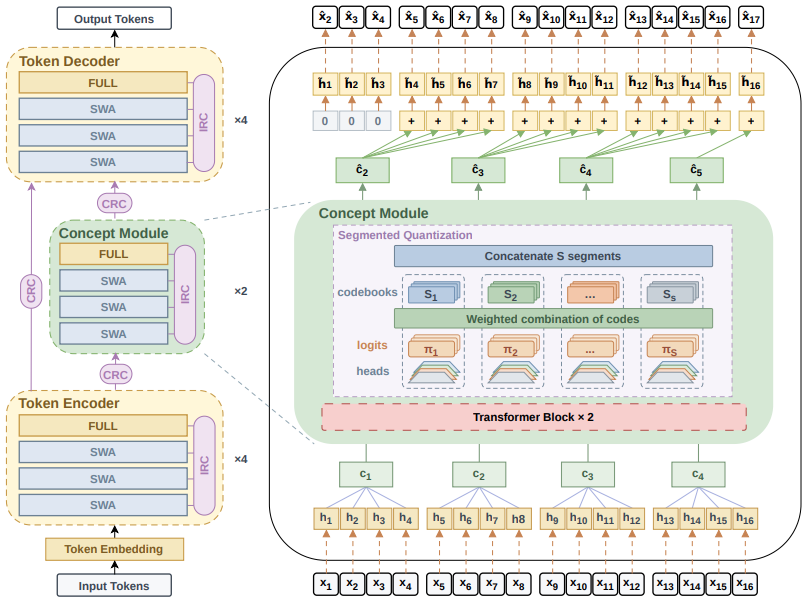
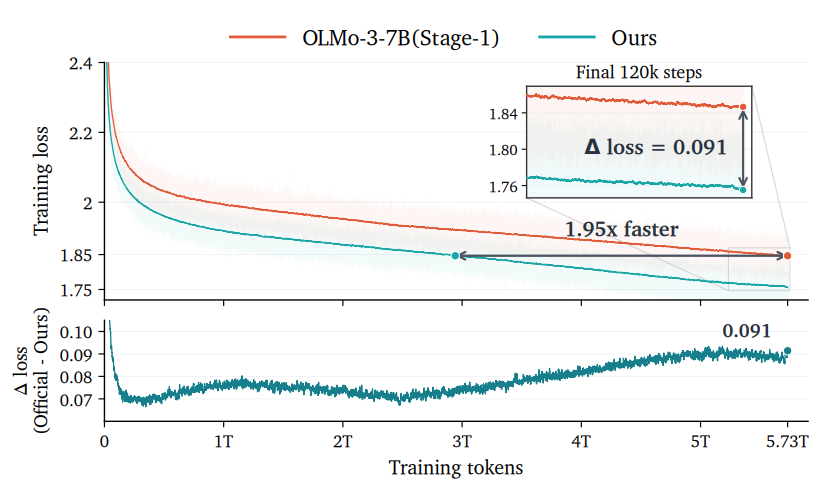
团队将该架构推向了真正的终极大考:基于 OLMo-3-7B 底座进行架构升级,构建了包含 16 层 Encoder + 8 层 Concept Module + 16 层 Decoder 的 8.94B 参数大模型——NCP-ArchPreview,并在 Dolma-3 数据集上完成了 5.73 万亿(5.73T)Token 的完整预训练!
在这一版本中,架构与系统工程迎来了全面进化:
- 分层残差连接(Hierarchical Residual Routing):引入模块内残差(IRC)与跨模块残差(CRC),打通 Encoder、Concept Module 与 Decoder 之间的深浅层通路;
- Muon 矩阵优化器与稳定性设计:深入剖析全矩阵优化器下注意力 Logit 的激增现象,沉淀出工业级训练的最佳实践;
- 全栈开源:公开全套权重、每 10 万步的训练 Checkpoint、评估框架及投机采样 Drafter 模型。
终极答卷:效果到底有多惊艳?
历经 5.73T Token 的锻造,NCP-ArchPreview 展现出了近乎代际跃迁的综合实力:
1. 训练收敛速度暴增 1.95 倍
在 Stage-1(5.73T tokens)预训练中:
- NCP-ArchPreview 仅消耗 51.3% 的训练数据,就达到了 OLMo-3-7B 跑完全程的最终 Loss(训练速度相当于提速 1.95x);
- 在最终收敛阶段,其 Loss 比同等数据的强基线低出整整 0.091!
2. 严苛对齐消融:不是“以大欺小”,而是架构胜出
有人会问:8.9B 比 7B 参数多了,性能好难道不是理所当然?
团队做了极其严格的等算力/等尺寸消融(对应论文 Fig. 3):
- 面对 34 层的“等算力基线”:由于 Concept Module 序列长度压缩了 4 倍,计算量锐减,8.9B 的 NCP-ArchPreview 实际计算量仅相当于 34 层标准模型,但 Loss 表现遥遥领先;
- 面对 40 层的“等参数基线”:NCP-ArchPreview 仅用其 85% 的计算量,就逼近了 40 层纯 Token 模型的极限效果,帕累托计算效率提升达 1.74x。
3. 下游任务全面开花,理科推理尤其耀眼
在 30 多个基准套件评测中,Stage-1 的下游宏观平均分提升了 +2.45 分。其中,尤其考验前瞻与严密逻辑的任务提升最为凶猛:
- GSM8K(数学推理):狂揽 +5.99 分(从 39.27% 跃升至 45.26%);
- MATH-500:提升近 2 个百分点;
- HumanEval(代码生成):提升 +4.28 分。
4. 潜空间生态的意外之喜:轻量适配与投机加速
学到的概念空间不仅在预训练中有用,在下游应用中更是“宝藏”:
- 17M 极速领域自适应:下游微调时,冻结整个 8.9B 骨干,仅更新 17M 参数的 VQ 概念模块,在代码/数学任务上性能甚至战胜了同等参数的 LoRA,且几乎不发生“灾难性遗忘”,显存节省 64%,吞吐提升 2 倍!
- 赋能投机采样(Speculative Decoding):将概念表示接入 DFlash2 块级并行草稿模型,以区区 0.04M 的微量参数开销,使平均接受长度(MAL)提升 4.17%(HumanEval 上达 +7.59%)。
超越 NTP,下一代基座模型的新蓝图
从 ContextLM 证实“潜空间预先规划”的可行性,到 ConceptLM 确立“离散概念词表”的标准范式,再到 NCP-ArchPreview 以 8.9B 规模、5.73T 工业级数据证明其无与伦比的 Scaling 能力与计算效率——
这项历经一年多打磨的工作清晰地告诉我们:大语言模型的演进终点绝不仅是粗暴的 Scaling Law,更是表征抽象层级的跃升。
让大模型学会像人一样,在落笔前“胸有成竹”,在表达时“意在笔先”。Next Concept Prediction(NCP) 不仅是一次成功的预训练目标改进,更为后 Transformer 时代的基座架构探索,推开了一扇通往潜空间智能的大门。