简介
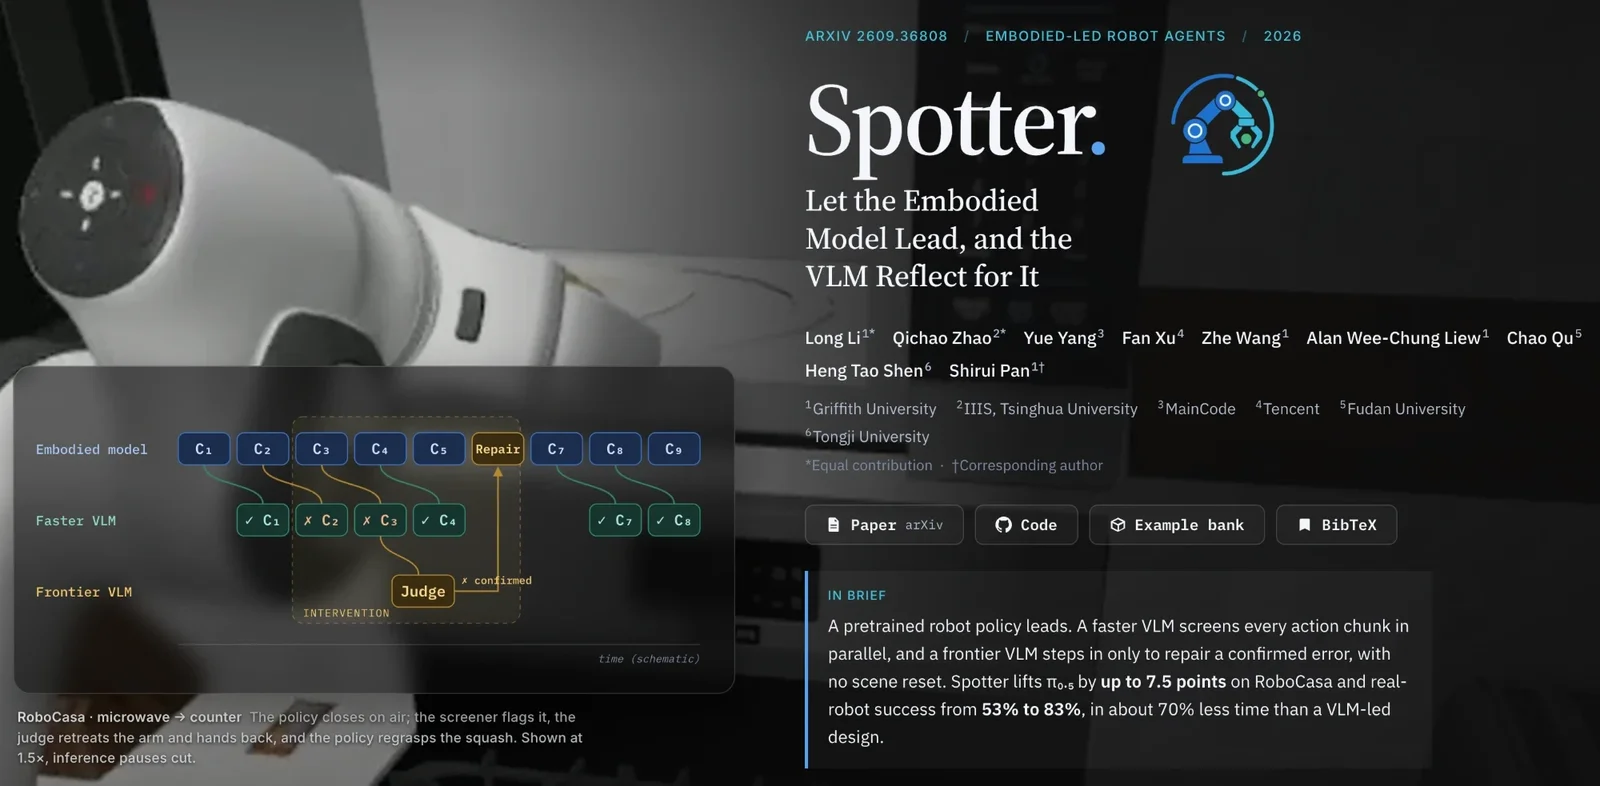
具身模型(VLA)失手后很难自己改错,而让 VLM 每一步都当指挥又太慢。Spotter 反过来:具身模型一直执行,本地 Qwen 并行盯着,确认出错时才由 VLM 出手修复并反思,修完交还控制。同样步数下成功率更高,成功的回合只多十几秒,本地一个千问就能跑。
论文:Spotter: Let the Embodied Model Lead, and the VLM Reflect for It
作者:Long Li*、Qichao Zhao*、Yue Yang、Fan Xu、Zhe Wang、Alan Wee-Chung Liew、Chao Qu、Heng Tao Shen、Shirui Pan†(*共同一作,†通讯作者)
单位:格里菲斯大学、清华大学交叉信息研究院、MainCode、腾讯、复旦大学、同济大学
arXiv:https://arxiv.org/abs/2609.36808
代码:https://github.com/zqc3117/Spotter
项目主页:https://zqc3117.github.io/Spotter
写在前面
语言模型变强,很重要的一条路是"自我纠错":先给出答案,发现不对,再改。我们最初想问的问题很朴素:具身模型能不能也这样?
答案让人有点失望。但顺着这个问题往下挖,我们得到了一个和主流做法相反的结论:与其让 VLM 指挥机器人的每一步,不如让机器人自己干,VLM 只在它出错时出手。这就是 Spotter。
一、一个被忽视的问题:VLA 不知道自己错了
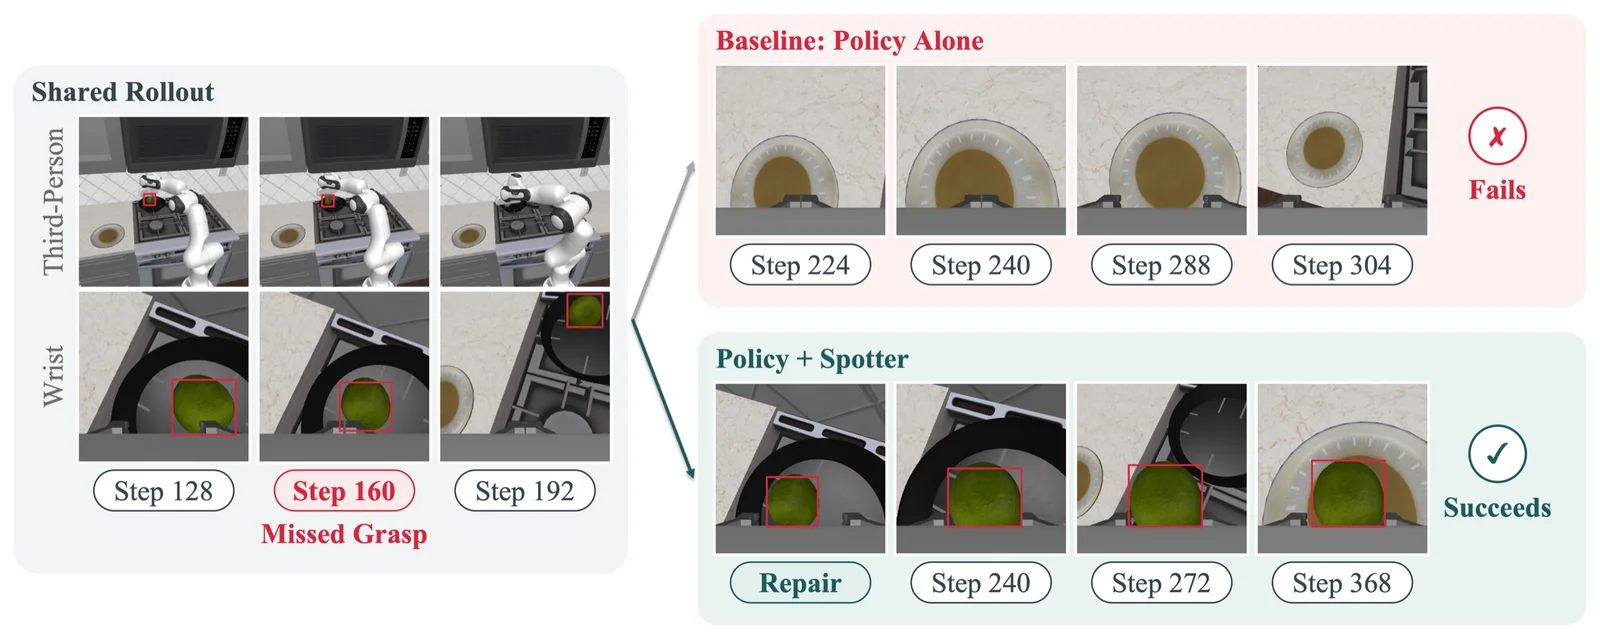
在机器人上跑过 VLA 的人,大概都见过下面这一幕:夹爪明明抓空了,机械臂却照着成功轨迹的样子,空着手把"东西"送到目标位置,整个过程毫无察觉。
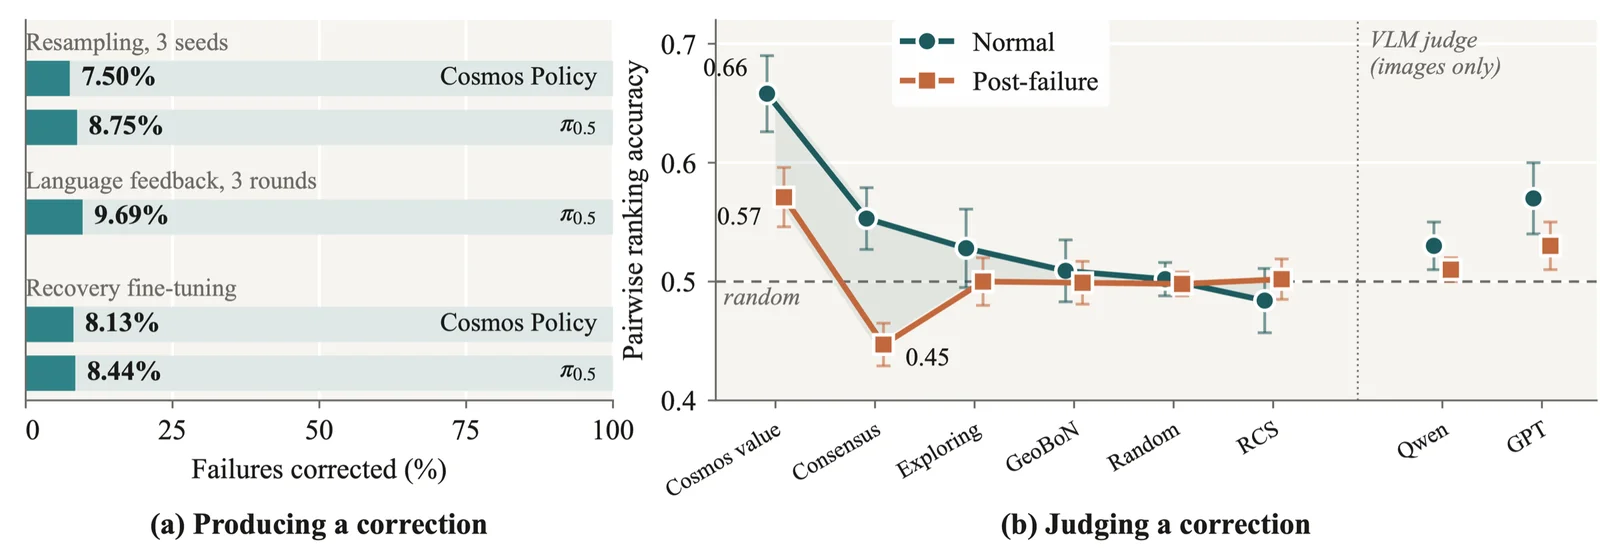
为了弄清楚它到底能不能改错,我们把"改错"拆成两件事来测:能不能给出一个修正,以及能不能认出哪个修正是对的。
第一件:给出修正。我们在 RoboCasa 上用 Cosmos Policy 和 π0.5 做实验,让 oracle 在抓取失败的瞬间叫停,再给模型三次机会,分三种方式:
- 换随机种子重新采样;
- 用一句话告诉它哪里错了,作为新指令;
- 用它自己 rollout 里的恢复数据做微调。
三种方式修好的失败都不到十分之一。告诉它错在哪,效果和换个种子差不多,因为 VLA 并不像语言模型那样能读懂指令、调整行为。恢复数据只占正常 rollout 的大约 3%,量少,覆盖的失败类型也窄。
第二件:认出正确的修正。这正是近来 test-time scaling 想做的事:同一个状态采几个候选,让打分器挑。我们发现,打分器在正常状态下还有些区分能力,可一旦发生失败,判断就掉到接近随机。
原因其实不复杂:
1、 模型和打分器只见过成功的示范,从没见过失败之后的状态;
2、 它们只看当前这一帧,不知道刚才已经试过什么。
想分辨"这次是在补救"还是"又在重蹈覆辙",需要回看整段经过,还要结合遥测、已执行动作这些文字信息。能做到这一点的,是 VLM。
二、让 VLM 当指挥,为什么不是好答案
把 VLM 和具身模型放在一起,现有的做法大多是 VLM-Led:VLM 每一步都先规划,再把具身模型当成工具调用,代表工作是 Harness VLA。
这种做法绕不开一个两难:VLM 该多久插手一次?
- 插手太勤,比如每走一厘米就问一次,机器人大部分时间都在原地等;
- 插手太少,让具身模型一口气跑一大段,等 VLM 回过头来看,错误可能已经无法挽回。
换个角度想,人做熟练的事情并不是这样。手先动起来,眼睛用余光留意着;只有察觉到不对劲,才停下来动动脑子,做一点局部修正。
三、Spotter:具身模型主导,VLM 并行纠错
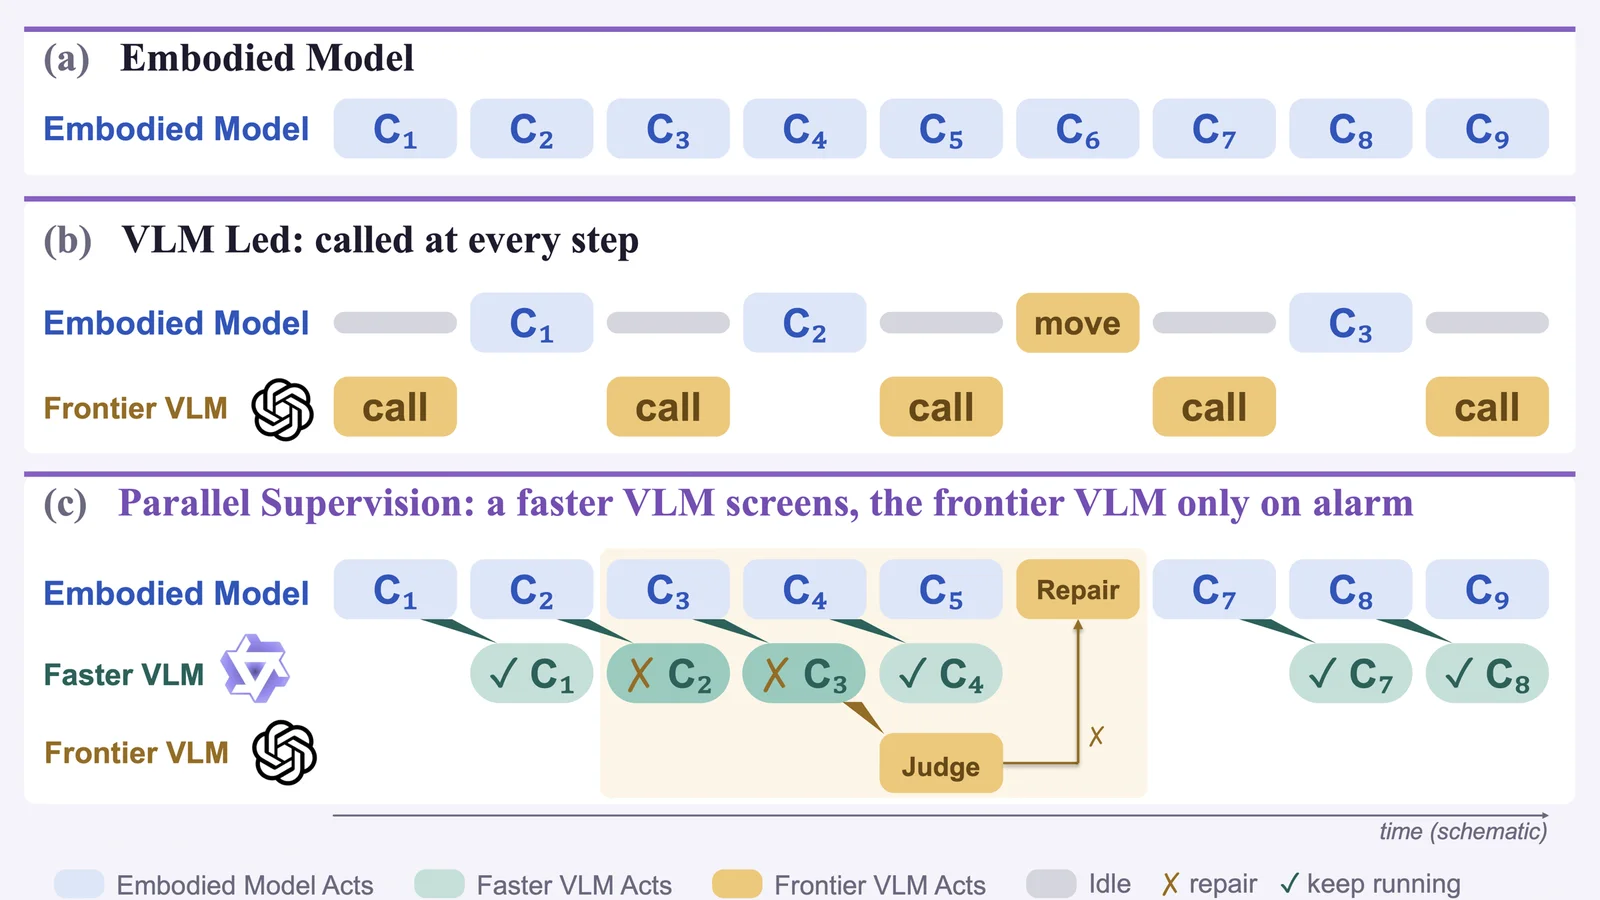
Spotter 把角色颠倒过来,用一个并行结构把执行和监督分开,三个角色同时工作:
- 具身模型负责执行:从头到尾一直在动,不等任何人;
- 本地 Qwen 负责筛查(screener):每完成一段动作就看一眼,给出风险分。它刻意偏向"宁可多报、不可漏报",因为漏掉一个错误的代价远大于一次误报;
- VLM 负责纠错(judge,可用 Qwen 或 GPT):只有连续两次报警才会被叫来,结合整段历史,判断是不是真的出错了。
确认出错之后,VLM 亲自动手。它不是去"教"具身模型怎么做(前面说过,教了也没用),而是用移动、抬起、转腕、开合夹爪、退回等基本动作写一个简短的修复计划,把手臂摆到正确的位置,再把控制权交还给具身模型。
修完还要反思。每次修复前,VLM 必须先给出一个能被验证的预期,例如"抬起时夹爪应保持张开"。下一次检查时,它先回答这个预期有没有兑现:兑现了,就不再重复修复;没兑现,下一次必须换一种思路,而不是只微调一个偏移量。
为什么快。大多数动作具身模型本来就做得对,真正需要插手的只是少数时刻。监督和执行并行,机器人从不为了等 VLM 而停下,所以在顺利完成的回合里,VLM 几乎感觉不到存在。
判断有延迟,会不会来不及?并行意味着 VLM 下结论时,机器人可能已经多走了几步。我们把这个差距限制在最多 K 步以内,而多走的几步通常分三种情况:
- 还没碰到东西:把手臂退回之前记录的位置,相当于撤销;
- 把东西碰歪了,但还在桌上:重新找到它,接着完成;
- 东西直接掉出了视野:这种情况换成 VLM-Led 同样无能为力。
整个测试过程中,我们从不重置场景,只挪动手臂,因此这套方法可以原样搬到真机上。
四、对比是否公平
步数。多数任务的官方步数上限在 500 步左右。具身模型和 Spotter 都使用 1.8 倍的上限,也就是 900 步上下。VLM-Led 在这个预算下会超限,因此我们给了它 3000~5000 步,明显多于 Spotter。
特权信息。我们复现 VLM-Led 时沿用了 Harness VLA 原代码的逻辑:VLM 可以直接读到任务是否已经成功(eval_success)。这里存在一个不小的信息差:
- 具身模型同样是"没成功就一直跑",但它并不知道自己没成功,只会重复原来的动作;
- VLM 有很强的记忆,记得自己尝试过什么,一旦得知"还没成功",就会换一种做法再试,能做的事远多于具身模型。
拿掉这个信号后,Qwen 版的 VLM-Led 甚至不如具身模型自己跑。
而 Spotter 中的 VLM 看不到任何特权信息,和具身模型一样,只能依据相机画面、机器人状态和已执行的动作,自己判断成没成功。
五、实验结果
成功率:同样步数,稳定提升
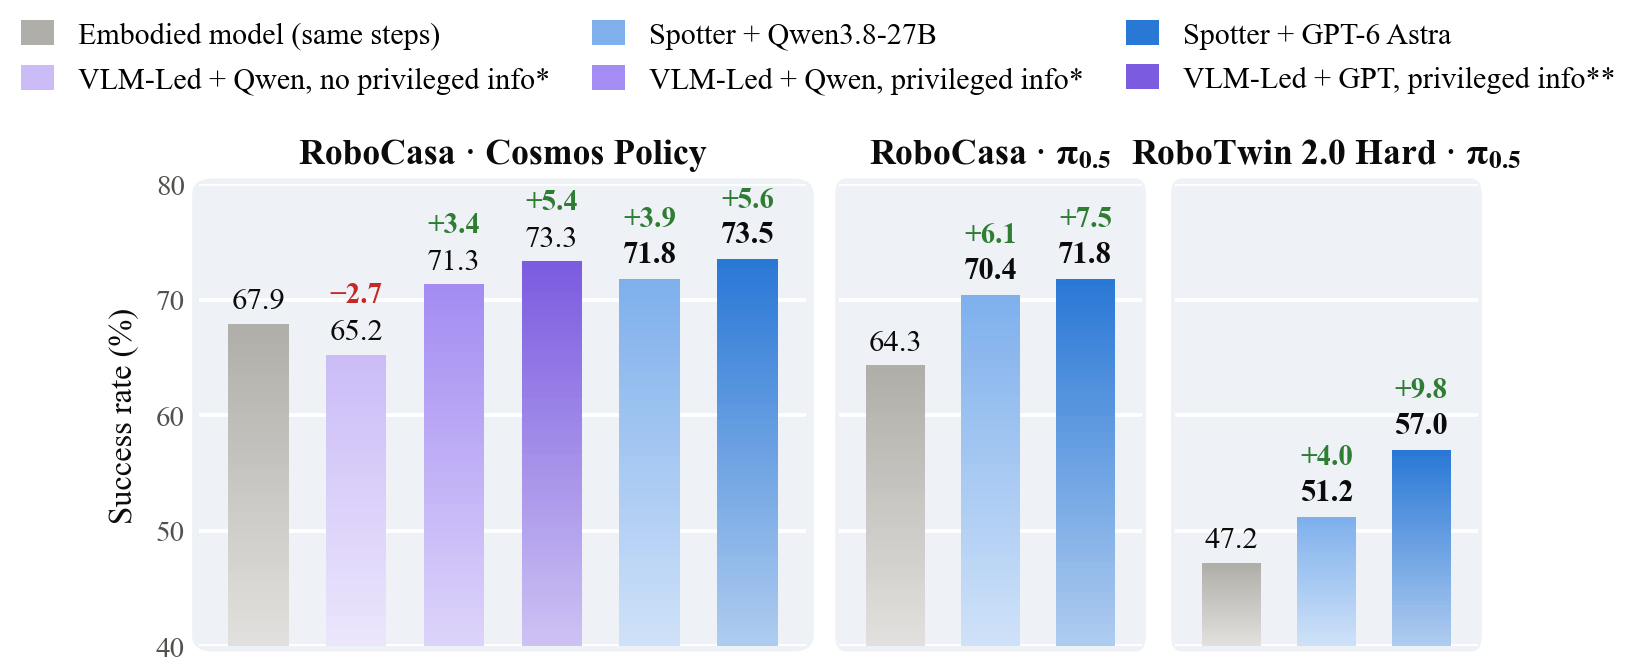
- RoboCasa(24 个任务,共 1200 个回合)
- 用 GPT:Cosmos Policy 从 67.9 提升到 73.5(+5.6),π0.5 从 64.3 提升到 71.8(+7.5);
- 用 Qwen:Cosmos Policy 从 67.9 提升到 71.8(+3.9),π0.5 从 64.3 提升到 70.4(+6.1)。
- 只纠错就能拿到大部分收益:同样用 GPT,Spotter 达到 73.5,而全程指挥、还能看到特权信息的 VLM-Led 是 73.3。
- RoboTwin 2.0 Hard(π0.5):从 47.2 提升到 51.2(Qwen)和 57.0(GPT,+9.8)。作为参照,Harness VLA 原论文在同一设置下是 50.8 → 58.4(+7.6),涨幅相当。
时间:成功的回合几乎不多花时间
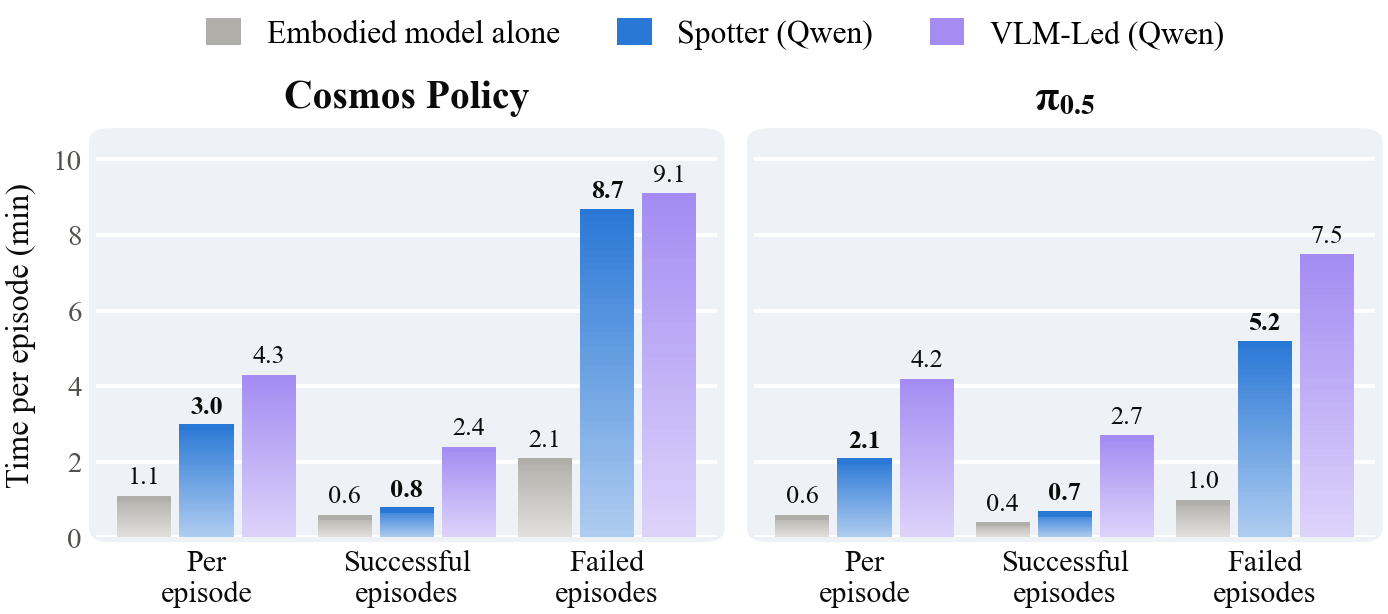
- 成功回合平均不到 1 分钟:Cosmos Policy 约 0.8 分钟,π0.5 约 0.7 分钟,只比具身模型自己跑多出十几秒;
- 对比 VLM-Led:同样使用 Qwen,成功回合的用时减少约 70%;
- 把失败回合也算上:平均每回合约 2~3 分钟,多出来的时间主要花在失败回合上,因为 Spotter 会一直尝试修复,直到步数用完。
真机:53% → 83%
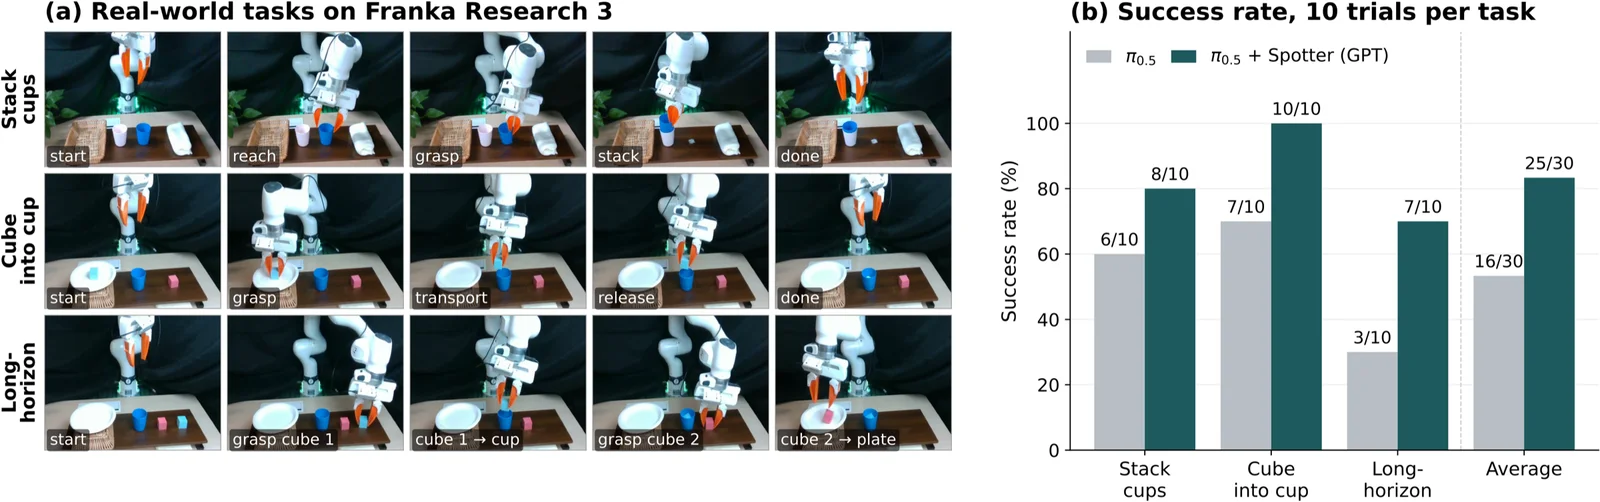
我们在 Franka Research 3 上用遥操作数据微调 π0.5,测试三个任务:叠杯子、把方块放进杯子,以及连续两步的长程任务。每个任务跑 10 次。加入 Spotter(GPT)后,平均成功率从 53% 提升到 83%,其中长程任务提升最明显,从 30% 到 70%:任务越长,一步出错就前功尽弃的风险越高,纠错的价值也越大。
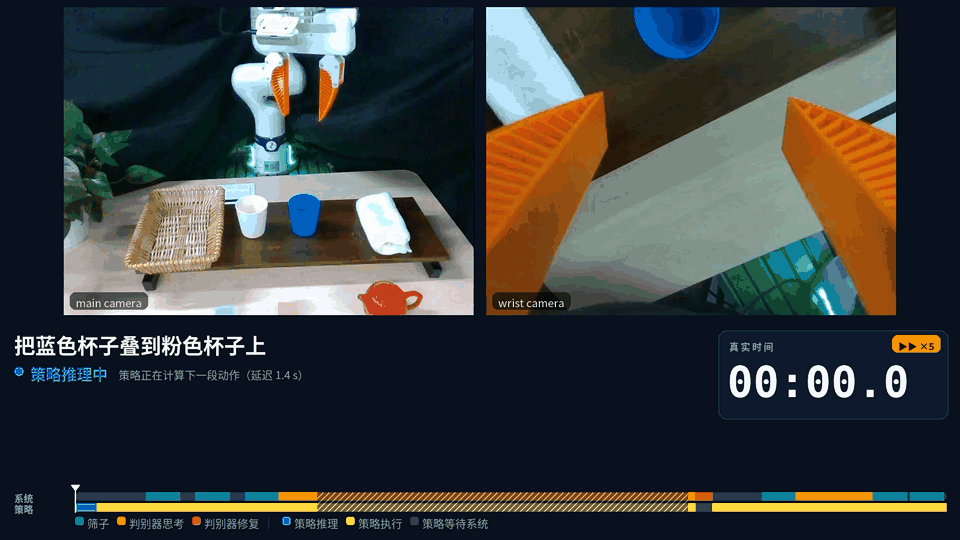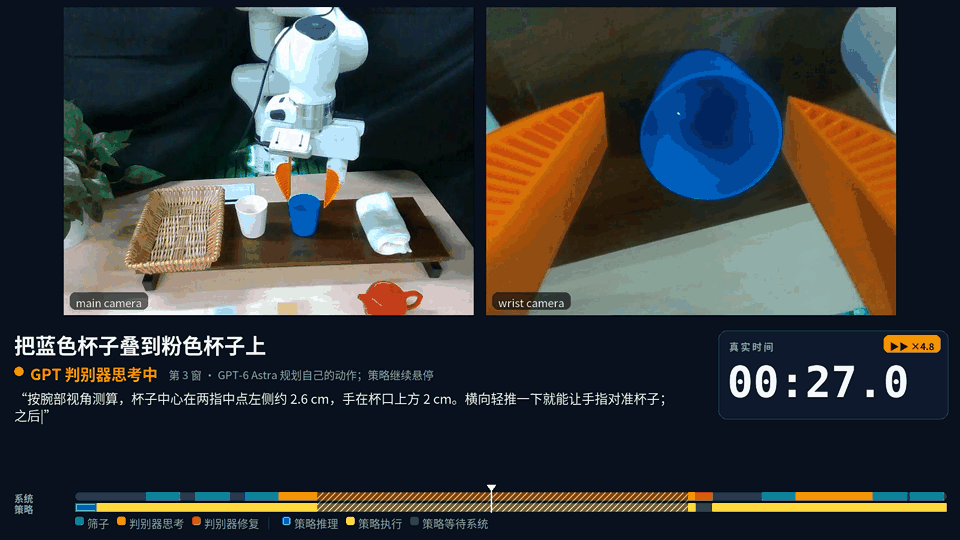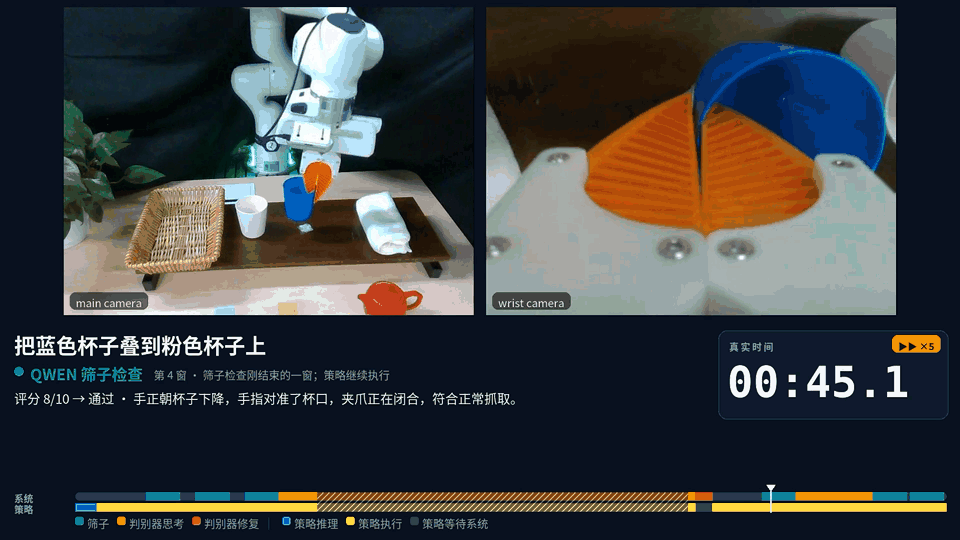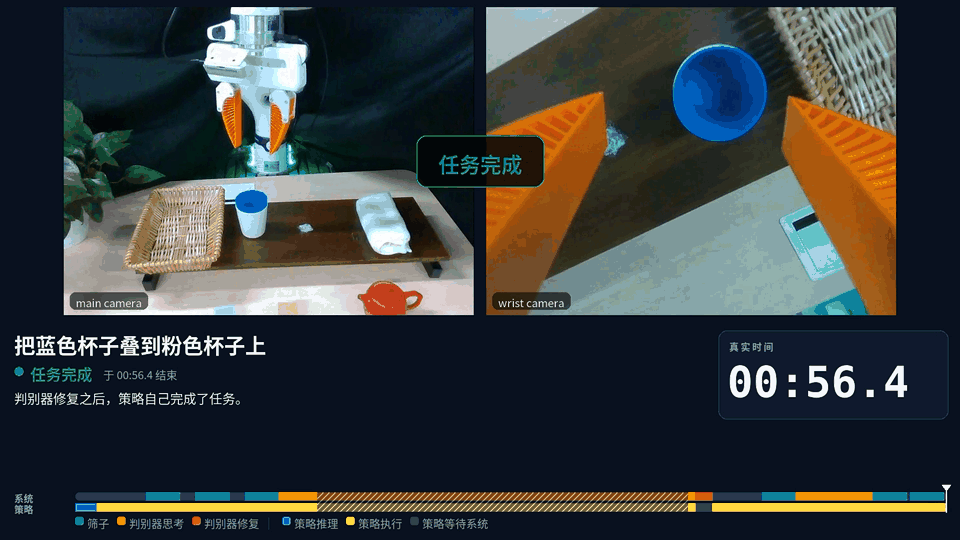
下面是一次完整的真机过程(GPT 担任 judge,视频加速播放,右上角为真实时间):手指没有对准杯口,screener 发出警报,GPT 确认后轻推一下把手对正,交还控制后,具身模型顺利把杯子叠了上去。
六、结语
在 Spotter 里,具身模型负责"做",VLM 负责"看、修、复盘"。正因为大部分动作具身模型自己就能做好,检查才可以和执行并行,修复也只需要在确认出错时发生。于是机器人几乎不用停下来,VLM 也得以把语言模型"发现错了再改"的能力,带到真实世界的动作里。
当然,还有做不到的事:如果一个错误第一次发生就彻底破坏了场景,比如物体掉出视野,目前仍然无法挽回。提前预见这类错误,或许需要世界模型的帮助,这也是我们接下来想探索的方向。
代码已开源,本地一台机器跑一个千问 Qwen3.8-27B(FP8)就能用起来,欢迎大家试用、提 issue、一起交流。