作者:叶文萱,tum在读博士
论文:Select to Think: Unlocking SLM Potential with Local Sufficiency
Paper: https://proceedings.mlr.press/v306/ye26r.html
Code: https://github.com/YeRona/Select-to-Think
最近,小语言模型(SLMs)受到越来越多关注。相比动辄几十甚至上百亿参数的 LLM,1B–4B 左右的 SLM 更适合部署在手机和本地设备上,成本和延迟也更低,但推理能力通常更弱。
提升 SLM 推理能力主要有两条路线:调用 LLM,但会增加成本、延迟和在线依赖;或者蒸馏 LLM,但小模型又很难完整学习大模型复杂的生成分布。
这带来了一个现实的矛盾:如何利用 LLM 的能力,又不依赖 LLM。
因此,我们在思考一个核心的问题:
SLM 距离 LLM 的选择,到底有多远?
一个出乎意料的发现:LLM 的选择离 SLM 并不远 (Local Sufficiency)
我们发现,在 SLM 与 LLM 发生分歧的位置,LLM 选择的 token 往往已经出现在 SLM 的 Top-8 候选中。
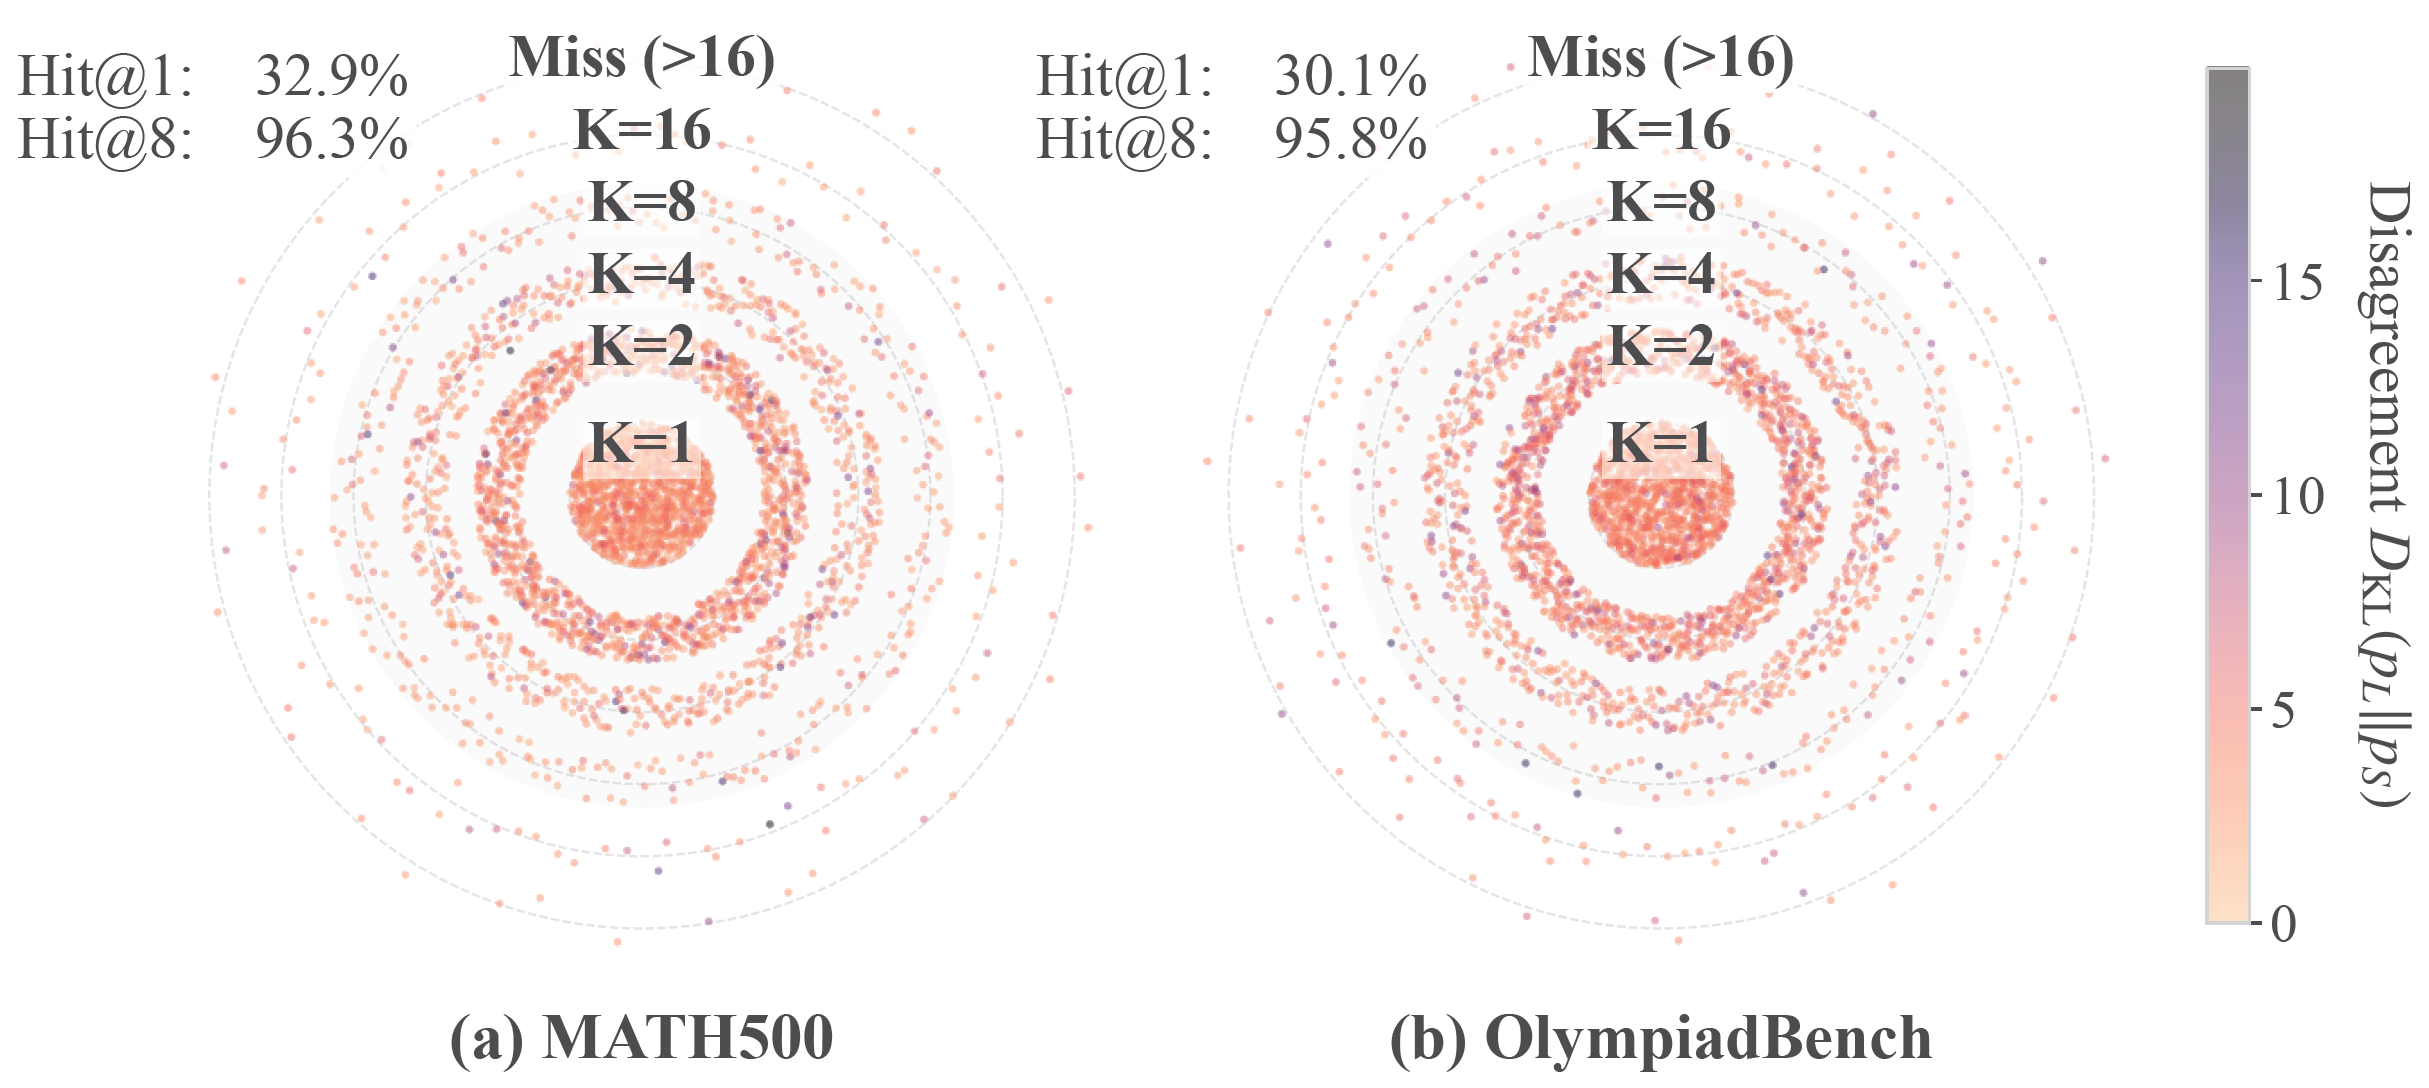
1.5B SLM 的 Top-8 可覆盖约 95% 的 32B LLM 选择;即使缩小到 0.5B,覆盖率仍有约 85%。
这意味着,很多时候,SLM 并不缺少 LLM 想要的候选,差距更多体现在如何从已有候选中做出更好的判断。
Select to Think:让 LLM 从“生成者”变成“选择者”
基于此,我们提出了 Select to Think(S2T)。不再让 LLM 直接生成下一步,而是:SLM 提出自己的 Top-K candidates → LLM 只负责从中选择
这个变化直接改变了监督问题本身。原本,SLM 要在整个 vocabulary 上模仿 LLM 的生成分布;现在,只需要从自己的 8 个候选里选一个。也就是说,一个复杂的生成问题,被简化成了局部 selection problem。
实验中,仅靠候选选择,就已经能够获得与 LLM 自由生成 相近的效果。
S2T-Local:从 LLM 选择,到 SLM 自选
我们进一步把这种选择能力蒸馏回 SLM。
我们希望尽量保留模型原有的 language behavior,只额外学习局部判断能力。
normal tokens 继续负责语言生成和 reasoning,reserved tokens 专门负责 candidate scoring,从而将 generation 与 selection 明确分开。
推理时,同一个 SLM 即可完成候选生成与选择,无需外部 LLM。
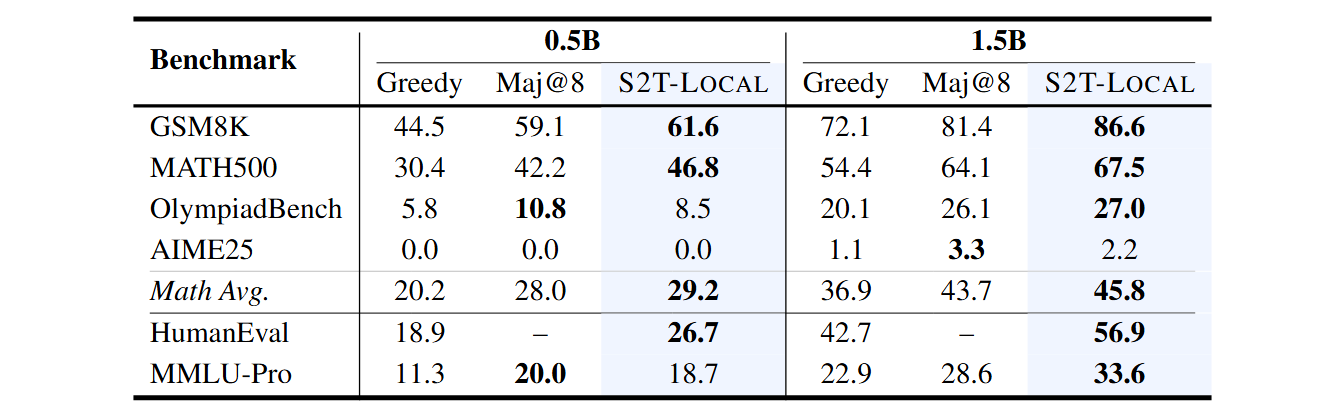
S2T-Local 只生成一条 trajectory,就能接近 8-path self-consistency,同时相比 greedy decoding 平均提升 24.1%。
总结
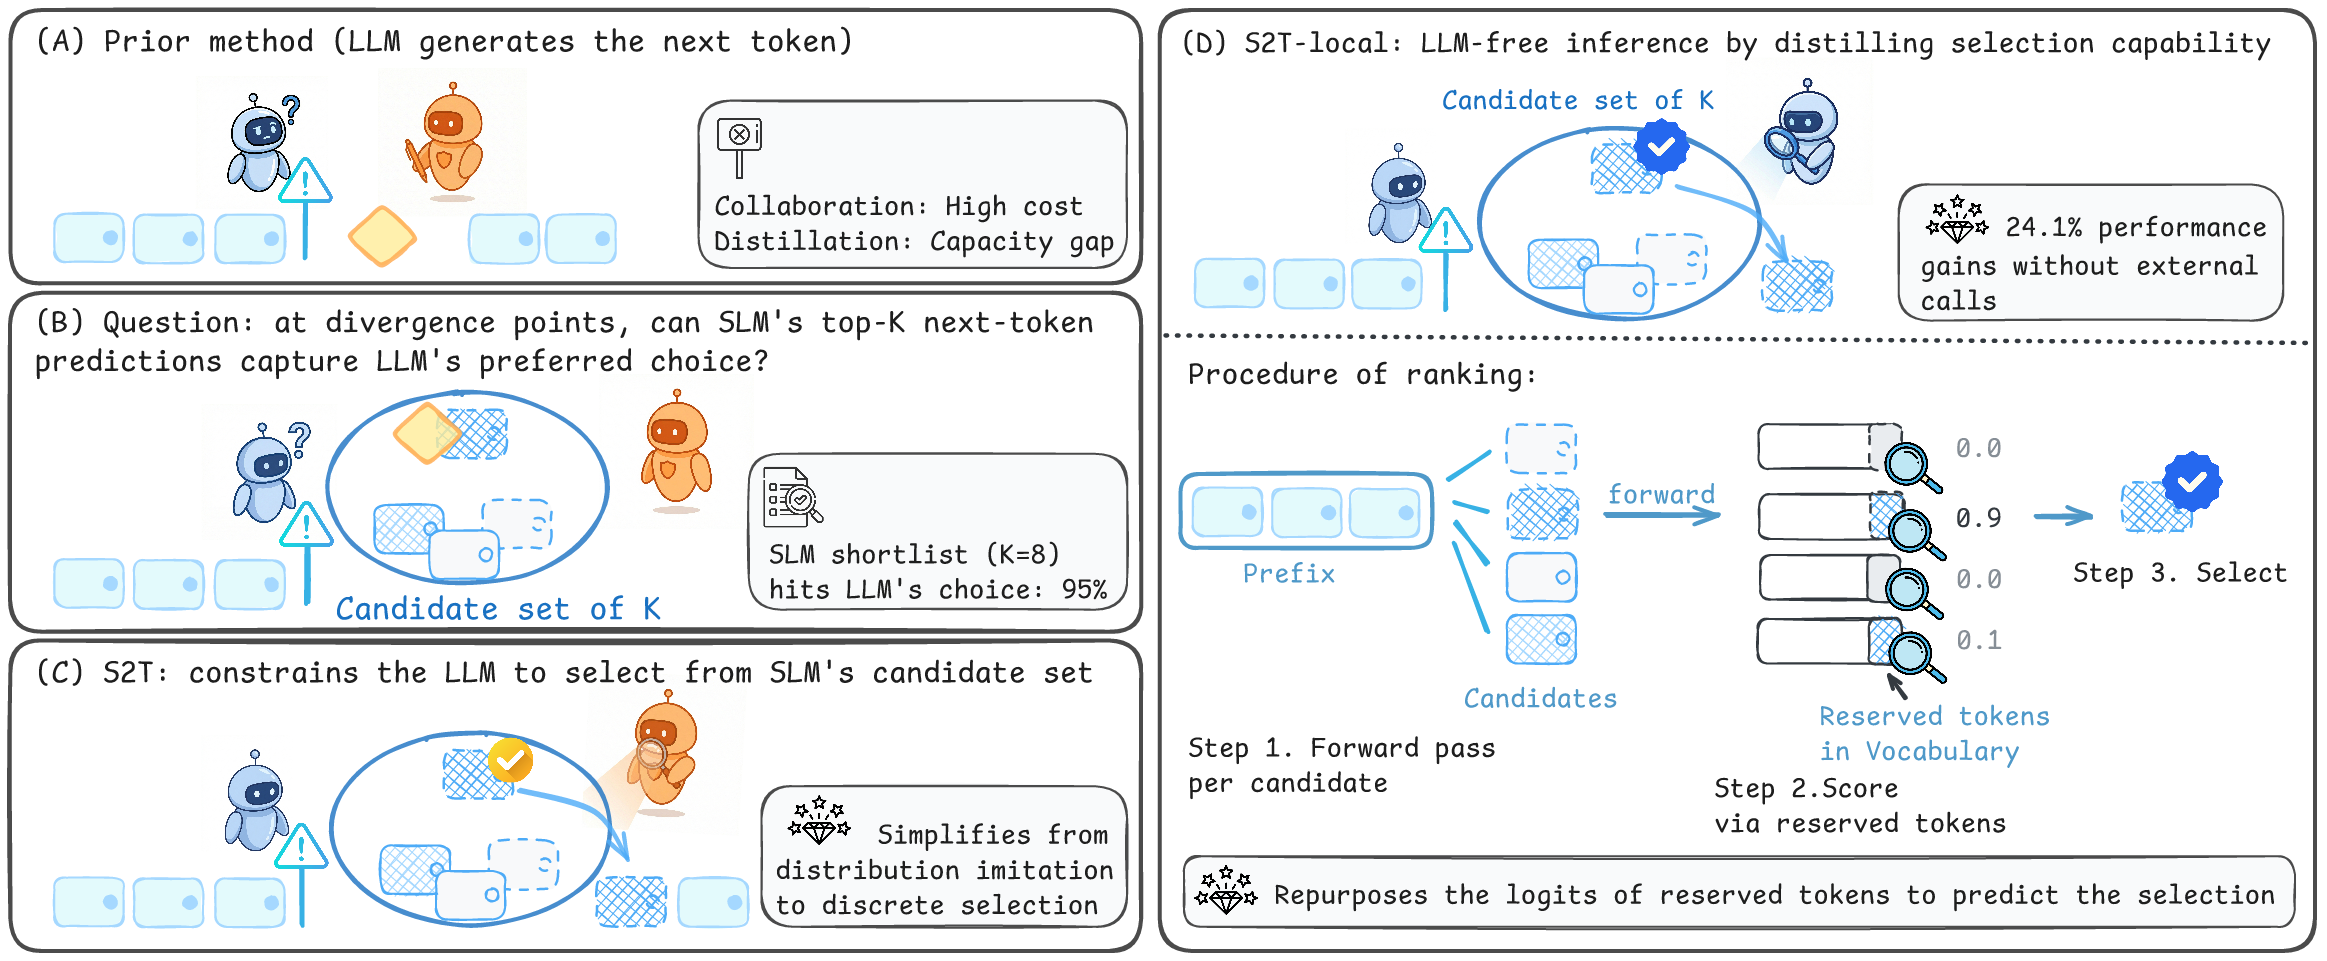
LLM 更好的选择,很多时候已经存在于 SLM 自己的候选空间里。Select to Think 因此把复杂的生成模仿转化为更容易学习的局部选择,并进一步把这种能力蒸馏回 SLM 自身。
这也和近期 Jev 所强调的 Decisions, not strings 有些呼应:并不是所有智能都需要通过自由生成来表达,很多时候更关键的是对已有选项做出更好的判断。
希望我们的工作能为on-policy distillation、模型协作以及高效推理提供一种新的思考方式。
欢迎大家交流讨论!