TLDR
刚入职就被老板抓来做megakernel,问及怎么做,曰:不知道,问及目标,曰:世界一流水平。
本文关注 GLM-5.2-FP8 在 decode 阶段执行完整 Indexer 的一个 Transformer layer,并优化这一层进入 Sparse FlashMLA 前的计算。
测量范围从 Add + RMSNorm + Quant 开始,到 Paged Indexer Score 结束,不包含随后的 TopK 和 Sparse FlashMLA。实验在一张 B300 上进行,一次同时处理两个请求,每个请求输入 8 个 token,即 M=16、KV=8192。
这段计算最初要依次执行约 30 个短 kernel,总耗时约 80 us。Kernel fusion 先把它降到 61.631 us。随后我沿着 Megakernel 的思路实现了 MegaRTP,把各个 kernel 拆成 tile instruction,放进一个 persistent kernel 中执行,扣除固定执行框架后的估算时间为 39.601 us(完整运行 44.272 us,其中固定框架开销为 4.671 us)。
在分析清楚收益来源后,我又用 CUDA Graph + Multistream + Programmatic Dependent Launch(PDL) 重建同一张计算图,并把这套组合简称为 CMP,最终做到 36.992 us。
Multistream 把无依赖分支并行起来,使执行时间从 61.631 us 降到 44.432 us;
PDL 再让有依赖的 consumer 提前进入 GPU,完成 prologue 和权重预取,进一步降到 36.992 us。
其中PDL 并不只是消除 kernel launch bubble:单条依赖边能省多少,取决于 consumer 在 GDC 之前究竟能做多少有效工作。
如果 PDL 只让 consumer 提前进入 GPU、没有额外的 prologue 或权重预取,收益通常不到 1 us;能够提前执行 prologue 和搬运权重时,收益可以达到 1--3 us;如果 consumer 提前驻留带来的资源竞争过强,甚至可能回退。
Megakernel 也有同样的问题;它能比 PDL 更激进地提前调度后续任务,也更容易让多个尚未满足数据依赖的任务提前驻留,与当前 kernel 争抢 SM、L2 和显存带宽。
总结来看,Megakernel 的收益可以拆成三类
1、 无依赖任务的并行可以由 Multistream 完成
2、 有依赖任务的提前调度、prologue 和权重预取可以由 PDL 完成
3、 Megakernel 真正额外提供的,是 tile 级依赖和跨 instruction 流水
MegaMoE 是tile 级依赖能够产生收益的例子:dispatch、group GEMM 和 combine 之间存在跨多个 wave 的细粒度依赖,还能让 NVLink 通信、Tensor Core 计算和 CUDA Core 工作形成持续的硬件并行。
本文的 workload 则不同。为了保持 GEMM 效率,blockM 会在一定范围内随 token 数增大,因此 M 方向的 tile 数不会随 token 数等比增长。
GEMM 之后又常常紧跟 RMSNorm;RMSNorm 需要等待对应行的所有 GEMM N tile 写回,而不是任意一个 GEMM tile 完成就能开始。
这两点都在减少可利用的细粒度依赖;到 M=16 时,关键路径上基本已经没有可持续推进的 tile 级流水。
而且,即使存在细粒度依赖,它也必须跨越多个 wave,并且位于关键路径上,才可能转化成端到端收益。
因此,除非 workload 像 MegaMoE 一样,能够用大量跨 wave 的细粒度依赖持续驱动不同类型的硬件,否则 Megakernel 相比 Multistream + PDL 很难获得明显的额外收益。
Megakernel 没有打过 CUDA Graph + Multistream + PDL 的原因有以下几点
1、 MegaRTP 当前没有启用 2-CTA GEMM
这类 GEMM 需要两个 CTA 成对协同执行,但 MegaRTP 的 worker CTA 是从各自的 queue 独立取任务,当前的调度协议还不能保证这对 CTA 同时取到配对的 GEMM instruction,因此只能放弃这部分高性能配置
2、 Op 之间依靠 gmem counter 上的 release atomic add 和 acquire load 保证数据可见性。
consumer 轮询 counter 时,load 命中 L2 的延迟约为 300–400 个 cycle;一旦未命中并进入 HBM,单次访问延迟会随带宽压力从约 800 个 cycle 增长到 4000 个 cycle 左右。
因此,在高带宽压力下,这种全局 counter 轮询的代价可能超过 CUDA Graph + PDL 中观察到的约 300 ns kernel bubble
3、 Megakernel 会更激进地提前调度尚未满足依赖的任务并预取权重,多个任务可能一起争抢带宽。
暴论:很多 Megakernel 工作集中在 batch=1,并不是因为 Megakernel 在语义上只能支持 batch=1。
一个更直接的原因是,当 workload 里缺少能够持续 overlap 的细粒度依赖时,它的实际收益主要来自缩短 kernel handoff,以及提前执行 prologue 和 weight prefetch。
这些收益的绝对时间相对固定(0.5-3us);batch=1 时 kernel 本身很短,固定收益在总时间中的占比自然更大,更适合发 post说是。
1. Kernel fusion 之后,GPU 仍有一半以上的 SM 没被用起来
最早的实现大约有 30 个 CUDA kernel。A0 的 Add + RMSNorm + Quant、QKV-A/Head-Gate/Indexer-K/Main-Q/Indexer-Q 的 GEMM、RoPE、缓存写回、D2 的 BMM 和 E1 的 Paged Indexer Score 都由多个 kernel 分别完成。
把相邻计算合并进同一个 kernel 后,kernel 数量降到 11 个,串行执行时间从约 80 us 降到 61.631 us。
Fusion 省掉了多次 kernel 启动和部分中间数据读写,但它没有解决 GPU 利用率问题。这 11 个 kernel 在同一条 stream 上逐个执行;前一个 kernel 没有完成时,后一个 kernel 不会开始,因此同一时刻只有当前 kernel 的 CTA 能驻留在 SM 上。
这里的 grid 指一次 kernel 启动提交的 CTA 集合。CTA 本来就会由硬件分派到多个 SM,限制在于集合本身太小:有些 kernel 只提交 12、16 或 32 个 CTA,而 B300 有 148 个 SM。
比如 12-CTA 的 B1 producer 最多只能让 12 个 SM 同时运行目标 CTA,其余 SM 必须等这个 kernel 结束,不能提前执行后面的独立分支。
下图上半部分是 Kineto 记录的 11 个 kernel 的实际执行区间和 grid CTA 数;下半部分是在每个时刻用 min(grid CTA, 148) 得到的活跃 SM 数量上界。
它不是硬件采样值,而是一个乐观估计:按各 kernel 的持续时间加权,整段执行平均最多只有 64.65 / 148 = 43.7% 的 SM 在工作。
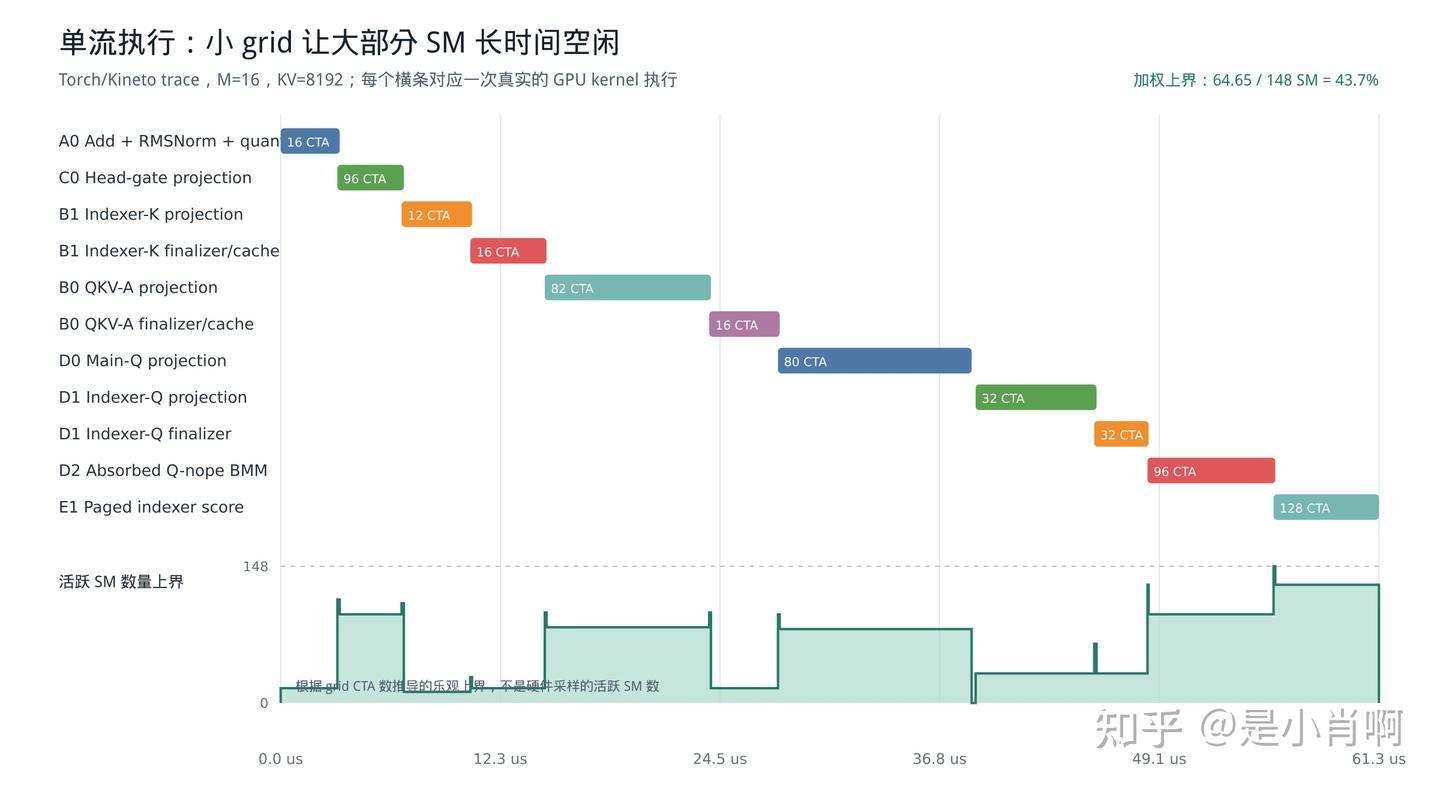
Kernel 之间的 bubble 不是主要耗时来源。20 次测量中,所有相邻 kernel 的 bubble 时间加起来,中位数只有 0.672 us,约占整段时间的 1.08%。因此,这里的主要优化空间不在继续压缩 kernel launch 开销。
主要问题来自执行顺序。这 11 个 kernel 之间并不是一条串行依赖链:第一个 kernel 完成后,QKV-A、Head-Gate 和 Indexer-K 三条路径互不依赖;QKV-A 的结果又分别进入主 attention 路径和 Indexer-Q 路径。把它们全部放在同一条 CUDA stream 上,会把本来可以同时执行的工作排成一列。
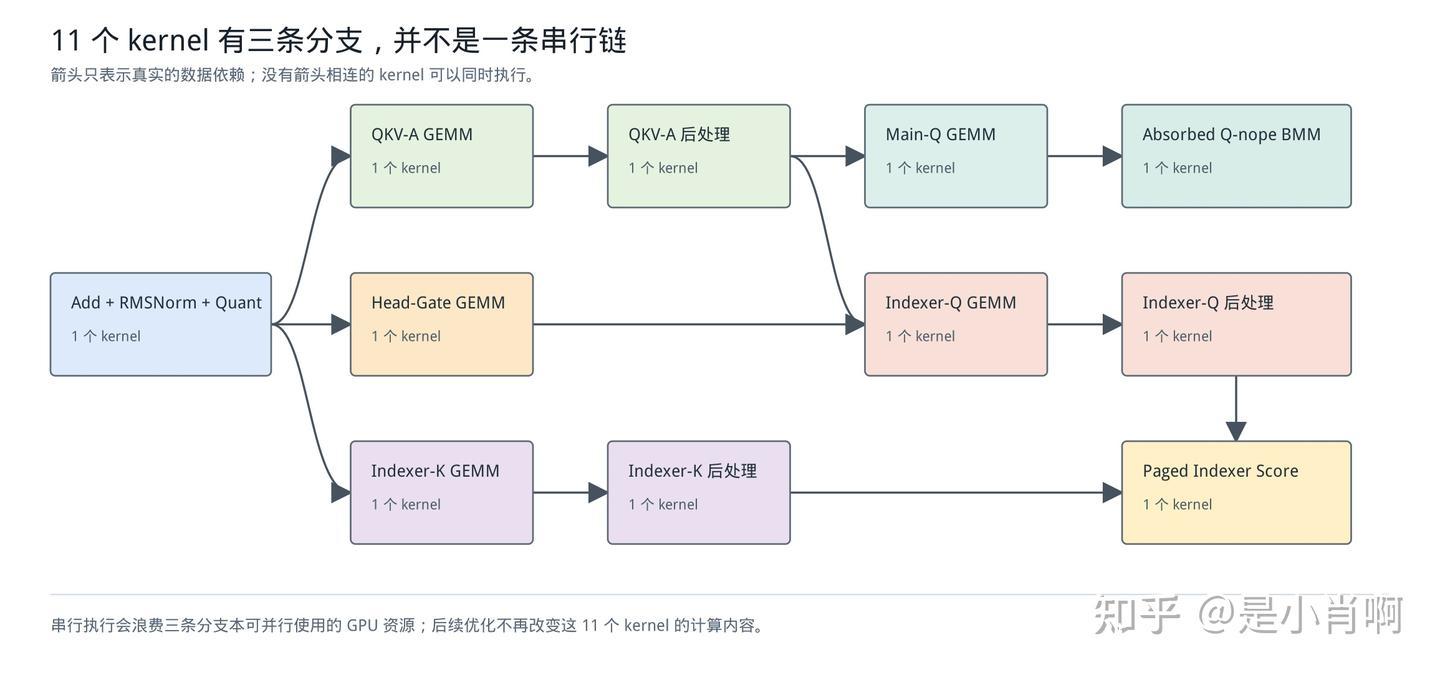
从这张 DAG 可以看到,kernel 本身已经成了调度边界:即使当前 kernel 只用了少量 SM,其他 kernel 中不依赖它的计算也无法进入这些空闲 SM。要继续提高利用率,就需要把调度粒度从整个 kernel 下沉到 tile。
Megakernel 为这种更细粒度的调度提供了可能。
2. Megakernel 如何打破串行执行边界
Megakernel 首先打碎了传统的 kernel 边界:原来的每个 kernel 不再作为一个整体启动,而是按 tile 粒度拆成多组任务。这里的 tile 指一次 CTA 级的工作单元,也就是某个 CTA 负责处理的一小块数据范围。
它的形状由算子决定:RMSNorm 通常按行切分,一个 tile 对应一行;GEMM 通常按二维输出块切分,一个 tile 对应一个 (blockM, blockN) 输出块。
在 MegaRTP 中,Host 会把每个 tile 编码成一条 instruction;当前实现里,二者是一一对应的。一个长期运行的 kernel 启动固定数量的 worker CTA,每个 worker 按 CPU 预先生成的 instruction queue 逐条读取和执行 instruction,而不是在 runtime 重新推导计算图。
没有数据依赖的路径可以同时推进
以 QKV-A、Head-Gate 和 Indexer-K 为例,三者都依赖 Add + RMSNorm + Quant,但彼此没有依赖。Add + RMSNorm + Quant 完成对应 tile 并更新 event counter 后,等待该结果的 instruction 就可以开始执行。
三条路径的 instruction 因此能够交错推进,共同使用空闲 SM,而不必像单流执行那样逐个完成整个 kernel。
有依赖的任务也可以提前准备
第二类机会出现在有数据依赖的前后任务之间。假设任务 B 需要任务 A 的输出,B 的矩阵乘法当然不能提前执行;但 B 在第一次读取 A 的输出之前,仍有很多与 A 无关的工作:读取任务描述、构造调度状态、初始化 barrier、准备 TMA descriptor,以及加载 B 自己的权重和 scale。
Megakernel 可以让执行 B 的 worker CTA 在 A 仍在执行时就开始这些准备,只让负责读取输入的 warp 等待 A 的结果。
B 的 prologue、调度器和 barrier 初始化,以及权重和 scale 的加载,都可以先进行;当 A 的对应输出满足依赖后,B 的 activation loader 开始搬运输入,随后与已经准备好的权重在 barrier 处汇合,进入 B 原本的 kernel 主循环。
数据依赖并没有被绕过。读取 A 的输出以及后续的矩阵乘法仍然必须等待;提前发生的只有与 A 无关的准备工作。
Tile 级细粒度依赖
传统 kernel 依赖以整个 grid 完成为边界:即使 A 的第一个输出 tile 已经写完,B 仍要等待 A 的所有 CTA 退出。
Megakernel 把依赖细化到 tile:A 完成一个 tile 后更新对应的 event counter;B 的 instruction 等待这个 counter 达到预设目标值,满足后才读取并计算该 tile,不必等待 A 的整个 grid 结束。但它只有在下游能够消费上游已经完成的 tile 时才有意义。
例如,1024 行的 RMSNorm 后接 blockM=128 的 GEMM,前 128 行完成并更新 counter 后,GEMM 就可以先计算对应 tile,不必等 RMSNorm 的其余行结束;在计算与通信可以重叠的场景中,通信完成一个 tile 后,也可以开始这个 tile 的计算。
小 M 时通常没有这样的重叠窗口:上游 kernel 可能在一个 wave 内完成,单个 tile 的耗时已经接近整个 kernel;如果这个 wave 恰好占满所有 SM,下游也没有空闲 CTA 可以提前执行。此时把依赖从 kernel 级细化到 tile 级,并不会缩短关键路径。
3. 相关工作:Stanford Megakernels、Mirage、Event Tensor 和 TileRT
Stanford Megakernels:把整层计算变成 GPU 内的 instruction 执行器
Stanford 的 Look Ma, No Bubbles! 面向单 GPU、batch size 为 1 的 Llama decode。
它要解决的不是单个 GEMM 不够快,而是 decode 中每个算子都很短:即使把 kernel launch 换成 CUDA Graph,算子之间的边界仍会阻止下一个算子提前准备权重,也会让本来可以交错的工作被整个 grid 隔开。
它的做法是把一轮 forward 的执行计划放进 GPU 内部的一层轻量 instruction 执行器。Host 侧先构造算子 DAG,再把每个算子拆成可由一个 worker CTA 执行的 instruction,并将 instruction 分配到静态队列。
队列通常编码为 [num_sms, max_queue_len, 32] 的 int32 张量,每条 instruction 是 32 个 int32;较短的队列用 NoOp 补齐,使所有 worker 可以按统一的迭代次数推进。Runtime 不再为每个算子单独 launch kernel,也不需要在 GPU 上重新推导整张计算图。
Device 侧启动一个长期运行的 persistent kernel,每个 worker CTA 负责一个 SM 的队列。CTA 内使用 warp specialization:
- controller warp 读取 instruction,建立 logical page 到 physical page 的映射并初始化本条 instruction 的 semaphore;
- loader warp 负责 TMA 权重和 activation 搬运;
- consumer warp 执行矩阵乘和向量计算;
- storer warp 负责结果写回并发布完成状态。
不同角色通过 instruction-arrived、stage semaphore 和 page semaphore 协作,因此控制信息、权重搬运、Tensor Core 计算和写回可以同时处在不同阶段。
跨算子的正确性由 global counter 保证。生产者完成一个输出 tile 的异步写回后,用 atomicAdd 发布完成数量;消费者只在真正读取这块 activation 之前等待目标 counter,权重和 descriptor 等与输入无关的准备可以提前进行。
SMEM 则被划分成可循环复用的 page:当前 instruction 释放 page 后,下一条 instruction 可以使用对应 page 预取权重,避免每次都从空流水开始。
因此这里有两层软件流水。第一层发生在不同 CTA 之间:一个 worker 还在执行当前 instruction 时,另一个 worker 已经可以执行自己队列中就绪的下一条 instruction,并提前加载它的权重。
第二层发生在同一个 CTA 内:当前 instruction 的 consumer 正在进行 MMA 时,controller 和 loader 已经读取、初始化并预取下一条 instruction;等 page 和 stage 可以复用后,下一条计算直接接上,而不必重新走完整 prologue。
MegaRTP 继承了这套“Host 生成计划、GPU 内解释执行、warp specialization、跨 instruction 预取”的总体思路,但没有照搬 Stanford 面向固定模型的 queue 和算子实现。
MegaRTP 需要处理 GLM5 的动态 M/KV、tile 级 counter 依赖和 Blackwell GEMM,因此重新设计了 instruction ABI、worker 角色和 page 生命周期;这些差异也是后文性能和实现取舍的重点。
Mirage 和 Event Tensor:把依赖本身变成可编译对象
Mirage Persistent Kernel(MPK)进一步把这件事做成了编译器和 runtime。它先把算子拆成 SM 级 task,并根据实际读写范围建立 task 之间的 event,而不是用一个“整个算子完成”的粗粒度 barrier。
这样,MatMul 的某个 tile 完成后,对应的通信或下游计算 tile 就可以开始,计算和通信能够形成流水。
MPK 在生成 tGraph 时会做三类压缩。
Event fusion 合并具有相同 producer 或 consumer 集合的 event,避免为同一组依赖维护多个同步点;论文报告 event 数量可减少 37–118x。
tGraph normalization 只在 fork/join 出现时插入辅助 task/event,把 task 的触发和依赖关系规整成固定的一进一出;这主要解决 descriptor 格式和 runtime 处理逻辑不规则的问题,并不是额外的计算优化。
tGraph linearization 则重新排列 task,让同一个 event 的后继 task 在队列中连续,event 只保存起止位置而不保存离散列表;论文报告 successor metadata 在 dense 模型上缩小 4.4–5.9x,MoE 上约 15x。
Event Tensor 的亮点是把 event 本身表示成带维度和索引关系的对象,例如按 batch、head、tile 组织完成状态,使 shape-dependent、data-dependent 的依赖可以由同一套表示描述。论文中的消融也说明了这种细粒度依赖并不会自动带来收益:
| workload | 调度方式 | 相对一次 launch、保留全局 barrier 的 baseline |
|---|---|---|
| Qwen3-32B,TP=4,规则 dense | static | 1.06–1.09x |
| MoE,1024 tokens | dynamic | 1.08x |
| Qwen3-32B,TP=4,规则 dense | dynamic | 0.82–0.89x |
这里的基线已经是一个 megakernel,算子实现和 kernel launch 次数都不变;static 版本只把粗粒度 stage barrier 换成细粒度依赖,因此得到约 6–8% 的收益。
规则 dense workload 如果再使用动态 scheduler,反而只有基线的 0.82–0.89x,说明细粒度依赖带来的重叠并不一定自动产生收益;动态调度开销过大时,反而会抵消重叠。
TileRT:多卡如何分工
TileRT 的 CUDA kernel 实现是闭源的,因此本文只讨论公开 Python 代码、本地八卡 trace 和二进制指令能够共同证明的部分。
当前 wheel 的一次 forward 在每个 rank 上可以看到 162 个 kernel:它不是用一个 kernel 覆盖完整模型,而是每层 attention 和 FFN 分别启动 kernel。 本文重点分析这些 kernel 如何在八张卡之间分工。
Attention 没有采用八张卡执行相同工作的普通 TP8,而是拆成两种 GPU 角色:
- rank 0 执行 Indexer Q/K、扫描 KI cache、计算 score 和 Top-2048,然后把选中的位置发布给其余七张卡;
- rank 1–7 以 TP7 分片持有主 MLA 权重。它们可以先完成 projection 和 cache 准备,拿到 Top-2048 位置后再 gather 稀疏 KV,继续完成 QK、softmax、PV 和输出投影。
Attention 有两个影响关键路径的跨 rank 同步点。第一个在稀疏 gather 前:rank 1–7 可以先做 projection,但必须等 rank 0 发布 Top-2048 索引,才能知道该读哪些 KV。
第二个在 attention 输出处:七个 MLA rank 产生的 partial 需要汇合,八张卡拿到一致的 attention 输出后,才能共同进入下一段 FFN。
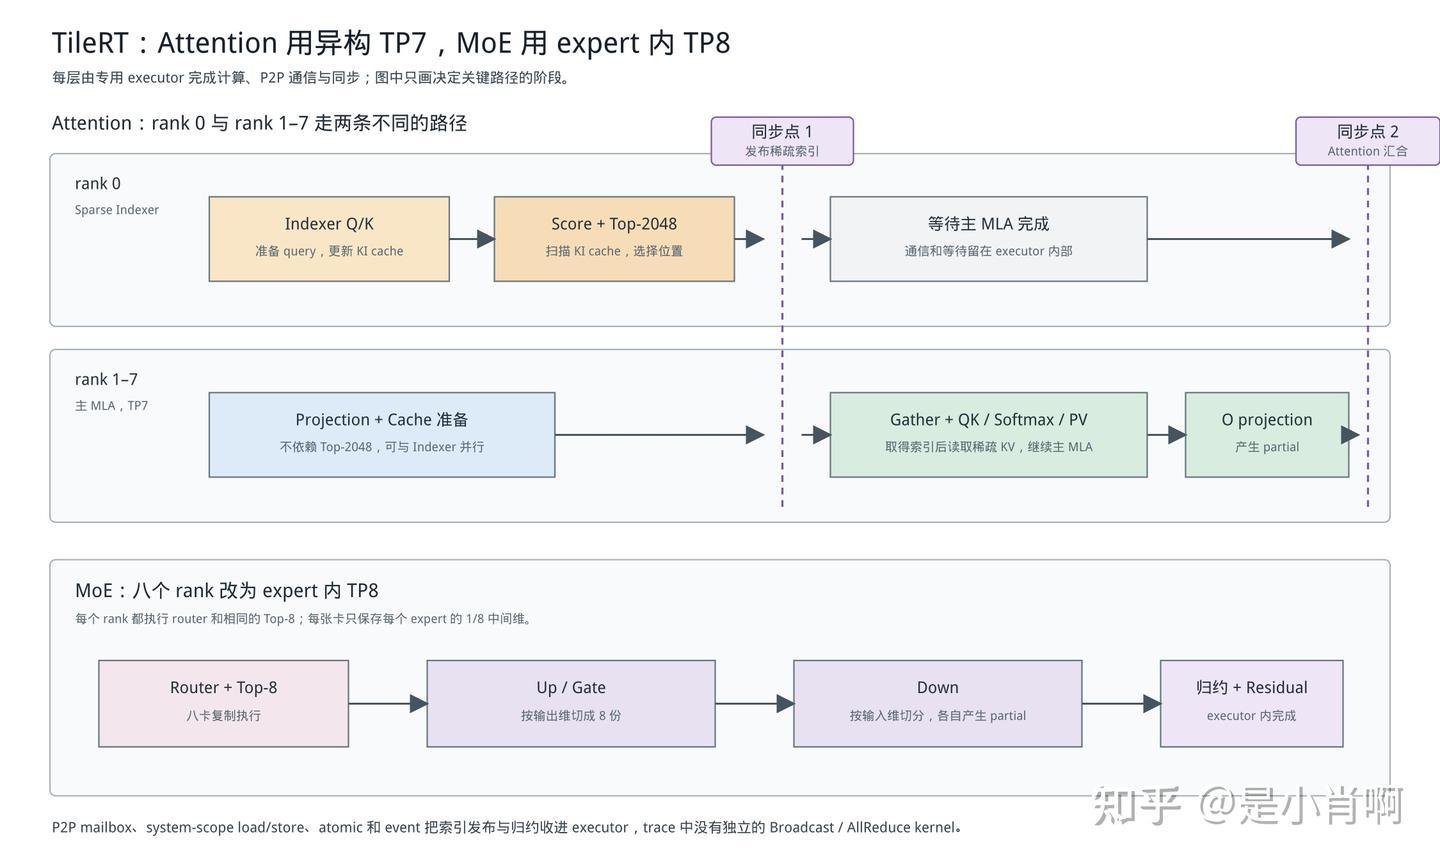
TileRT 的 MoE 又换了一种分工。八个 rank 都执行相同的 router 和 Top-8,也都持有 shared expert 以及 256 个 routed expert,但每张卡只保存每个 expert 的 1/8 中间维。Up/Gate 按输出维切分,Down 按输入维切分;每张卡得到一个 6144 维 partial,随后在同一个 FusedMoeExecutor 内完成八卡归约和 residual。它是 expert 内部的 TP8,不是把不同 expert 分给不同 GPU 的 EP8。
下面的数据来自我在 8 张 NVIDIA B300 上对 GLM-5.1-FP8 做的本地实验:batch=1、关闭 MTP、KV=8192,每步 decode 生成一个 token。整模型单步延迟的中位数为 7.358 ms,对应 136.09 tok/s。
下面估算各条路径的有效带宽。这里不按 kernel 内部可能发生的重复 load/store 展开,只计算实际存放的权重(包含 scale 和 padding)以及本轮读取的 KV Cache 各加载一次:
rank 0 Indexer
  Q_A + Indexer-K 权重 + Indexer-Q 权重 + 两份 score projection 权重 + norm 参数 + KI Cache
  = 12.7998 + 8.0313 + 0.7500 + 0.0322 + 2.0000
  = 23.6133 MiB

每个 rank 1-7 MLA
  Q_A + KV_A + RoPE projection 权重 + Q_B 权重 + KV_B1 权重 + KV_B2 权重 + O projection 权重 + norm 参数 + Top-2048 KV/PE Cache
  = 15.4351 + 5.0195 + 0.9473 + 1.2598 + 15.0781 + 0.0332 + 2.2500
  = 40.0229 MiB

每个 rank MoE
  router、norm 和 bias + 1 个 shared expert + Top-8 routed experts
  = 3.0244 + 9 x 4.5195
  = 43.7002 MiB

有效带宽 = 访存量 / 对应路径耗时
| 路径 | 估算访存量 | 实测时间 | 带宽计算 |
|---|---|---|---|
| rank 0 Indexer | 23.613 MiB | 47.551 us | 23.613 MiB / 47.551 us = 0.521 TB/s |
| 每个 rank 1–7 MLA | 40.023 MiB | 47.264 us | 40.023 MiB / 47.264 us = 0.888 TB/s |
| 每个 rank MoE | 43.700 MiB | 23.016 us | 43.700 MiB / 23.016 us = 1.991 TB/s |
若按 B300 每卡 8 TB/s 的产品峰值计算,Indexer、MLA 和 MoE 分别只达到单卡峰值的 6.51%、11.10% 和 24.89%。这个结果比我预期的带宽利用率低不少,如果计算口径有问题,也欢迎大家指正。
4. MegaRTP:用一个 persistent kernel 运行不同模型图
为什么不能直接复用固定模型的Megakernel
Stanford Megakernels 把某个固定模型的一轮执行路径做成常驻 kernel:模型里的 tensor、tile 划分以及“谁通知哪个 event、谁等待哪个 event”都可以直接写进专用实现。
这样做的代价也很明确:换模型、换子图,或者只改变 batch/MTP/KV length 导致 tile 数变化时,不能只更新输入地址和任务数据,往往还要改 kernel 里的执行逻辑。
MegaRTP 有两个关键需求:
1、 模型图必须可扩展。 同一个 runtime 既要能执行不同模型的完整图,也要能执行其中任意选定的子图;M 和 KV length 改变时,只重新生成 Host 侧计划,不改常驻 kernel 的执行循环。
2、 大 M 下仍要有高性能 GEMM。 GLM5 的 batch 或 MTP 增大后,需要高吞吐的 Blackwell GEMM,不能沿用只适合 M=1 的 matvec。
为此,我保留常驻 worker 的执行方式,但把模型图、tile、地址和 event 依赖从 kernel 代码中移到 runtime plan,并接入可按 M 特化的 DeepGEMM。
一次 forward 开始前,Host 会把模型图拆成 tile,为每个 tile 生成一条 instruction,再把这些 instruction 排进 148 个 worker CTA 各自的 queue。
GPU 只启动一个 persistent kernel:每个 worker CTA 从自己的 queue 读取下一条 instruction,根据 opcode 调用已经编译好的 Add、RMSNorm 或 GEMM 实现;输入未就绪时等待 instruction 指定的 event,执行和写回完成后再更新 event,通知依赖它的后续 instruction。
因此,这个 persistent kernel 不再只执行一个写死的算子,而是执行 Host 为不同模型图生成的 instruction sequence。
下文把其中负责读取和分派 instruction 的执行循环称为 virtual machine;这里的 VM 只是 persistent kernel 内的一段 device 代码。
Host 侧:先捕获 OpGraph,再展开 TaskGraph
前端仍然像调用普通算子一样编排模型。下面用一个例子说明:
graph = OpGraph("attention_prefix")
x = graph.runtime_arg("x")
r = graph.runtime_arg("residual")
norm_w = graph.bound_weight("norm_w")
proj_w = graph.bound_weight("proj_w")

y = graph.add(x, r)
y = graph.rmsnorm(y, norm_w)
y = graph.blackwell_gemm(y, proj_w)
graph.set_outputs(y)
这些调用只在 Host 上记录算子和 tensor 的 def-use 关系,正式的 attention-pre 图,OpGraph 捕获的就是下面这张 DAG:
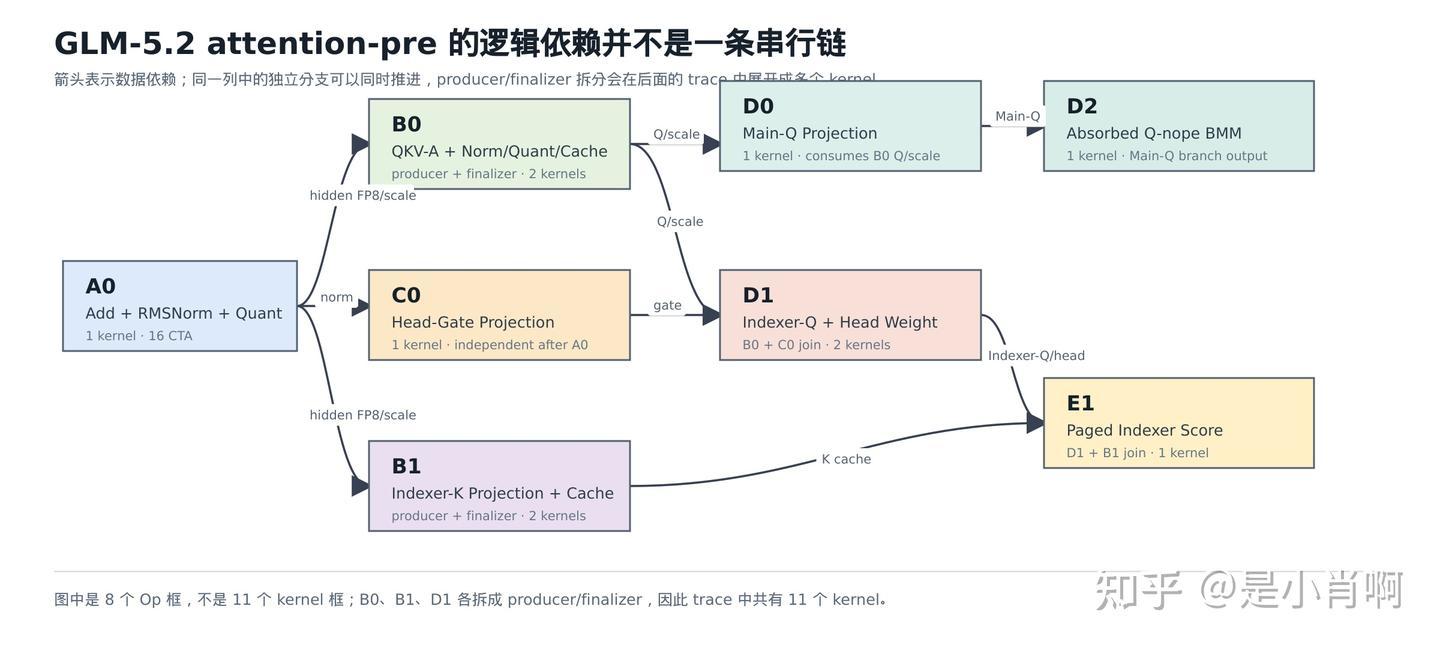
图中 A0 之后分出 B0、C0、B1 三条路径,B0 和 C0 汇合到 D1,D1 和 B1 再汇合到 E1。图中的 8 个逻辑 Op 中,B0、B1、D1 各自包含 producer/finalizer 两个 kernel,所以普通 CUDA 路径最终会看到 11 个 kernel。
OpGraph 的作用只是捕获这张模型 DAG;它还没有回答每个 CTA 做哪块数据、需要等多少结果。
执行前,runtime 按当前 shape 把同一张图展开成具体计划:
模型图定义
    -> OpGraph
    -> 每个 Op 按 tile 展开
    -> TaskGraph
    -> KernelPlan
    -> instruction tensor + event counter + operand pointer table
每个 Op 按自己的输出 tile 展开:A0 的 RMSNorm/quant 一行就是一个 tile;GEMM 按 (blockM, blockN) 输出块切分,再按 Split-K 展开;E1 按 request、Q-block 和 KV split 展开。正式 M=16, KV=8192 计划的数量如下:
A0: 16                         # 16 行
B0: 1 个 M tile × 21 个 N tile × split-K 4       = 84
C0: 1 个 M tile × 12 个 N tile × split-K 4       = 48
B1: 1 个 M tile × indexer-K split-K 8             = 8
D1: 1 个 M tile × 32 个 indexer head × split-K 4  = 128
D0: 1 个 M tile × 64 个 head × 2 个 N tile       = 128
D2: 1 个 M tile × 64 个 head × 4 个 N tile       = 256
E1: 4 个 Q-block × 16 个 KV task                  = 64
    (8192 / 256 个 KV split,每条 instruction 合并 2 个 split)
合计: 732 条 tile task
TaskGraph:把 tile 的读写范围变成 counter event
OpGraph 只记录两个 Op 之间存在 tensor 依赖;lowering 到 TaskGraph 时,Host 再根据 (producer Op, consumer Op) 查找配对策略。
已知组合可以注册细粒度策略,根据 producer 写入区域和 consumer 读取区域生成 event;没有注册的组合自动退化为 whole,让 consumer 等到整个 producer 完成。这样既能支持任意模型图,也不会为了追求细粒度 overlap 而放松正确性。
配对策略共有四种:
| 策略 | producer 与 consumer 的关系 | 生成的 event |
|---|---|---|
| whole | 不分析 tile 对应关系 | 所有 producer instruction 各递增一次 counter;consumer 等待完整计数 |
| tile | 一块 producer region 恰好对应一块 consumer region | 每个 region 一个 event,threshold 为 1 |
| tile_cover | 多块互不重叠的 producer region 完整覆盖一块 consumer region | producer 分别递增同一 counter,threshold 为覆盖块数 |
| tile_reduce | 多个 producer partial 对应同一块 consumer region | producer 分别递增同一 counter,threshold 为 partial 数量 |
从 Device 的 event 机制看,tile_cover 和 tile_reduce 完全相同,都是多个 producer 各自把同一个 counter 加一,consumer 等待 counter 达到 threshold。
区别只在数据关系和 Host 检查:tile_cover 是拼接,例如 A0 的 16 个 row tile 分别写入不同的行,共同覆盖 B0 要读取的 M16 输入;tile_reduce 是归约,例如 C0 的 48 个 K-split 都对同一个 gate tile 贡献 partial,全部归约完成后 D1 才能读取。Counter 只记录有多少 producer 已经完成,不负责执行数值归约。
whole 是保守的 fallback;另外三种策略只为已经确认过数据划分关系的 Op pair 注册。每个 Op 负责描述一条 instruction 读写的 TensorRegion,Host 据此检查 region 是否精确相等、完整覆盖或属于同一次归约,再生成 event_id 和 threshold。Device 不再处理这些配对逻辑,只在第一次读取输入前等待 counter >= threshold。
下面仍然使用上面的 M=16, KV=8192 计划。左侧是 OpGraph 的 tensor 边,右侧是 lowering 后真正执行的 task -> event -> task 关系:
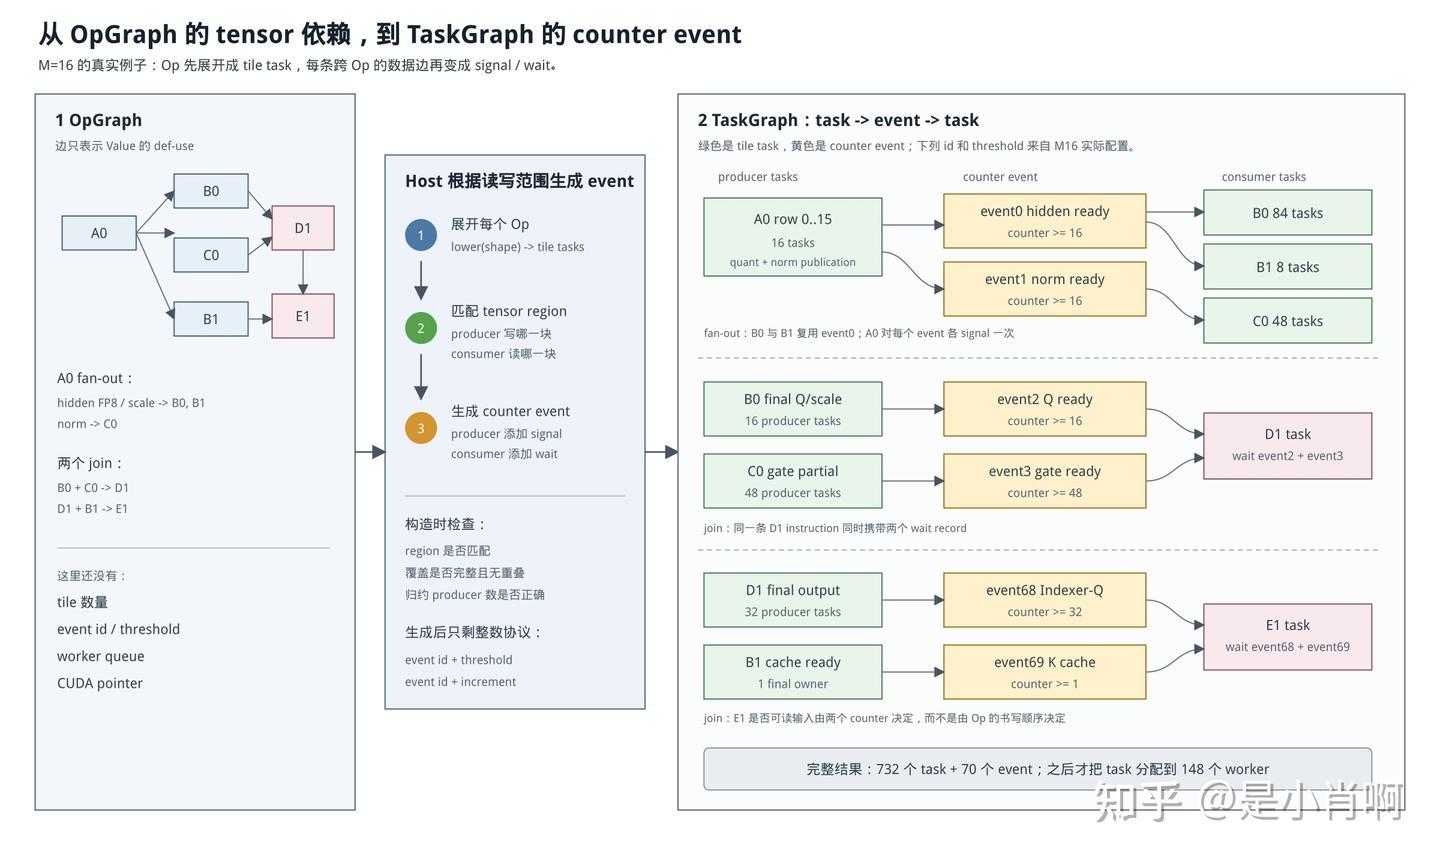
图中的 event 只有计数器和阈值两层含义:
- A0 发布 hidden FP8/scale 和 norm 两类结果,各有 16 个 row tile,因此
event0 >= 16供 B0、B1 使用,event1 >= 16供 C0 使用。 - B0 的 16 个最终 Q/scale tile 递增
event2,C0 的 48 个 gate partial 递增event3;D1 的每条 instruction 同时等待event2 >= 16和event3 >= 48,这就是 B0+C0 的 join。 - D1 最终产生 32 个 Indexer-Q/head-weight tile,递增
event68;B1 的 cache 写回完成后递增event69。E1 只有在event68 >= 32且event69 >= 1时才读取输入。 - D0 的 128 个 projection tile 按输出区域两两归并成 64 个 event,每个 event 的 threshold 是
2,D2 对应区域满足后即可开始。
因此,这个计划一共生成 70 个 event。换成另一个 M、batch 或 KV length 时,变化的是 tile 数量、生产次数和 threshold;event 的等待/发布规则不需要修改常驻 kernel。
KernelPlan:把 732 条 task 放入固定 worker queue
TaskGraph 完成依赖检查后,KernelPlan 才负责把任务排到 worker queue。
当前版本按 round-robin 将 732 条 instruction 分到 148 个 worker queue:其中 140 个 worker 有 5 条有效 instruction,另外 8 个 worker 有 4 条有效 instruction,再用一条 NoOp 补齐。
因此 device 看到的张量形状固定为 [148, 5, 32],而不是在 GPU 上维护一个需要不断扫描的 ready queue。
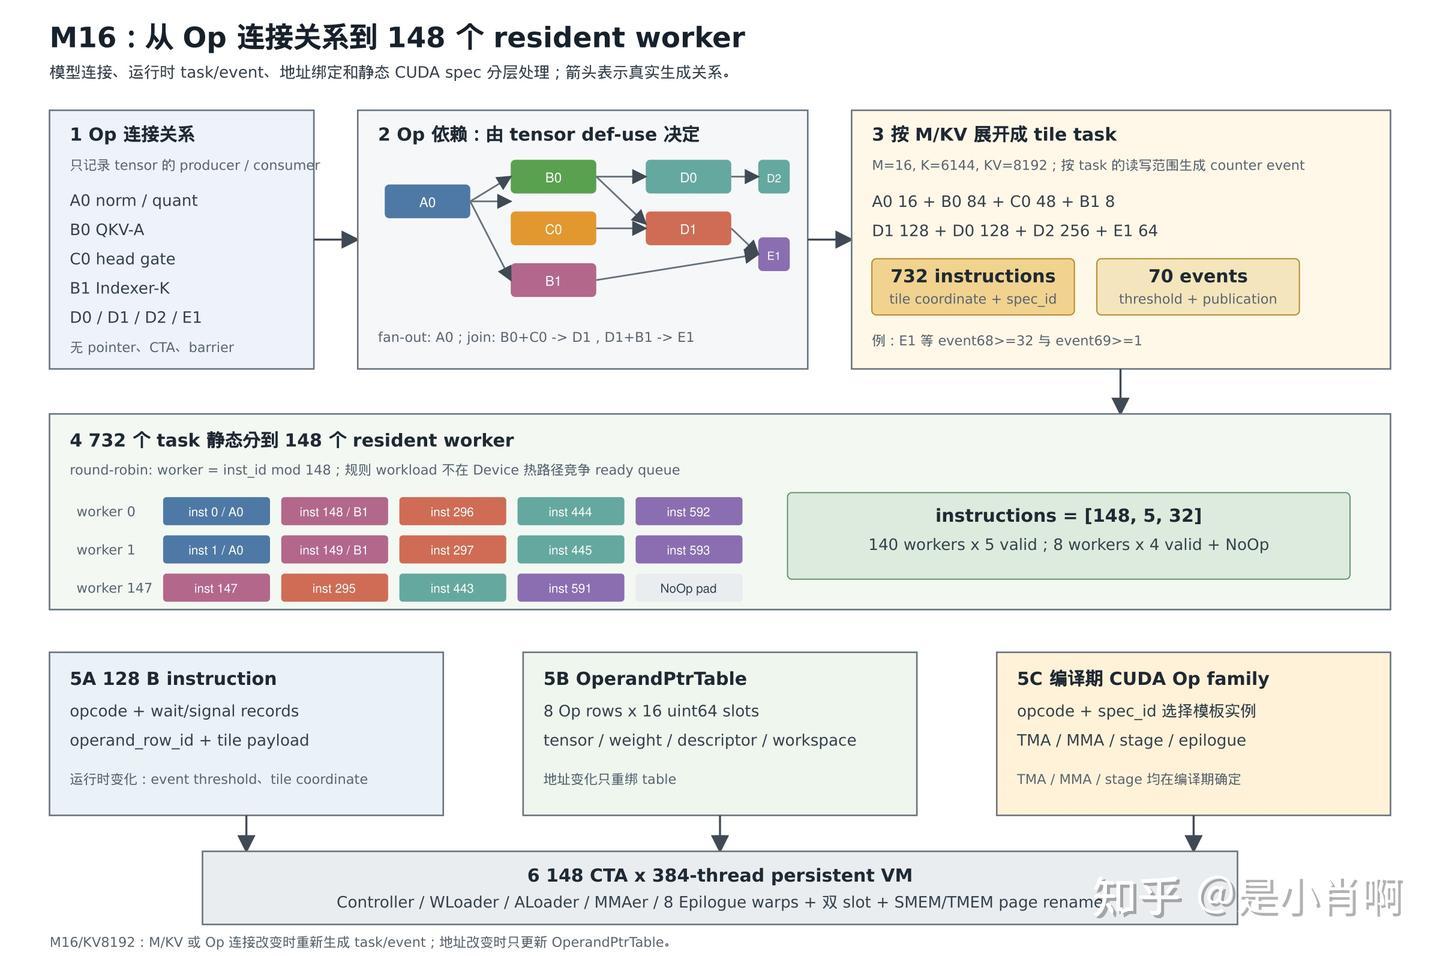
这里的 instruction 是一条固定大小的任务描述,不是把 CUDA kernel 代码重新编码一遍。每条 instruction 有 32 个 uint32,即 128 B:
[opcode, wait_count, signal_count, operand_row_id,
 wait(event_id, threshold),
 signal(event_id, increment, publication_id),
 payload(tile 坐标和少量动态参数), padding]
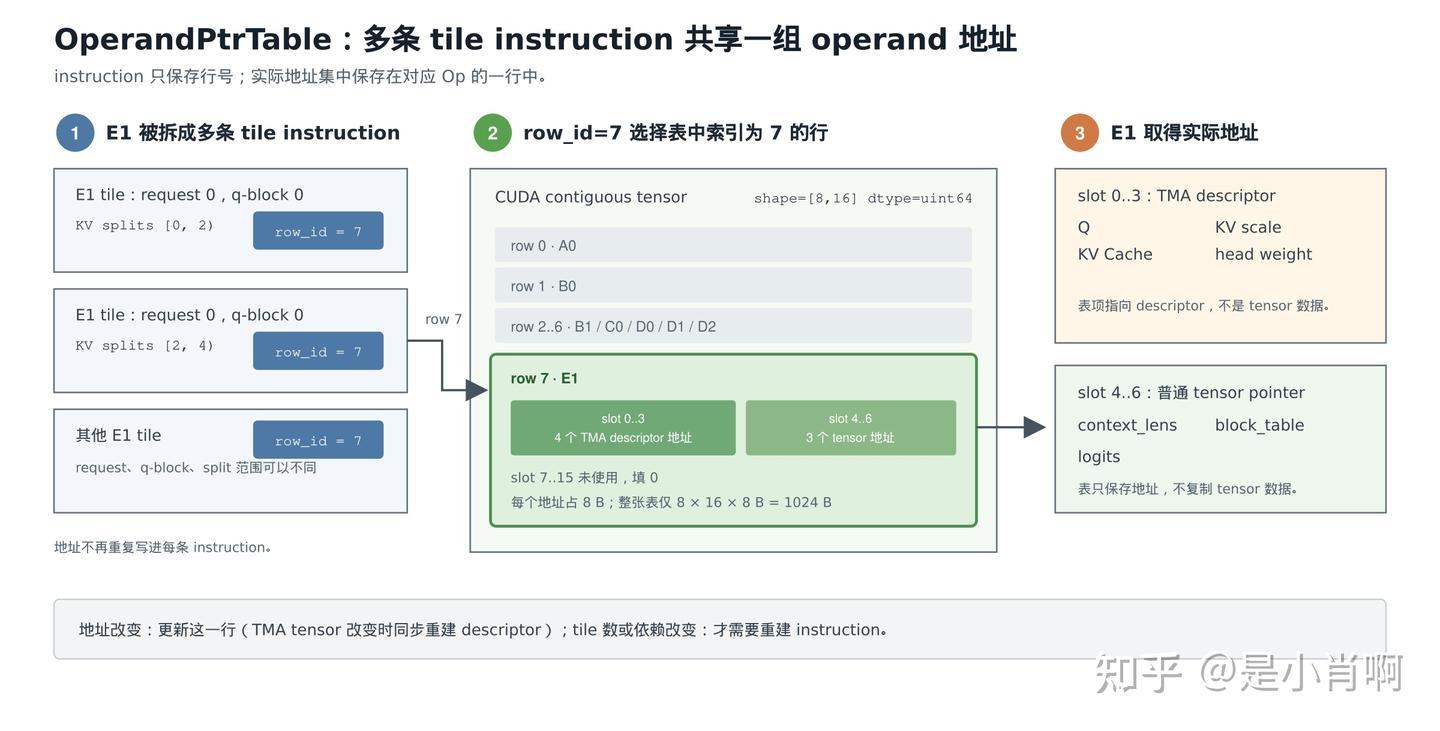
以 E1 的一条真实 instruction 为例,它只保存 request、Q-block、KV split 范围、需要等待的 event68>=32/event69>=1,以及 operand_row_id=7;它不保存任何绝对 CUDA 地址。opcode + spec_id 选择编译期已经生成的 CUDA Op family,动态部分只有 tile 坐标、event threshold 和少量 stride。
为什么还要单独设计 OperandPtrTable?正式 M16 图只有 8 个 Op,却有 732 条 tile instruction。
同一个 Op 的所有 instruction 读取相同的一组 tensor;如果每条 instruction 都保存完整的 64-bit CUDA pointer,这些地址会被重复几百次,占用本来只有 128 B 的 instruction,而且换一批输入或 workspace 时还要重写整张 instruction tensor。
OperandPtrTable 把这些地址单独保存成一个连续的 CUDA tensor:
shape = [num_ops, 16]
dtype = torch.uint64
device = CUDA

本文的 A0 到 E1 图:shape = [8, 16],共 8 x 16 x 8 B = 1024 B
每个 Op 占一行,同一个 Op 拆出的所有 tile instruction 共用这行;16 个 slot 的含义由该 Op 自己定义,未使用的 slot 填 0。
以 E1 为例,所有 E1 instruction 都保存 operand_row_id=7。Device 端据此计算 table + 7 x 16,取出索引为 7 的行,也就是表中的第 8 行:
slot 0..3 : Q、KV Cache、KV scale、head weight 的 TMA descriptor 地址
slot 4    : context_lens 地址
slot 5    : block_table 地址
slot 6    : logits 地址
slot 7..15: 0
表里保存的只是地址,不会复制 tensor 数据。仅仅更换输入、权重、KV Cache 或 workspace 时,只需重建或更新 OperandPtrTable;通过 TMA 访问的 tensor 如果地址或 shape 发生变化,还要同步重建对应的 TMA descriptor,但仍不需要修改 instruction 和 worker queue。
只有 M/KV 改变了 tile 数或 event threshold,或者模型连接发生变化时,才需要重新生成 task、event 和 worker queue。
这样,地址变化不会污染 instruction ABI,CUDA tile 实现仍由编译期的 Op family 负责。
下图只画 OperandPtrTable 的寻址过程:多条 E1 tile instruction 虽然负责不同的 Q-block 和 KV split,但都通过 operand_row_id=7 读取索引为 7 的同一行地址。
Device:常驻 CTA 如何执行 tile instruction
Host 已经把模型图展开成 instruction,并把它们分到 worker queue。
Device 侧不再推导模型依赖或重新划分 tile,而是启动一次 148 CTA x 384 threads 的 persistent kernel,让每个 CTA 长期循环执行自己队列中的 instruction。
一条 instruction 对应一个 CTA 负责的 tile;同一个 CTA 在不同迭代中可以先执行 A0 的一行,再执行 D2 的一个 GEMM tile,下一条还可以来自另一个 Op。这个“常驻 CTA + instruction loop”才是 Device 侧的基本执行模型。
普通 kernel 只执行一种固定计算,所需状态随 CTA 结束一起释放;MegaRTP 的常驻 CTA 却要连续执行来自不同 Op 的 instruction,因此必须在 SMEM 中为每条正在执行的 instruction 保存独立状态。
每份状态占 5120 B,主要包括 128 B instruction、13 个 logical page 到 physical page 的映射、slot 生命周期和 Op 内部使用的 local mbarrier,以及 4 KiB instruction-local scratch。
如果只保留一个 slot,Controller 必须等当前 instruction 的所有 role 完成后,才能读取和准备下一条 instruction,整个 CTA 仍然是串行执行。
为了让下一条 instruction 的准备与当前 instruction 的计算重叠,每个 CTA 配置两个 slot,共占 10240 B:当前 instruction 使用一个,Controller 在另一个中写入下一条 instruction、建立 page 映射并初始化 local mbarrier;旧 instruction 完成后,两个 slot 交替复用。
384 个线程按 warp specialization 固定分工:warp 0 是 Controller,warp 1 是 MMAer,warp 2 是 ALoader,warp 3 是 WLoader,warp 4--11 是 Epilogue。
它们不是由 Controller 依次调用的五个函数,而是五个同时推进的 role loop;每个 role 只等待自己真正需要的状态。
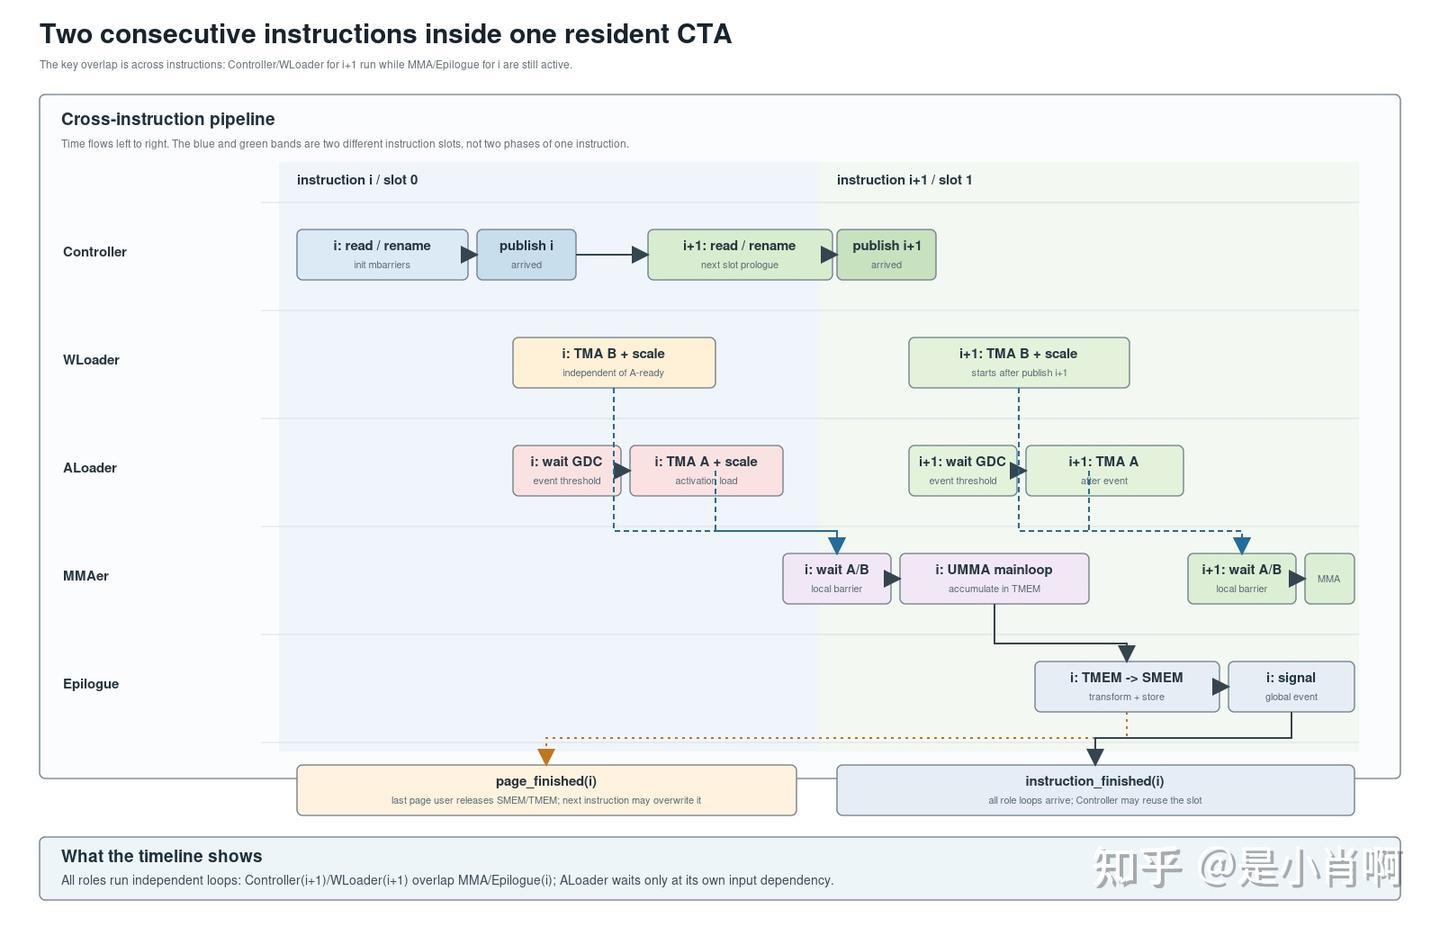
相邻两条 instruction 在 resident CTA 内的 warp 交互
图中蓝色和绿色区域分别是 instruction i 与 instruction i+1。一次交接按下面的顺序发生:
1、 Controller 等待当前 slot 的上一代 instruction 完成,然后把下一条 instruction 拷入 slot,更新 page 映射,并初始化本条 Op 的 local mbarrier。
这些 mbarrier 是 CTA 内部的数据阶段同步:WLoader/ALoader 用它们通知 MMAer 输入已经到达,MMAer 再用它们通知 Epilogue 可以消费结果。
2、 Controller 完成这些准备后,arrive instruction_arrived。这是 MegaRTP 专用的 slot 发布协议,不是 Op 的计算 barrier:它保证其他 role 只有在描述、page 映射和 semaphore 都写好后,才能读取这个 slot。
3、 WLoader 看到发布就可以预取与上游无关的权重和 scale;ALoader 直到真正读取上游 activation 的位置才等待 global event。依赖满足后,ALoader 搬运 activation,并用 local mbarrier 把它交给 MMAer。
4、 MMAer 等待 A/B 两类 local mbarrier 后进入 tcgen05/UMMA 主循环。此时 Controller 可以在另一个 slot 准备 i+1,WLoader 也可以预取 i+1 的权重;因此 i+1 的 prologue 能够和 i 的 MMA 重叠。
5、 i 的 Epilogue 从 TMEM 取结果、完成转换和写回,然后发布下游 global event。所有非 Controller role 都完成自己的收尾后 arrive instruction_finished,Controller 才能覆盖这个 slot。
这五种状态各自保护不同的对象:
instruction_arrived
    Controller 发布“这个 slot 的 instruction 已经准备好”;其他 role 先 wait,再读 slot。

Op-local mbarrier
    CTA 内 loader -> MMAer -> Epilogue 的阶段交接;普通 CUDA kernel 也可以使用。

global event counter
    跨 CTA 的 tile 数据就绪计数;producer 发布计数,consumer 在第一次读数据前等待阈值。

page_finished
    某个物理 SMEM/TMEM page 的最后一个使用者释放它;下一条 instruction 才能覆盖这块片上内存。

instruction_finished
    当前 slot 的所有 worker role 都收尾;Controller 获得复用该 slot 的许可。
这几种同步不能混用:instruction_arrived 表示其他 role 可以读取当前 slot,local mbarrier 负责当前 instruction 内部的数据阶段交接,global event 表示另一个 CTA 产出的 tile 已经可读;page_finished 允许下一条 instruction 覆盖某个 physical page,instruction_finished 则允许 Controller 覆盖整个 slot。
共享内存分页:让相邻 instruction 逐页交接 SMEM
双 slot 只复制了 instruction 的状态,并没有为两条 instruction 各准备一整套数据缓冲区。两条 instruction 仍然共享同一份用于存放权重、activation 和输出 tile 的 SMEM。
这块 SMEM 被切成 13 个 16 KiB 的 physical page。当前 instruction 尚未用完其中一些 page 时,下一条 instruction 可能已经开始加载数据,因此这里必须分别解决两个问题:下一条 instruction 使用哪个 physical page,以及什么时候可以覆盖它。
第一个问题由 pid_order 解决。每个 Op 的实现只使用 logical page id,例如 logical page 0 表示自己的第一块权重缓冲区;每个 instruction slot 则保存一张包含 13 项的 pid_order,把 logical page 映射到本轮实际使用的 physical page。Op 通过这张表取得地址,所以代码不需要把 physical page 编号写死。
Controller 准备下一条 instruction B 时,会为 B 的每个 logical page 生成映射。以 B 的 logical page 0 为例:Controller 调用前一条 instruction A 的 release_lid(0),询问它应该继承 A 的哪一个 logical page;假设返回 2,而 A 的映射是 pid_order_A[2]=7,那么 Controller 就写入:
pid_order_B[0] = pid_order_A[release_lid_A(0)] = 7
也就是说,B 仍然把这块缓冲区称为 logical page 0,但本轮实际使用 physical page 7。release_lid 会为 13 个 logical page 分别给出继承关系,形成 B 的整张映射。
各个 Op 根据自己的 page 使用顺序安排这张映射,尽量让下一条 instruction 的权重等前置加载落到上一条 instruction 较早释放或没有使用的 page 上。第一条 instruction 没有前驱,才直接采用 logical page i -> physical page i。
但映射到 physical page 7,并不表示 B 已经可以写入它。
第二个问题由每个 physical page 自己的 page_finished mbarrier 解决:B 的 loader 在覆盖 page 7 前先等待 page_finished[7];A 对 page 7 的最后一次读写完成后,由最后一个使用者 arrive 这个 mbarrier,B 才能开始加载。
其他 page 各自交接,因此 B 不必等待 A 整条 instruction 结束,只需等待自己真正要覆盖的 page。
pid_order 保存在双 slot 中,也只需要保留相邻两代。instruction i+1 读取 slot i 的映射并写入 slot i+1;准备 instruction i+2 时,它已经改为读取 slot i+1,而 slot i 只有在 instruction i 的所有 role 完成后才会被覆盖。
于是,pid_order 决定 page 的继承关系,page_finished 保证覆盖时机,两者共同实现相邻 instruction 的逐页交接。
大 M:按本轮模型图生成 GEMM 实现
共享 page 解决了不同 Op 如何复用片上内存,但 GEMM 还有另一个问题:同一个 persistent kernel 里会出现很多种矩阵乘。
以 attention-pre 为例,Q 投影、Indexer-K 和 Main-Q 的权重矩阵 K/N 都不同;batch 或 MTP 改变后,输入行数 M 也会改变。M=16 时可能只有一两个 M tile,M=128 时则要处理多个 M tile,适合的 blockM、stage 和 epilogue 组合也可能不同。
如果把某一套 GEMM 模板和配置写死在 kernel 里,就只能把一种权重 shape 和一种 M 做好:换一个 GEMM 要么复用不合适的 tile,要么退回只适合小 M 的 GEMV;提前手工准备几套固定配置也覆盖不了任意模型、batch 和 MTP。
把所有可能的模板都编译进去,则会让执行类越来越大,而且仍然无法覆盖新的 shape。
MegaRTP 把“本轮需要哪些 GEMM 实现”交给 Host 在 OpGraph -> TaskGraph 时决定。前端遍历本轮模型图中的 GEMM,根据权重 shape、输入 M 和选定的 tile 划分生成配置记录,并把完全相同的配置去重。例如:
本轮模型图:
  GEMM-A:K=6144, N=2624 -> spec 0
  GEMM-B:K=6144, N=32   -> spec 1
  GEMM-C:K=6144, N=2624 -> 复用 spec 0
随后 codegen 只为 spec 0 和 spec 1 实例化对应的 C++ GEMM 类型、pipeline 和 epilogue,并把这些类型编入同一个执行类。它生成的是类和模板特化,不是每个 spec 一个新的 kernel;常驻 kernel 仍然只有一个。
Runtime instruction 只保存 opcode、spec_id 和当前 tile 的坐标。CTA 在 device 端读取 spec_id,通过编译时展开的 spec 分支选择对应实现;
真正被调用的每个 spec 都已经编译好,TMA shape、Tensor Core 主循环、SMEM/TMEM 布局和 epilogue 不需要在 device 端重新生成。
这样,模型图、权重 shape、batch 和 MTP 可以变化,真正执行大 M GEMM 的路径仍然保持编译期特化。
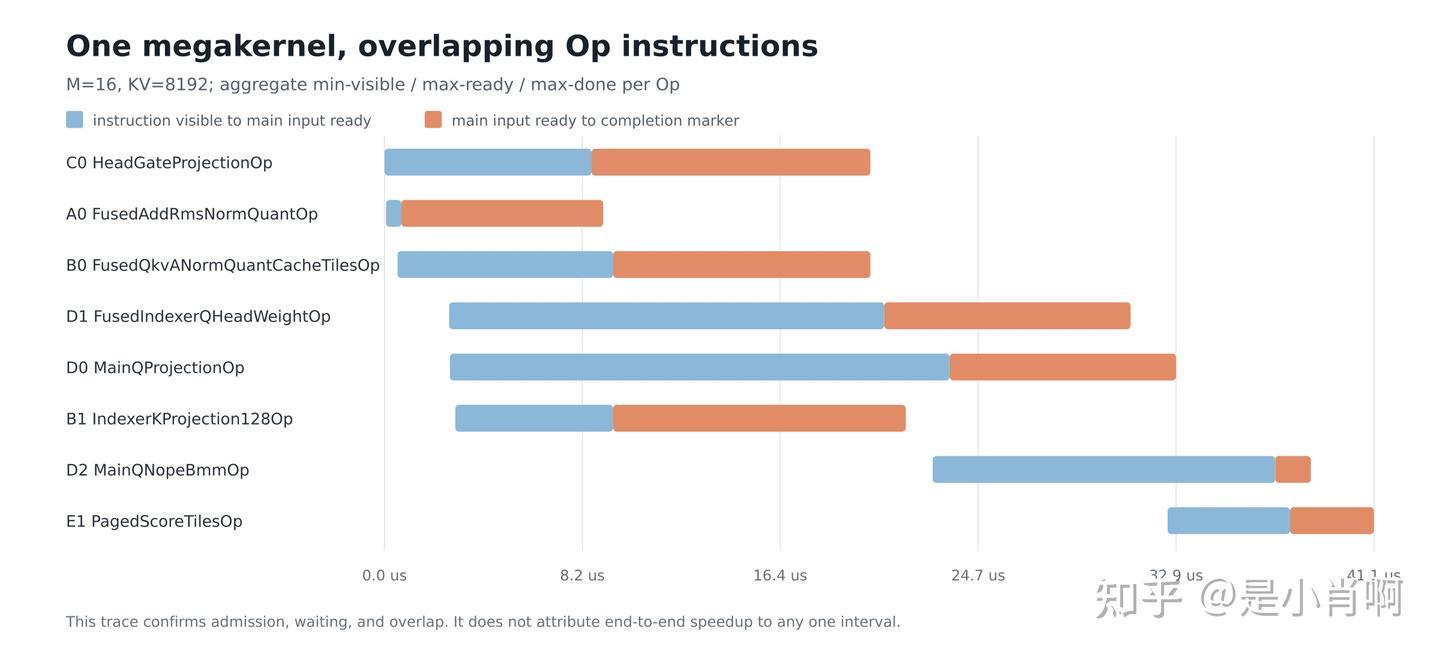
kernel 内的 trace:记录 tile 级执行时间
为了确认不同 Op 的 instruction 是否真的重叠,我另外编译了一个带 kernel 内打点的版本。它在每条 instruction 的三个位置记录 GPU 时间戳;正式性能版本关闭这些打点:
Visible
    WLoader 已看到 instruction_arrived,可以开始预取独立权重。

MainInputReady
    ALoader 已完成主 activation 的 global event wait,输入现在可以被读取。

SemanticDone
    Epilogue 已完成最终 store 和 event publication,语义上的输出已经完成。
时间戳由 GPU global timer 取得,先写入当前 slot 的 SMEM trace buffer。Controller 在 slot 即将复用时,用一个 warp 把这条记录以 coalesced store 写回 global tensor;最后两个尚未被下一条 instruction 覆盖的 slot,在 kernel 退出前再 drain。
输出形状为 [num_workers, max_iters, 32],每条 instruction 预留 32 个 uint32,前三个位置用于上面的三个时刻。
trace 只在诊断版本中编译打开,正式 kernel 不分配这些记录,也不执行写回。配对测量显示,完整 workload 的 trace 开销一般约为 2%,控制在 5% 以内。
收益:让 tile 在 kernel 边界之外重叠
在相同的 M=16, KV=8192 测试中,按前文扣除固定执行框架的诊断口径,MegaRTP 的计算与调度部分估算为 39.601 us;相对于 11 个 kernel 串行执行的 61.631 us baseline,减少 22.030 us,约 35.8%。
收益来自三件事:独立分支的 tile 可以交错执行;producer 完成一个 tile 后就能通过 global event 让 consumer 开始,而不必等 producer 的所有 tile 完成;同一个 CTA 里,下一条 instruction 的 Controller/WLoader prologue 可以和当前 instruction 的 MMA/Epilogue 重叠。
下图的每个区间都来自在 kernel 内实际写入的 GPU 时间戳:先记录 instruction 被看到、主输入就绪和最终写回三个时刻,再按 worker queue 解码成时间线。
每一行是一类 Op 的 instruction 区间,浅色段表示从 instruction 可见到主输入就绪,深色段表示从主输入就绪到语义完成。
不同颜色区间在同一时间段并列出现,说明不同 Op 的 tile 已经在不同 worker 或不同 role 上同时推进;这正是普通单流 kernel 边界无法表达的 overlap。
代价:固定框架和算子迁移
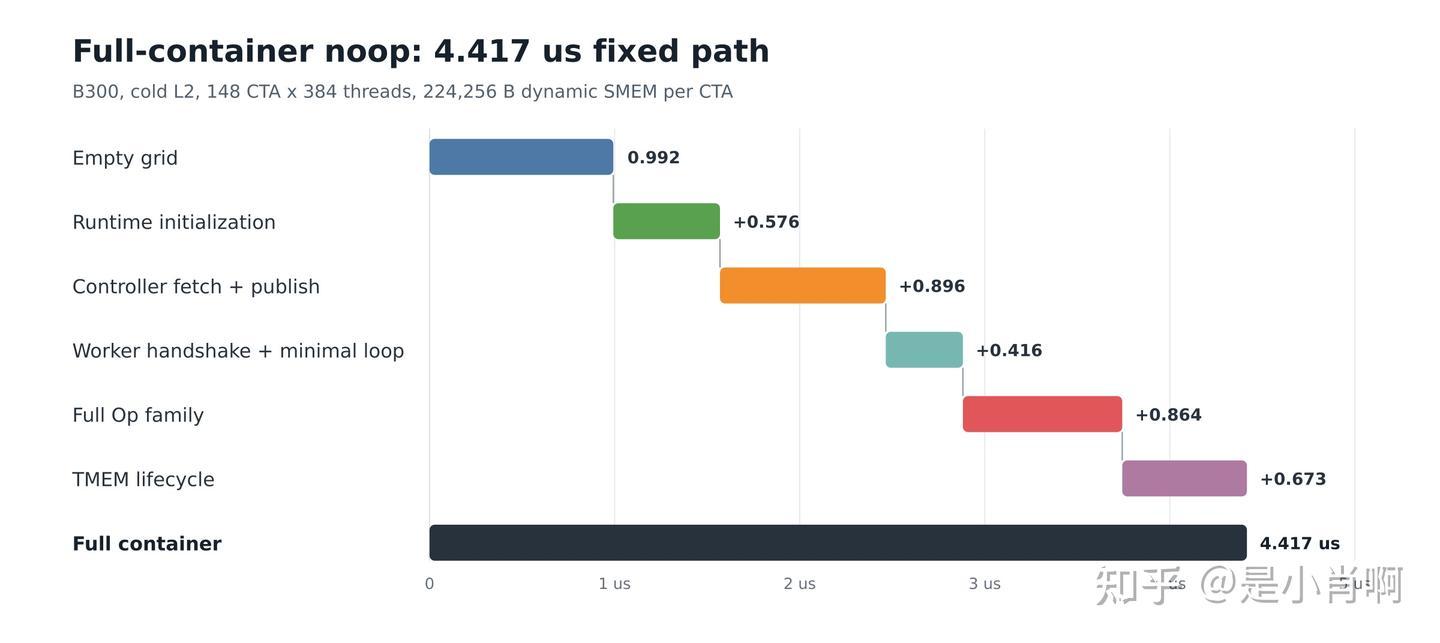
为了量出执行框架本身的固定成本,我运行同样的 resident CTA、slot、page、TMEM 和退出流程,但不执行实际 Op,得到空框架时间 4.671 us。
固定时间来自 persistent kernel 启动、CTA 状态和 page barrier 初始化、instruction 读取与发布、role 握手、TMEM 生命周期以及退出同步。对于当前几十微秒的 M16 子图,这个固定成本已经足以影响最终方案选择。
迁移一个普通 CUDA kernel 还要付出另一类成本。它不能只把 kernel 函数搬进 resident CTA,而要重新按 tile 定义输入输出区域和 event,拆出 Controller、ALoader、WLoader、MMAer、Epilogue 各自的职责,并为每个 page 标出最后一个使用者。
原 kernel 中隐含的线程协作、shared-memory 地址、barrier 和写回顺序,都必须改写成 instruction、slot、page 和 publication 约定。
有些 kernel 的执行资源也和当前 worker 模型不匹配。比如 2-SM tcgen05.mma 要求一对 CTA 同时到达,并共同执行同一个 GEMM;MegaRTP 的 CTA 却是从各自的 worker queue 独立取 instruction,不能只靠普通的任务分发就保证这两个 CTA 恰好同时领取这一对 task。要支持它,需要额外的成对预留和同步调度。
TopK 是另一种情况:当前高性能实现通常让单个 CTA 使用 1024 个线程,而 MegaRTP 的 resident CTA 固定为 384 个线程,如果强行用384线程去做topk,性能会比1024线程有回退。
5. 重新思考:MegaRTP 的收益来自哪里
61.631 us -> 44.272 us 已经证明,打破原来的 kernel 串行顺序确实缩短了这段路径。但 kernel 内 trace 也让我继续追问:这 17.359 us 到底来自 Megakernel 特有的 tile 级依赖,还是来自更容易保留的 kernel 并行和提前加载?
Trace 中最明显的两类 overlap
第一类是 DAG 中独立分支的并行执行。
A0 之后的 B0、C0 和 B1 分属三条路径:trace 中三者的输入分别在约 8.6--9.5 us 就绪,随后同时计算,并在约 20--22 us 完成;B0 之后,D0 与等待 B0+C0 的 D1 也在约 20.5 us 同时进入主计算。原来被单流排开的 GEMM,现在共同使用同一时间段里的 SM。
第二类是 下游 instruction 提前进入,并在等待输入时完成准备工作。
以 D1 为例,128 条 instruction 最晚在 11.232 us 已经 Visible,但主输入到 20.576--20.768 us 才 Ready。
中间约 9 us 的窗口里,Controller 已经准备好 instruction,WLoader 也可以加载不依赖 B0/C0 输出的权重和 scale。B0、C0 和 B1 同样在 A0 输出就绪前就已经 Visible。
这里的 trace 只能证明这段准备窗口存在,不能把整个 Visible -> MainInputReady 都算成有效预取;真正能隐藏多少时间,仍要由后面的 matched PDL 实验测量。
累计接入实验给出了更直接的证据:我从 A0+C0 开始逐步加入 B1、B0、D0、D1、D2 和 E1,同时记录子图总耗时增加了多少,以及新增 Op 按相同配置单独执行需要多少时间。
下面是一次独立实验,所有时间都扣除了 MegaRTP 空框架的固定开销;它与前文的 39.601 us 不是同一轮测量,不能把最终的 40.559 us 与正式结果混用。
每一步还会为新增 Op 扫描配置,因此这张表用来观察整体趋势,而不是严格的逐项消融。
| 累计子图 | 子图总耗时 / us | 加入后增加 / us | 新增 Op 单独执行 / us |
|---|---|---|---|
| A0+C0 | 7.504 | 7.504 | 7.504 |
| +B1 | 12.032 | 4.528 | 9.088 |
| +B0 | 16.096 | 4.064 | 10.463 |
| +D0 | 26.832 | 10.736 | 9.200 |
| +D1 | 29.568 | 2.736 | 7.217¹ |
| +D2 | 36.736 | 7.168 | 6.368 |
| +E1 | 40.559 | 3.823 | 5.343 |
最明显的是 B1 和 B0:两个 Op 单独执行分别需要 9.088 us 和 10.463 us,接入后却只让整个子图增加 4.528 us 和 4.064 us。E1 也只把关键路径拉长了 3.823 us,低于单独执行的 5.343 us。这些差值说明,新增 Op 的相当一部分执行时间确实与已有子图重叠了。
但接入 D0 和 D2 后,子图增加的时间反而略高于新增 Op 单独执行的时间。原因是 Op 并发以后会争用 SM、Tensor Core 和显存带宽,新增 Op 的耗时不能简单地从整图耗时中逐项相减出来。。
回到 TaskGraph:关键路径几乎都在等待完整的 M16 数据块
这张表证明了 overlap 的存在,但还不能回答它究竟来自独立 kernel 并行、提前加载,还是 Megakernel 特有的 tile 级依赖。要区分这几种来源,需要回到前面的 M16 TaskGraph 和实际生成的 event。
tile 级依赖允许 producer 每完成一个 tile 就更新 event,让 consumer 不必等待整个上游 Op。这个机制在长 grid 或通信流水中很重要,但本例的关键路径并没有留下这样的窗口。
这张图中的主要计算都是 GEMM,而 M=16 恰好等于这些 GEMM 的 blockM=16。因此每个 GEMM 在 M 方向只有一个 tile。
更关键的是,上游 GEMM 沿 N 方向输出的多个 tile,往往会成为下游 GEMM 的完整 K 维输入;下游只有等这些 tile 全部到齐,才能计算自己的唯一一个 M tile。实际生成的 event 正是这样:
| 依赖 | Consumer 实际等待 | 对应含义 |
|---|---|---|
| A0 -> B0/B1 | event0 >= 16 | A0 的 16 行 hidden/scale 全部就绪 |
| A0 -> C0 | event1 >= 16 | A0 的 16 行 norm 输出全部就绪 |
| B0 -> D0 | event2 >= 16 | 组成 K=2048 输入的 16 个 Q/scale tile 全部就绪 |
| B0+C0 -> D1 | event2 >= 16 且 event3 >= 48 | B0 的完整 Q/scale 和 C0 的全部 48 个 partial 都已就绪 |
| D1+B1 -> E1 | event68 >= 32 且 event69 >= 1 | 32 个 Indexer-Q/head tile 和整次 K Cache 写回都已完成 |
也就是说,虽然 TaskGraph 使用的是 counter event,而不是 kernel finished,但这些 threshold 在当前 shape 上已经接近“上游 kernel 的相关输出全部完成”。
这里没有第二个 M tile 可以提前交给下游:第一块数据就是全部 M=16。
因此,critical path 上的 consumer 仍要等到上游 GEMM 的主体计算结束,tile 级 event 并没有比 kernel 级数据依赖更早地释放主计算。
D0 -> D2 是一个真实的例外。D0 为每个 head 生成独立 event,threshold 为 2;对应 head 的两个 N tile 完成后,D2 的四个 tile 就能开始,不必等待另外 63 个 head。
trace 中最早的 D2 在约 29.25 us 输入就绪,而 D0 最晚到约 32.90 us 才完成,说明这里确实发生了约 3.6 us 的逐 head overlap。
但本次 trace 最晚结束的是另一条分支上的 E1,时间为 41.120 us;D0/D2 这条支路没有决定最终完成时间。因此,这个细粒度 overlap 是存在的,却没有转化为本例 critical path 上的额外收益。
至此,MegaRTP 在本例中真正决定整体时间的机会可以收敛为两类:独立 kernel 并行执行,以及 dependent kernel 在输入就绪前完成 prologue 和权重预取。
前者可以由 Multistream 表达,后者可以由 PDL 表达,同时每个 CUDA kernel 还能保留最合适的线程数、cluster、SMEM/TMEM 布局和矩阵乘法配置。
基于这个判断,我尝试保留各个 standalone kernel 的高性能实现,再用 CUDA Graph + Multistream + PDL 组合它们,看看能否复现 MegaRTP 的主要收益。不过在介绍具体实现之前,需要先说明 Multistream 和 PDL 分别如何表达这两类 overlap。
6. Multistream + PDL 的技术基础
Multistream:让无依赖分支并行执行
CUDA stream 只保证同一条 stream 内的 kernel 按顺序执行;不同 stream 之间如果没有 event 依赖,kernel 就具备并发执行的条件。
把 QKV-A、Head-Gate 和 Indexer-K 三条无依赖分支放入不同的 stream 后,一条分支没有占满的 SM 可以执行其他分支的 CTA。这个过程不改变任何 kernel 内部实现,解决的是独立分支被单流强制串行的问题。
PDL:把启动许可和数据就绪分开
PDL 把“consumer 可以进入 GPU”和“consumer 可以读取 producer 输出”拆成了两个时刻。Producer 的每个 CTA 到达选定位置后,都由一个线程调用:
cudaTriggerProgrammaticLaunchCompletion();
等所有 CTA 都 trigger 或退出后,consumer 才有机会被调度。这个信号只允许 launch,并不表示 producer 的输出已经写完。
因此 trigger 可以放在 producer 较早的安全位置:例如 A0 发出与输入无关的 norm-weight TMA 后就允许后续 kernel 进入,B0 和 D1 的 producer 也可以先允许各自的 finalizer 预取静态参数。Consumer 在读取 producer 输出之前仍要调用:
cudaGridDependencySynchronize();
下文把这个调用简称为 GDC。它会等待直接依赖的 producer grid 完成,并保证后续读取能够看到 producer 的写回。GDC 只阻塞执行它的线程,并不是整个 CTA 的 barrier,因此不读取 producer 输出的线程仍可继续工作。
Trigger 提前并不会破坏正确性,因为真正的数据读取仍受 GDC 约束。如果把 GDC 放在 kernel 入口,consumer 的初始化和权重预取也会一起被挡住;如果放到第一次 activation load 之后,结果就可能错误。
Programmatic Event:跨 stream 建立 PDL 依赖
PDL 不只适用于同一条 stream 或 CUDA Graph。CUDA 还允许把一个 cudaEvent_t 绑定到 producer kernel 的 programmatic launch completion,再让另一条 stream 等待这个 event。
普通 event 要等 producer stream 中此前的工作全部完成;Programmatic Event 则在 producer 的所有 CTA 都 trigger 或退出后就能唤醒 consumer stream,此时 producer kernel 可以仍在执行。
Host 侧的关键不是用特殊 API record event,而是在启动 producer 时通过 cudaLaunchAttributeProgrammaticEvent 绑定 event:
cudaEvent_t ready;
cudaEventCreateWithFlags(&ready, cudaEventDisableTiming);

cudaLaunchAttribute attr{};
attr.id = cudaLaunchAttributeProgrammaticEvent;
attr.val.programmaticEvent.event = ready;
attr.val.programmaticEvent.flags = 0;
attr.val.programmaticEvent.triggerAtBlockStart = 0;

cudaLaunchConfig_t config{};
config.gridDim = producer_grid;
config.blockDim = producer_block;
config.stream = producer_stream;
config.attrs = &attr;
config.numAttrs = 1;
cudaLaunchKernelEx(&config, producer_kernel, producer_args);

cudaStreamWaitEvent(consumer_stream, ready, 0);
consumer_kernel<<<consumer_grid, consumer_block, 0, consumer_stream>>>(consumer_args);
Producer 的每个 CTA 在选定位置由一个线程调用 cudaTriggerProgrammaticLaunchCompletion();event 被触发后,consumer 可以跨 stream 提前启动。
Consumer 可以先做 prologue、权重预取等不依赖 producer 输出的工作;任何读取 producer 输出的线程都必须先执行 GDC。因此,Programmatic Event 传递的是“可以启动”,不是“数据已经就绪”。
后文的 Graph rewrite 方案使用 Graph programmatic edge,手动 Multistream 使用这里的 Programmatic Event。两种接口表达的是同一套 PDL 关系:producer trigger,consumer 提前进入,真正读取数据前再 GDC。
改造 DeepGEMM:拆分 A 和 W 的 Loader
原始 DeepGEMM 在入口等待上游,随后由同一个 TMA loader 搬运 activation A、权重 B 以及两者的 scale。这样做虽然正确,但 A 尚未就绪时,完全独立的 B 也无法提前加载。
我为需要 PDL 的 GEMM 增加了 split-loader 路径:warp 0 只负责 activation A 及其 scale SFA,warp 3 只负责静态权重 B 及其 scale SFB。
Kernel 完成公共的 scheduler、descriptor 和 barrier 初始化后,只有 warp 3 跳过 GDC,先把权重流水线填起来;其他 warp 仍执行 GDC,避免任何依赖本轮 activation 的工作越过等待点。
warp 0  ALoader:GDC -> A / SFA TMA --+
                                        +-> full barrier -> MMA -> Epilogue
warp 3  WLoader:------> B / SFB TMA --+
拆分后,每个 stage 的 full barrier 等待 ALoader 和 WLoader 两次 arrival。WLoader 最多提前填满 kNumStages 个 stage;再往前会阻塞在 empty barrier,因此不会覆盖 MMA 尚未消费的权重。
Activation ready 后,ALoader 补上 A/SFA,两路数据在 full barrier 汇合,后面的矩阵乘法逻辑不变。
最后还要检查编译后的指令顺序。我曾观察到,指向 producer 输出的参数带 const __restrict__ 时,编译器会把 activation load 移到 GDC 之前。
对此不能只看 CUDA 源码;我去掉了危险限定,并用最终 SASS 确认 acquire 在 load 之前,再用污染输入和重复 Graph replay 验证没有提前读取。
PDL 的收益到底来自哪里
前面的执行模型说明了 PDL 允许哪些工作提前发生,但还没有回答 consumer 提前进入 GPU、prologue 和权重预取分别值多少。
为了拆开这三部分,我固定了一对从 Add + RMSNorm + Quant 到 QKV-A GEMM 的 producer 和 consumer,保持 GEMM 的数学语义、tile、scheduler 和 epilogue 不变,只改变 consumer 的 GDC wait 位置和 weight loader 结构。
Case 1:Add + RMSNorm + Quant 到 QKV-A GEMM
三种 consumer 只有下面的差异:
entry:     GDC -> prologue -> unified A/B loader -> MMA
deepgemm:  prologue -> GDC -> unified A/B loader -> MMA
prefetch:  prologue -> ALoader: GDC -> activation TMA
                         WLoader:       weight TMA -> MMA
entry 在 kernel 入口立即等待,producer 完成前不做任何 kernel 内部工作。这里的“通用 prologue”指的是预取 TMA descriptor,初始化 shared memory 中的 mbarrier,分配 TMEM,配置 scheduler 和本地流水状态,以及完成必要的 CTA/cluster 同步。这些准备完成后,才进入真正携带数据依赖的加载和计算。
deepgemm 把 GDC wait 移到这些准备之后,但 A/B 仍由同一个 loader 在 wait 后加载;prefetch 再把不读取 producer 输出的静态权重 B/SFB 分给独立 WLoader,使它可以在 GDC 释放前填充 weight ring。三种模式都在真正读取 activation 前等待 producer,因此数据依赖没有放松。
先分别比较三种实现自己的 PDL-off 和 PDL-on。下表给出从 producer 开始到 consumer 完成的总 span 节省,所有时间单位均为微秒:
| M | entry PDL 收益 | deepgemm PDL 收益 | prefetch PDL 收益 |
|---|---|---|---|
| 16 | 0.608(4.4%) | 1.344(9.6%) | 2.912(20.7%) |
| 32 | 0.512(3.7%) | 1.375(9.7%) | 2.688(19.2%) |
| 64 | 0.960(6.4%) | 0.896(6.0%) | 2.144(14.5%) |
| 128 | 0.896(5.8%) | 1.216(7.8%) | 1.856(12.0%) |
| 256 | 0.704(4.1%) | 1.408(8.0%) | 1.360(7.9%) |
entry 在 producer 完成前既不执行 prologue,也不加载权重,但仍然能够节省 0.51--0.96 us(从torch的trace看,开启了cudagraph后,kernel之间的bubble在300ns左右,小于这里测到的收益,可能是pdl会把前一个kernel的最后一部分和后一个kernel的前一部分开销也掩盖掉,而不只是可观测的kernel bubble)。
这部分收益主要来自 consumer 提前进入 GPU,以及 producer 完成后的更紧 handoff。不过,三种实现各自的 PDL-off 基线中,kernel handoff 本身有约 0.1--0.3 us 波动;要更严格地归因 prologue 和权重预取,需要直接比较三种 PDL-on 实现:
| M | 移动 wait 后提前 prologue | 拆出 WLoader 后的权重预取 |
|---|---|---|
| 16 | 0.448 | 1.504 |
| 32 | 0.544 | 1.440 |
| 64 | 0.224 | 1.312 |
| 128 | 0.192 | 0.768 |
| 256 | 0.448 | 0.208 |
移动 wait 的两个实现都使用 unified A/B loader,只把 wait 从 kernel 入口移到通用 prologue 之后,因此 0.19--0.54 us 可以归因于提前执行 descriptor prefetch、barrier/TMEM 初始化等工作。
拆出 WLoader 的两个实现保持相同 GEMM config,只把 B/SFB 拆给不等待 producer 的独立 WLoader,因此 0.21--1.50 us 是 split-loader 和 weight prefetch 的净关键路径价值。
权重预取能赚多少,不只取决于 weight ring 有多深,还取决于 consumer 多早开始执行。到 M=256 时,consumer 开始时 producer 已经完成约 77%,可用的 overlap 窗口只有约 1.25 us;即使 weight ring 仍可容纳 9 个 stage,权重预取的增量收益也只剩 0.208 us。
这里的 stage 数只是源码允许提前 issue 的容量上限,不代表 trace 已经证明所有 stage 都在 producer 完成前落地。
提前进入 GPU 也不是免费的。M=16/32 时,prefetch 版 consumer 提前搬运权重,使 producer 分别变慢 0.160/0.352 us;但 consumer 提前完成的工作更多,总 span 仍然相对 deepgemm 版缩短 1.504/1.440 us。
因此 PDL 的收益不能看 consumer duration,也不能把时间线上的整段 overlap 都当成有效工作;最终必须比较 producer 开始到 consumer 完成的总 span。
Case 2:Attention 输出投影到 MoE RMSNorm
第二个 case 是一个反例。在 Attention 输出投影到 MoE RMSNorm 的这条依赖边上,consumer 在 GDC 前只能发出一条 12 KiB norm-weight TMA,没有可以持续填充的多 stage 权重流水:
| M | consumer 开始时 producer 完成比例 | timeline overlap | span 收益 |
|---|---|---|---|
| 16 | 6.9% | 27.81 us | 0.54 us |
| 64 | 6.6% | 29.54 us | 0.48 us |
| 256 | 5.3% | 33.95 us | -0.86 us |
它看起来 overlap 了几十微秒,但其中绝大部分只是 consumer 提前驻留后的 GDC 等待。到 M=256 时,consumer 提前参与资源调度的代价已经超过一条 norm-weight TMA 能隐藏的工作,总 span 反而回退 0.86 us。
7. Capture 后重写 CUDA Graph
我最先尝试的方案是保留各个独立 CUDA kernel,再通过 capture 后修改 CUDA Graph 的边,引入分支并行和 PDL。
把单流 capture 的串行边改成实际数据依赖
为了尽量少改模型代码,我仍按原来的顺序在一条 stream 上 launch 这 11 个 kernel,再将它们 capture 为 CUDA Graph。
但单流 capture 会原样保留 stream 中的执行顺序,得到的仍是一条串行链:即使 QKV-A、Head-Gate 和 Indexer-K 彼此没有依赖,它们的 node 之间仍然连着 edge。
CUDA Graph 不会根据 tensor 的读写关系自动删除这些 edge,所以仅仅完成 capture 并不能让三个 kernel 并行。
这版实现中的 kernel 数量和顺序固定,因此可以按位置识别每个 Graph node。Graph 实例化之前,我先删除单流 capture 产生的串行 edge,再按前文依赖图中的实际数据关系重新连边:
cudaStreamBeginCapture(stream, cudaStreamCaptureModeThreadLocal);
enqueue_linear_sequence();
cudaStreamEndCapture(stream, &graph);

rewrite_linear_capture_as_dag(graph);
cudaGraphInstantiate(&exec, graph, 0);
把这个过程缩小到四个 node 就很直观。单流 capture 得到的是:
A0 -> QKV-A -> Head-Gate -> Indexer-K
实际的数据依赖却是 A0 同时为后三个 kernel 准备输入:
+-> QKV-A
A0 --+-> Head-Gate
     +-> Indexer-K
假设已经沿着原串行 edge 找到并命名了这四个 node,改图的核心代码如下。原来的 A0 -> QKV-A 可以保留,只需删除后两条错误的串行 edge,再补上 A0 的另外两条出边:
cudaGraphNode_t old_from[] = {qkv_a, head_gate};
cudaGraphNode_t old_to[]   = {head_gate, indexer_k};
cudaGraphRemoveDependencies(graph, old_from, old_to, 2);

cudaGraphNode_t new_from[] = {a0, a0};
cudaGraphNode_t new_to[]   = {head_gate, indexer_k};
cudaGraphAddDependencies(graph, new_from, new_to, 2);
CUDA Graph 按 edge 判断 node 是否可以执行,不需要再为这三条分支指定 stream。A0 完成后,QKV-A、Head-Gate 和 Indexer-K 的依赖同时满足,CUDA runtime 就可以并发调度这三个 kernel。它们能否在 GPU 上真正重叠,还取决于当时是否有足够的 SM 等资源。
PDL 也在同一次改图中完成。普通 edge 要等 producer kernel 整体退出后才能调度 consumer;programmatic edge 则允许 producer 的所有 CTA 发出 launch completion 后,consumer 提前进入 GPU:
cudaGraphEdgeData edge{};
edge.from_port = cudaGraphKernelNodePortProgrammatic;
edge.type = cudaGraphDependencyTypeProgrammatic;
cudaGraphAddDependencies(graph, &producer, &consumer, &edge, 1);
下文把这种实现称为 Graph rewrite 方案。
子图逐步扩大时,新增计算有多少被隐藏
为了观察 Graph rewrite 后的收益如何随子图扩大,我从 A0 开始,依次接入 C0、B1、B0、D0、D1、D2 和 E1。B0、B1 和 D1 各自包含 producer/finalizer 两个 kernel,其他阶段各对应一个 kernel。
每一步都记录从首个目标 kernel 到最晚终止 kernel 的累计时间、子图实际增加的时间,以及新增阶段单独执行的时间:
| 累计子图 | Graph rewrite 累计时间 / us | 接入后增加 / us | 新增阶段单独执行 / us |
|---|---|---|---|
| A0 | 2.960 | 2.960 | 2.960 |
| +C0 | 5.695 | 2.735 | 3.664 |
| +B1 | 9.248 | 3.439 | 7.456 |
| +B0 | 14.800 | 5.664 | 11.856 |
| +D0 | 26.607 | 10.367 | 11.488 |
| +D1 | 30.864 | 4.257 | 10.000 |
| +D2 | 35.136 | 4.272 | 6.544 |
| +E1 | 35.936 | 4.224 | 5.089 |
B1、B0 和 D1 最能说明问题:它们单独执行分别需要 7.456 us、11.856 us 和 10.000 us,接入重写后的 Graph 后却只让整图增加 3.439 us、5.664 us 和 4.257 us。把这组单独执行时间直接相加是 59.057 us,完整 Graph 只需要 35.936 us。
两者的 23.121 us 差值不是严格的 overlap 时长,但明确说明新增计算有很大一部分与已有子图重叠。同一轮实验中,MegaRTP 的完整子图为 40.559 us,Graph rewrite 方案快 4.623 us。
这组累计实验的每一步都会重新选择当前前缀的配置,因此“接入后增加”使用 matched 的前一前缀,不一定等于相邻两行累计时间直接相减。
它适合说明子图扩大时的整体趋势;要严格拆分 Multistream 和 PDL 各自贡献多少,还要看后面的固定 kernel 消融。
实际 kernel timeline
下图来自 M=16, KV=8192、打开 kernel 内打点的一次真实 replay。每个 CTA 在 kernel 入口、主输入就绪,以及完成写回和 event 发布三个位置读取 %globaltimer,同时记录 %smid;图中的区间和 active-SM 曲线都由这些时间戳生成。
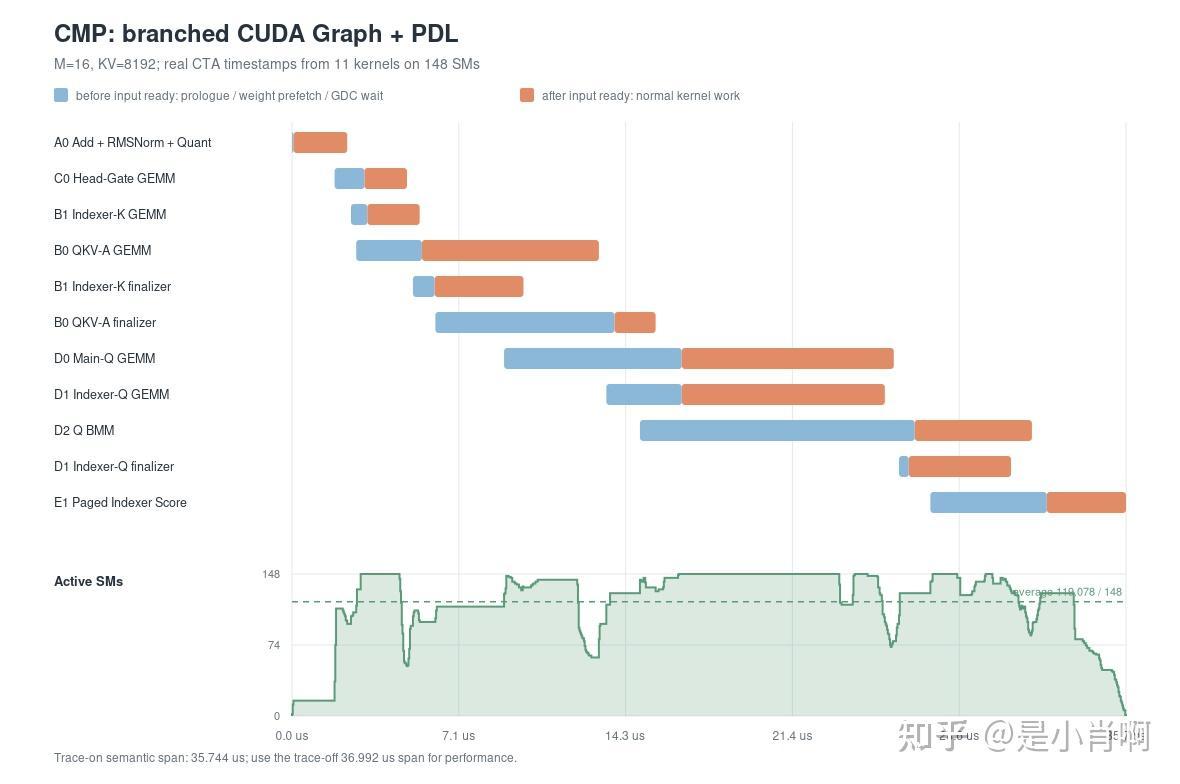
图把每个 kernel 聚合成两个窗口。浅蓝色表示 consumer 已经进入 GPU、但主输入尚未完全就绪;这不是纯等待,kernel 可以先完成 prologue、descriptor 和 barrier 初始化,并由 WLoader 预取权重,只有读取 activation 的工作受 GDC 约束。
橙色表示主输入全部就绪后的正常 kernel 工作。由于这是 CTA 时间戳的 kernel 级聚合,颜色分界只用于展示整体执行形态,不表示所有 CTA 在同一时刻切换阶段。
这张图可以直接看到两种重叠。A0 之后,Head-Gate、Indexer-K 和 QKV-A 三条分支同时推进;有依赖的 kernel 也在主输入完全就绪前进入 GPU,利用浅蓝色窗口完成准备和权重预取。
Main-Q 的这个窗口是 9.088 -> 16.704 us,Q BMM 是 14.912 -> 26.688 us,Paged Indexer Score 是 27.360 -> 32.352 us。窗口中仍可能包含 GDC 等待,因此它的长度不能直接当成有效预取时间。
606 个 CTA 覆盖了全部 148 个 SM,测量区间内平均有 119.078 个 SM 在执行目标 CTA;换句话说,148 个 SM 在整段时间中的目标 CTA 覆盖率为 80.46%。
Kernel 内打点会带来约 4.3%~4.7% 的扰动,所以图中的 35.744 us 只用于解释执行形态;正式性能使用关闭打点后的结果。
固定 kernel 的 2 × 2 消融
下面四种模式使用完全相同的 11 个 kernel、tile 和数学工作,只改变 Graph 是否保留分支并行,以及依赖边是否使用 PDL。
表中的 Graph 时间由 CUDA event 包围一次这段子图的 Graph replay;GPU 执行区间来自第一个目标 kernel 开始到最后一个目标 kernel 结束。
| Graph 调度方式 | Graph 时间 p50 | GPU 执行区间 p50 |
|---|---|---|
| 线性完成链,不使用 PDL | 65.504 us | 61.631 us |
| 线性进入顺序,使用 PDL | 59.360 us | 54.208 us |
| 分支 DAG,不使用 PDL | 49.152 us | 44.432 us |
| 分支 DAG,同时使用 PDL | 40.960 us | 36.992 us |
“线性进入顺序”只是隔离 PDL 收益的控制组:它限制 node 按 capture 顺序进入,但 CUDA Graph 仍可能使用不同的内部执行队列,不能理解为硬件上固定只有一条物理 stream。
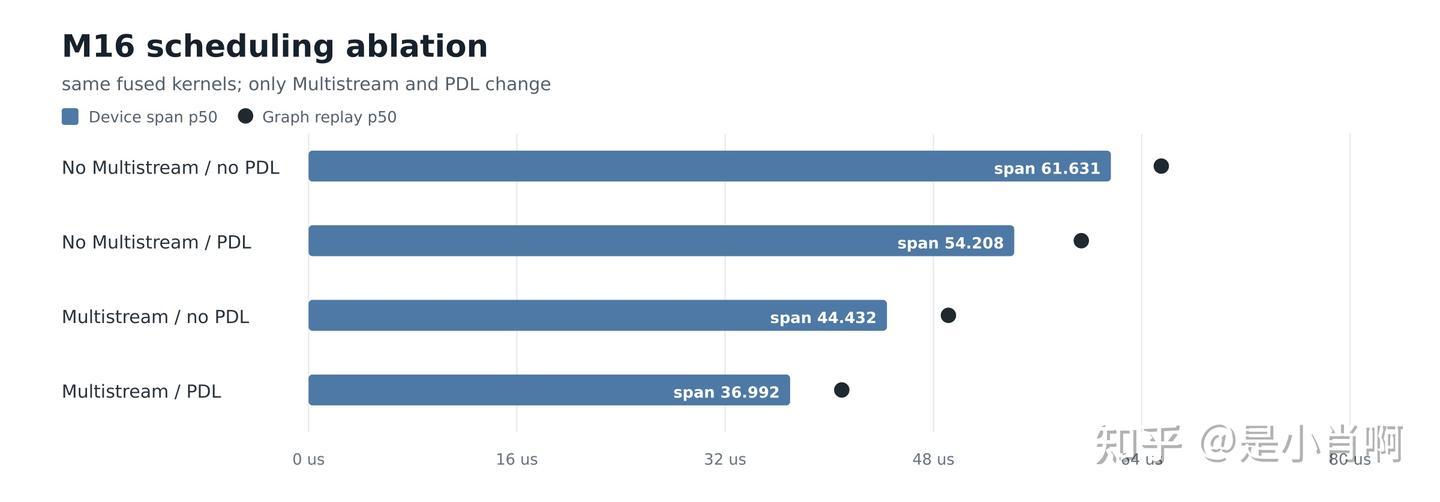
在线性链上加入 PDL,GPU 执行区间缩短 7.423 us;只把完成链改成分支 DAG,缩短 17.200 us。两者同时开启后,执行区间从 61.631 us 降到 36.992 us,缩短 24.639 us,即 40.0%。
这说明 M=16 下更大的收益来自三条小分支共同使用空闲 SM,PDL 又进一步覆盖了有依赖的后续 kernel 的准备和等待窗口。
对应的 kernel 内 trace 中,线性完成链平均只有 49.481 个 SM 在执行目标 CTA;分支 DAG + PDL 提高到 119.078 个。
与此同时,11 个 kernel 耗时的简单求和反而从 62.400 us 增到 102.864 us:提前进入的 consumer 把 GDC 等待算进自身耗时,并行 kernel 还会竞争 SM、L2 和显存带宽。
并发调度应比较关键路径,也就是整段 GPU 执行区间,而不是相加每个 kernel 的时间。
8. Graph rewrite 的问题:kernel 顺序必须固定
前面的结果说明 Graph rewrite 确实拿到了 Multistream + PDL 的收益,但它有一个根本问题:CUDA Graph 的 kernel node 不包含“A0”或“QKV-A”这样的算子语义,改图代码无法根据 tensor 读写关系自动识别 producer 和 consumer。
它之所以知道应该修改哪些边,只是因为 capture 的单流 kernel 序列完全写死,代码提前约定了 node[0] 是 A0、node[1] 是哪个 kernel。
这让改图逻辑与 kernel 数量和顺序紧密绑定。假设在 A0 后面插入一个 kernel,后面所有 node 编号都会移动;原来的代码仍然能取到 node[1]、node[2],却可能把分支边和 programmatic edge 连到错误的 kernel。
每次拆分、融合或替换一个 kernel,都需要重新检查完整的 node 位置映射和所有依赖边。
改为手动 Multistream + Programmatic Event
后来我改成手动 Multistream,不再 capture 后修改边,而是在 forward 中直接控制 stream 和 event:调用一个算子时就决定它进入哪条 stream;遇到跨流依赖时,producer 绑定 Programmatic Event,consumer stream 显式等待这个 event。
之前:固定单流序列 -> capture -> 按 node 编号认出 kernel -> 删除旧边并重连 Graph

现在:forward 直接选择 stream -> producer 绑定 event -> consumer stream 等待 event
                                      -> 外层 CUDA Graph 按现有关系完成 capture
关键变化是依赖的表达方式:以前由 capture 后的代码根据固定 node 编号补写;现在由模型 forward 通过 stream 和 Programmatic Event 直接写出来。
增加、删除或替换一个 kernel 时,只需修改对应的调用和 event 依赖,不必重新维护整套 node 位置映射。
9. 总结:低延迟推理没有魔法
先把 latency 的变化放在一起。Kernel fusion 是两条路线共同的起点;此后的 MegaRTP 和 CMP 是并列实验,不能把它们的百分比继续相加。
| 优化 | latency 变化 | 对应收益 |
|---|---|---|
| Kernel fusion | 约 80 -> 61.631 us | 约 23.0% |
| MegaRTP 实际运行 | 61.631 -> 44.272 us | 28.2% |
| MegaRTP 扣除 4.671 us 固定框架开销后的诊断值 | 61.631 -> 39.601 us | 35.8% |
| 只开启 PDL | 61.631 -> 54.208 us | 12.0% |
| 只开启 Multistream | 61.631 -> 44.432 us | 27.9% |
| 在 Multistream 上继续加入 PDL | 44.432 -> 36.992 us | 16.7%;相对 61.631 us 累计降低 40.0% |
因此,当前效果最好的路径是 80 -> 61.631 -> 44.432 -> 36.992 us:先做 Kernel fusion,再用 Multistream 并行独立分支,最后用 PDL 提前启动有依赖的 consumer。从最初约 80 us 到 36.992 us,整段 latency 共降低约 53.8%。
PDL、Multistream 和 Megakernel 分别解决什么
PDL 消除的是有依赖 kernel 之间过粗的启动边界。
我目前在 CUDA Graph 中观察到的相邻 kernel bubble 通常只有约 300 ns,因此 PDL 如果只是让 consumer 提前进入 GPU,收益往往只有约 0.5 us;
如果 consumer 能在等待输入时完成 prologue,收益可以接近 1 us;再加上权重预取,受 SMEM 容量限制,单个 producer-consumer 边通常也很难超过 2 us。
一个偏激但实用的工程估计是:PDL 在单条依赖边上的收益大约为 0.5--2 us。上面的 7.423 us 是多个依赖边累计后的整图收益,是否值得为此修改 kernel,需要看这些边是否位于关键路径,以及 kernel 能把多少工作移动到 GDC 之前。
Multistream 解决的是独立分支被单流强制串行的问题。
只要 DAG 中存在彼此无依赖、又各自用不满 GPU 的 kernel,Multistream 大概率能够缩短关键路径;
但这部分收益不是免费的,并发 kernel 会争抢 SM、L2 和显存带宽,而且仅靠 stream 很难精确规定多个 ready kernel 的实际执行顺序。
如果关键路径上的 kernel 被排到后面,或者给某条分支分配了过多资源,原来的非关键分支也可能变成新的关键路径。
因此,kernel 优化之外还要考虑整个 DAG 的资源分配:哪些分支应优先执行,每条分支应占多少 SM,以及增加一条路径的资源后,关键路径是否发生了转移。
Megakernel 从能力上可以看作 Multistream、PDL 和细粒度依赖的强化版。
Host 可以按优先级把不同 kernel 的 tile instruction 放进 worker queue;producer 完成部分 tile 后,consumer 不必等待整个 producer 结束;同一个 worker CTA 还可以在执行当前 instruction 时准备和预取下一条 instruction。
这些能力提供了比 CUDA stream 更直接的调度控制,但开发成本也最高:算子需要改写到统一的 instruction/worker 接口中,固定 worker CTA 的资源形态还不适合当前的 2-SM GEMM 和 1024-thread TopK。
只有图中确实存在持续的 tile 级流水时,这些额外能力才可能覆盖框架开销和算子移植成本。
Megakernel 只是最后 10%,甚至只是 5%
这轮实践最重要的认识是:当模型结构、算法和并行规模都已经固定时,Megakernel 并没有想象中那么性感。
先把单 kernel 写好,尽可能完成 kernel fusion,再用 Multistream 并行没有依赖的分支;PDL 甚至可以先沿用 DeepGEMM 原生的做法,只提前完成 prologue,不为权重预取进一步拆分 loader。
做到这些以后,通常已经能够拿到理想 Megakernel 性能的 90%,甚至 95%。ppgppgppg 的一组独立实验也得到了非常接近的结论。他把 Hazy Research 的 Llama-3.2-1B Megakernel 拆成 81 个普通 kernel,保持 operator body 不变,再用 CUDA Graph + PDL 重建调度。
在 H100、batch=1 下,Megakernel、普通 Graph dependency 和 PDL 的 latency 分别为 983.1 us、1169.1 us 和 1009.7 us。
作者按吞吐口径统计,PDL 拿回了 82.8% 的 kernel-boundary 损失,使普通 kernel 达到 Megakernel 97.4% 的吞吐,Persistence 最后只领先约 2.7%。
Megakernel特有的细粒度依赖(不知道rubin的细粒度pdl能否干掉megakernel)要产生收益,必须同时满足以下条件:producer 的输出可以按更小粒度交给 consumer,GPU 上还有空闲硬件执行 consumer,而且 producer 不能在一个 wave 内完成全部工作。
如果 producer 只有一个 wave,那么第一块输出 ready 和整个 producer 完成的时间几乎相同,细粒度依赖就没有额外的执行窗口。MegaMoE 正好满足这些条件。
dispatch 按专家的 token 分片通过 NVLink 发送,不占用 GEMM 的计算单元;某个专家的 token 到达后,对应的 group GEMM 就可以开始计算,后续 token 仍可继续 dispatch,已经完成的分片也可以交给 combine。dispatch、group GEMM 和 combine 因此形成持续的通信与计算流水。
本文的 attention-pre 则相反:主要 GEMM 的 M=16,同时 blockM=16,整个 M 方向只有一个 tile,consumer GEMM 必须等 16 行输入全部就绪后才能开始;而上游 producer 通常也在一个 wave 内完成。
此时把 event 从 kernel 粒度细化到 tile 粒度,并不能让 consumer 提前获得有效计算时间,因此几乎没有额外收益。
真正能够带来大幅收益的,往往不是用 Megakernel 把执行效率从 90% 推到 100%,而是改变模型结构、算法或并行规模(从算法层面对infra进行降维打击)。
GLM-5.2 的 IndexShare 就是一个直接的例子:大约每四层只执行一次完整 Indexer,其余层复用索引结果,相当于直接省掉了三层重复的 Indexer 计算,attention-pre 的开销也随之明显下降;这类模型结构变化带来的收益,远大于继续从 Megakernel 中抠最后几个百分点。
类似的方向还包括把 MoE 从 EP8 扩展到 EP16,用 FP4 MoE 代替 FP8 MoE以减少权重访存,或者通过投机推理让一次前向产生更多 token。
这些优化直接减少每张卡的工作量,或者提高每次前向的 token 产出,投入产出比远高于 Megakernel。相比之下,是否值得为最后 5% 到 10% 的性能投入高昂的开发和维护成本,需要非常慎重地判断。
作者:是小肖啊
https://zhuanlan.zhihu.com/p/2071311590117396655