作者:Jinyan Su (@SuJinyan6)
原文:https://x.com/SuJinyan6/status/2121812102709157921
The English version can be found on my Substack here.
The original Chinese version:
今年我找工作,主要投的是post-training这个方向。
结果来联系我的startup,几乎全是做数据的。
直到现在,依然会收到很多做rl environment的猎头,做数据的start up的founder的联系,以及一些想转行到这个方向的人的私信要跟我约meeting。
以前我总是因为在cold outreach时收不到对方的回复而感到难过,现在,鉴于自己的时间和精力越来越有限,我已经没法做到满足陌生人的requests了。
互联网上的noise越来越多,时间和attention变得越来越贵,给别人发私信的成本却很低,对于我不熟悉的人,“拒绝”在很多时候也是迫不得已。(即使是对于那些有过一面之缘的人,我也很难去判断对方是个怎么样的人,以及我付出的时间是否有任何意义。)
鉴于对这个方向感兴趣的人很多,并且最近几个月明显越来越多了,我就集中写一个帖子好了。
在学术界的post-training,小打小闹,还是可以改改算法,自娱自乐的,至于自己改完了的算法最后能在多general的场景上使用,以及能scale到多大的模型,我其实并不关心,只要我自己能学到东西,在这个过程中玩得开心就好了。
但在工业界,现有的LLM training recipe,尤其是post-train 部分几乎已经成熟,算法上的创新越来越少,无论是那几个开源的RL training 框架,还是企业内部自己用来训模型的框架,都已经很成熟和稳定了,模型的提升,几乎都是从数据这里来。
做Pretrain的人洗数据,研究架构,scaling,数据配比,做post-train的人则主要是跟各种rl 环境打交道。
当然,中间还有mid-train,在一些high quality的数据上训练,以增强模型专业领域的能力。
那些在工业界做post-training的人,大部分也都是在处理数据。我们想让模型做各种各样的task,就得在相关的数据上训练,我们想要做的task种类越多,需要的数据也就越多样。
至于各个国内外所谓的frontier lab分别收什么样的数据(比如,是一个完整的rl环境,还是模型跑出来的轨迹,还是hack出来的带有cot的完整数据),以及这些数据可以分别用来干嘛,我便不得而知了。我估计rl环境用于rl的训练,模型跑出来的高质量轨迹可以用来做off-policy cold start(sft),以便于后面继续做on policy distillation或者rl。
各类数商提供的数据类型也很不一样,比如很多水下的非常小的start up,几乎都是synthetic data,然后人再简单地看一下。而Scale AI、Mercor之类的领域内的人知道名字的start up还是会找真正的专家来标数据的。
造synthetic data几乎没有什么成本(其实这个也取决于task,如果是需要gpu的task,那成本就会大了,browser和computer use之类的,只需要付出token的成本,而且,大部分的数据小作坊,都会直接使用个人账号,所以成本几乎可以忽略不计)。因为成本低,没有技术壁垒,大家都想来试试。
十月份的时候在深圳参加一个数据相关的活动,一个刚毕业的phd学生,在和一群人眉飞色舞地激情pitch(literally,他表情过于生动,感觉他脸上的所有五官,尤其是眉毛,都在跳舞,这是我又一次觉得中华文化博大精深,短短一个四字成语,便可以把一个画面描述得如此形象)。
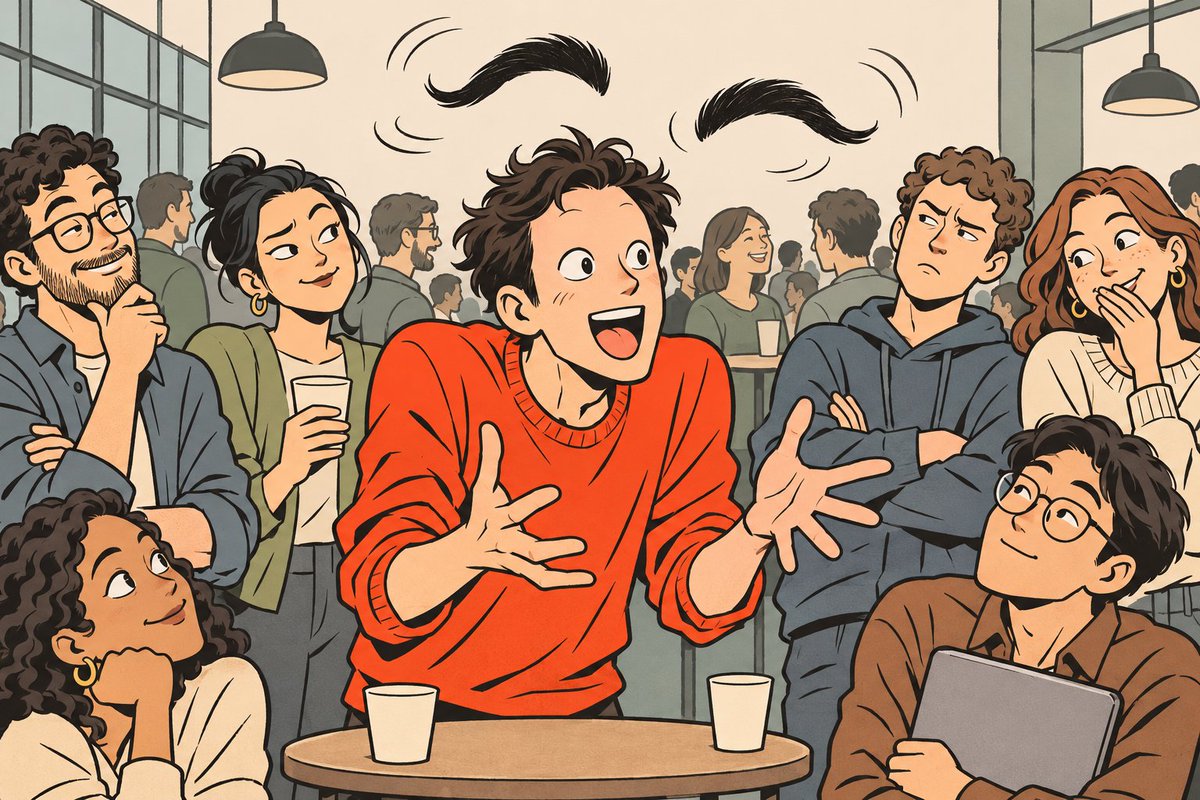
我问他,现在有这么多数据公司,你的优势是什么。
他说,我公司只有我一个人,没有额外的开销,我就这样做个半年,看看会怎么样。
这样的问题,我曾经问过很多人,大部分人给我的回答是,“我们有着更好的技术,积累了很多的know how”,“frontier lab用了我们的数据都说我们比其他data vendor要好”。好像每个data start up都有自己的know how,都有自己的独特优势,都被他们的甲方所认可。
就像每一个paper都claim自己有novelty,是state of the art。刚入行的时候,我们还可以一脸崇拜地看着说这句话的人,毕竟对方掌握了一些我等普通人完全想不到的神秘技术。
但问了很多家,也没听到让我觉得耳目一新的观点。
还有一些start up,说自己维护着很强的垂类的专家网络,至于什么算是“专家”,那就不得而知了。
大家给我的回答都是这些摆得上台面的用来忽悠投资人的话术,在我看来,一个data start up唯一可以成为独特优势的,就是“connection”,i.e., 认识frontier lab的人或者自己本身在frontier lab工作过,知道他们想要什么,并且可以通过这些connection把数据卖出去。国内估计还会包含一些吃饭文化,酒桌文化,送礼文化。
质量固然重要,但质量很难成为壁垒。因为能把质量做到某一个水平线上的start up也足够多,从质量的角度,大家很难有区分度。
另外,“质量”这个词本身也很难定义(就跟前面的“专家”一样难以定义),模型厂在收数据的时候几乎都是肉眼看数据的“质量”,或者让数商在小的模型上训练一下,而且也出现过同样的数据,在某一家模型上训完效果好,另一家模型上训完效果差的情况。
很多时候,你严格把控,花了很多时间去做的细节可能对最后的结果的好坏毫无影响。
有科研背景的,但创始人本人没有独特优势的start up,如果没有特别好的融资,因为资源的缺乏,要么做benchmark和eval,要么做数据,要么搭agent框架做应用。
然后这几个方向也可以相互转化,比如搭agent框架做应用做失败了可以转来卖用户数据,做eval和benchmark做得很好,让业界以及模厂的人关注了,便也可以趁机向模厂卖数据。
各位数商们也会做一些benchmark,万一自己做的哪个benchmark被注意到了,短期就不愁订单了。
接下来写写我看到的一些卖数据的方式:
(1)众包贡献task
学术界以众包的方式贡献task,做benchmark是合理的,毕竟资源是真的不够。一些学术界出来的phd们,因为之前在学界积累的足够多的经验,便把这种众包的方式在创业中发扬光大。
对于学术界来说,参与众包工程的人想要的是文章的作者席位,金钱上的奖励大家其实不是很在乎。另外,由于学术界在读phd所做的工作越来越没有影响力,大家还是希望有这样一个机会去参与这样看起来似乎更有影响力的项目。另外,一些中国学生,会更倾向于参加此类项目,因为文章的发表也会对他们后面绿卡的申请有所帮助。
比如,某start up效仿terminal bench做众包task,并在小红书上招募参与者,最近恰好读到小红书上一个批评此类start up的帖子,评论区里大家态度褒贬不一,主要的批评的声音有:
(1)和terminal bench相比,任务和流程上并不是很清晰,有些人花了时间,但最后没有在文章作者上。
(2)承诺给论文作者(实际上,他们承诺的是文章投ICLR以及nature)其实相当于空头支票,文章不一定可以中。
(3)目前的他们做的benchmark目前依然没有开源。学术圈的众包科研至少最后是开源了的,所以大家为爱发电都是自愿的。一旦这些东西用于founder个人的商业上面,那么贡献者应该得到知情权,以及合理的解释和补偿。
注:上述批评的声音并非个人观点,仅仅是我对小红书帖子内容的转述。
(2)先做一个公开的benchmark,再卖数据
虽然我不了解marketing,但很多东西都是相通的。如果没有需求,那就制造需求。如果大家不觉得焦虑,那就制造焦虑。做benchmark当然要让模型的performance低了,不然谁来买他们的数据?
从学术界的角度,如果模型在benchmark的performance太好,则说明他们研究的这个问题是不重要的,所以也得让模型的performance低才行。
于是无论是学界还是start up,都有足够的motivation让模型的performance变差,也出现了一堆让我觉得很不合理的benchmark,要么verifier太过严格,模型可能以其他方式做对了,但最后得分很低;又或者task本身有问题,有很多ambiguous的东西没有告诉模型,有多种可能性,却期待模型能按某一种可能性来。
(3)做agent应用
做agent应用的公司里,有一些是快倒闭的时候突然发现有人愿意高价收自己的数据,于是原地转型,当起了数商。还有一些运营良好,在做自己的主业的同时,顺便根据用户数据,生成一些synthetic的,拿来卖。
(4)免费token站
直接送你token用,但是你的数据被拿走了。当一件东西看似免费的时候,你可能要想清楚自己在不知不觉中付出了什么。
(5)中转站
相比于免费token站,中转站一边从用户这里收token的钱,一边从下游那里收取数据的钱。
你付钱买token,它转头把你的调用数据打包卖掉,两头赚。
听说某家模型厂去买数据,发现买到了自己的数据,因为他们在用的某个中转站把他们的数据卖了。
除了卖数据本身盈利,还有一些其他的盈利方式,比如,做中间商。
对于那些本身就有connection的人,可以直接联系到买家。
但还有很多人没有connection,凭着他们孤注一掷,不怕困难,艰苦奋斗的强大创业者精神,自己去reach out,找人介绍,并逐渐联系到买家。
但可能也有不懂行,没有connection,也没有sales能力的人,他们仅仅是手里有一批数据,并道听途说数据能卖钱,很赚钱,但不知道怎么卖。好在找一个愿意低价收购的中间商还比较容易。所以可以让中间商赚一道差价,把数据交给中间商,由中间商卖给模型厂。
我之前也在Twitter上发过一些我对卖数据这件事的困惑,为什么,即使有很多数商涌进来,而且卖数据这件事看起来似乎没有壁垒,这个生意依然如此的繁荣,并且似乎大家依然在赚钱?为什么模厂的in-house的人还不够,而需要花这么多钱外采?
最开始,我会觉得,是因为expert data,如果是人来标的那些,肯定是要外采的。
但其中也有很多synthetic的data,以及其实很多的小的数商并没有相关的domain expertise,也是做的synthetic的data,尤其是后面,模型越来越厉害,能被称之为“expert data”的数据也越来越少,human expert 手动标的数据可能都不如模型自己生成的,这时候,除了那些真正拥有顶尖expert的数商,其他的数商,还有任何的价值吗?比如,Mistral Large 4的技术报告里写,他们post-training用的环境、任务、参考答案和verifier,主要是agent自己搭、自己出的,也没提外采数据和人工标注。
就像我说的,synthetic data的生成,没有门槛,可能以前还需要一个足够聪明的researcher去做,现在,有了llm,即使不懂research,即使没有从业经验,也可以在llm的帮助下学会怎么做。所以,资金不够的一些模厂,便自己做。
模型的提升,依靠的是算力和数据。一些资金足够充足的模厂,在算力和数据上都allocate了足够的钱,既然都allocate了,那为什么不用完呢?相比于不买数据,去外面买数据总不会让结果变差吧?何乐而不为呢?
另外一种考量是,即使他们想要买更多的算力,但是可能也没那么好买,既然数据好买,那不如多买点数据吧。
除此之外,便是一些legal的问题,数据作为一个灰色产业,里面有很多不合法的地方,模厂不愿意自己处理这些东西,数商可以游走在法律边缘,作为白手套。
因为数据行业的巨大盈利,大家(包括一些外表光鲜的researcher)也愿意为之做一些不择手段的事情,比如,前面说的做agent应用做不下去后开始卖数据的事情,两位cofounder分道扬镳后,founder A在分开前把数据自己拷贝了一份(这就是“有备无患”?),后面考虑卖数据,于是在分开几个月后,再次登上founder B维护的服务器,想要“偷”更多的数据,但被founder B发现了,最后通过法律手段界定了数据所有权。
也有founder暗示企业或数厂员工从内部偷数据的。在暴利之下,我作为(努力置身事外的)旁观者,也见过了周围人在面对诱惑和利益后的各种离谱的行为。
虽然上面的故事与我利益无关,但确实让我更加不愿意主动帮助别人了,我见过学术圈里教授等比我更senior的人的离谱行为,但很少见同辈之间的离谱行为。这些事,包括最近老是被我在写文章时用作典范的“田柯宇投毒”事件(经典永流传嘛),也让我认识到,我已经senior enough了,因为我的同辈们都已经年长到能够做出各种离谱行为了。
无论是标数据的“专家们”,还是看到这个风口,开始做数据生意的人,就像大厦即将倾覆时,每个人都不想大厦倾覆,但每个人又都在加速大厦的倾覆。
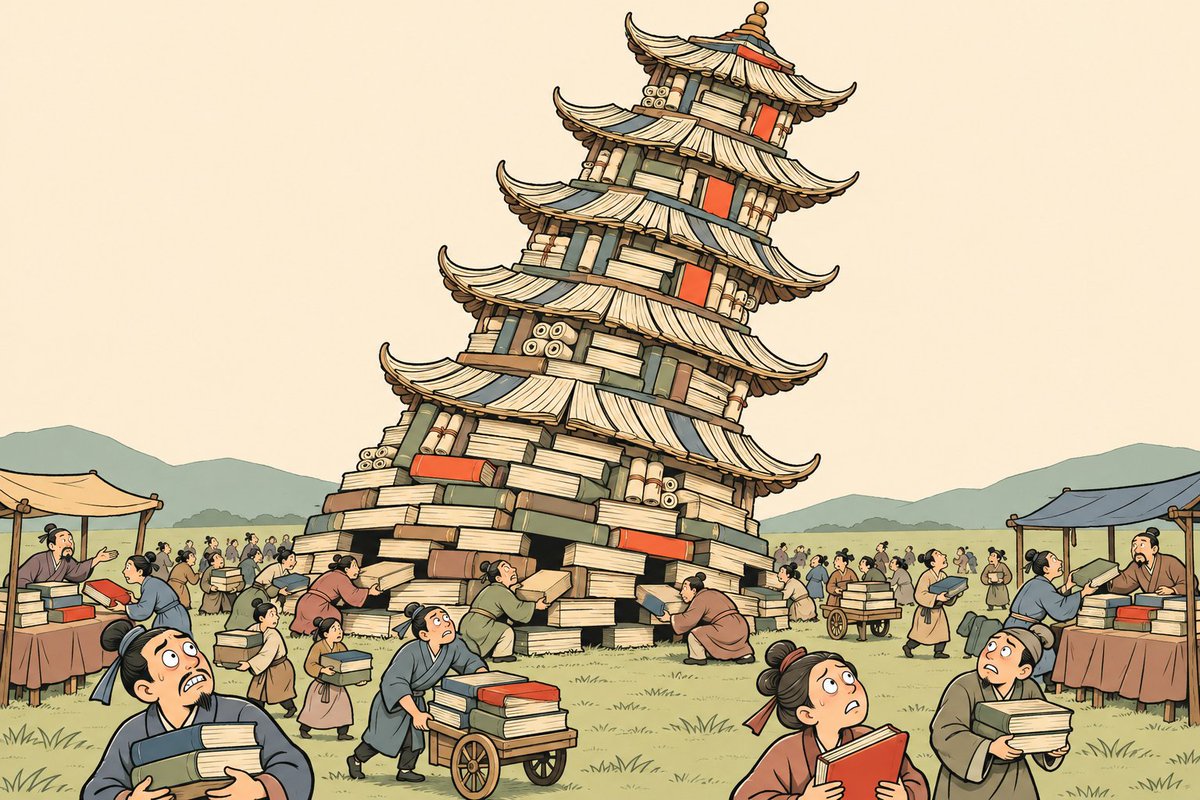
如果你不卖数据,总有其他人卖,你不帮着标数据,总有其他的expert 标,你不赚的钱,总有其他人赚,那为什么不自己赚呢?就像大家都在做更强的模型,没法停下来,如果一个模厂停下来了,那其他模厂不停,不就落后了吗?
如果说,作为expert来标数据,或者作为数商追着benchmark卖数据,以及选择是否以“偷”的方式得到数据都是可做可不做的,那当年某公司强制员工录屏,以及把员工发配去标数据,来提升模型,又有多少是自己选择的呢?
阅读 -- 次
讨论
0 条评论登录后即可参与讨论、向作者提问
登录 / 注册