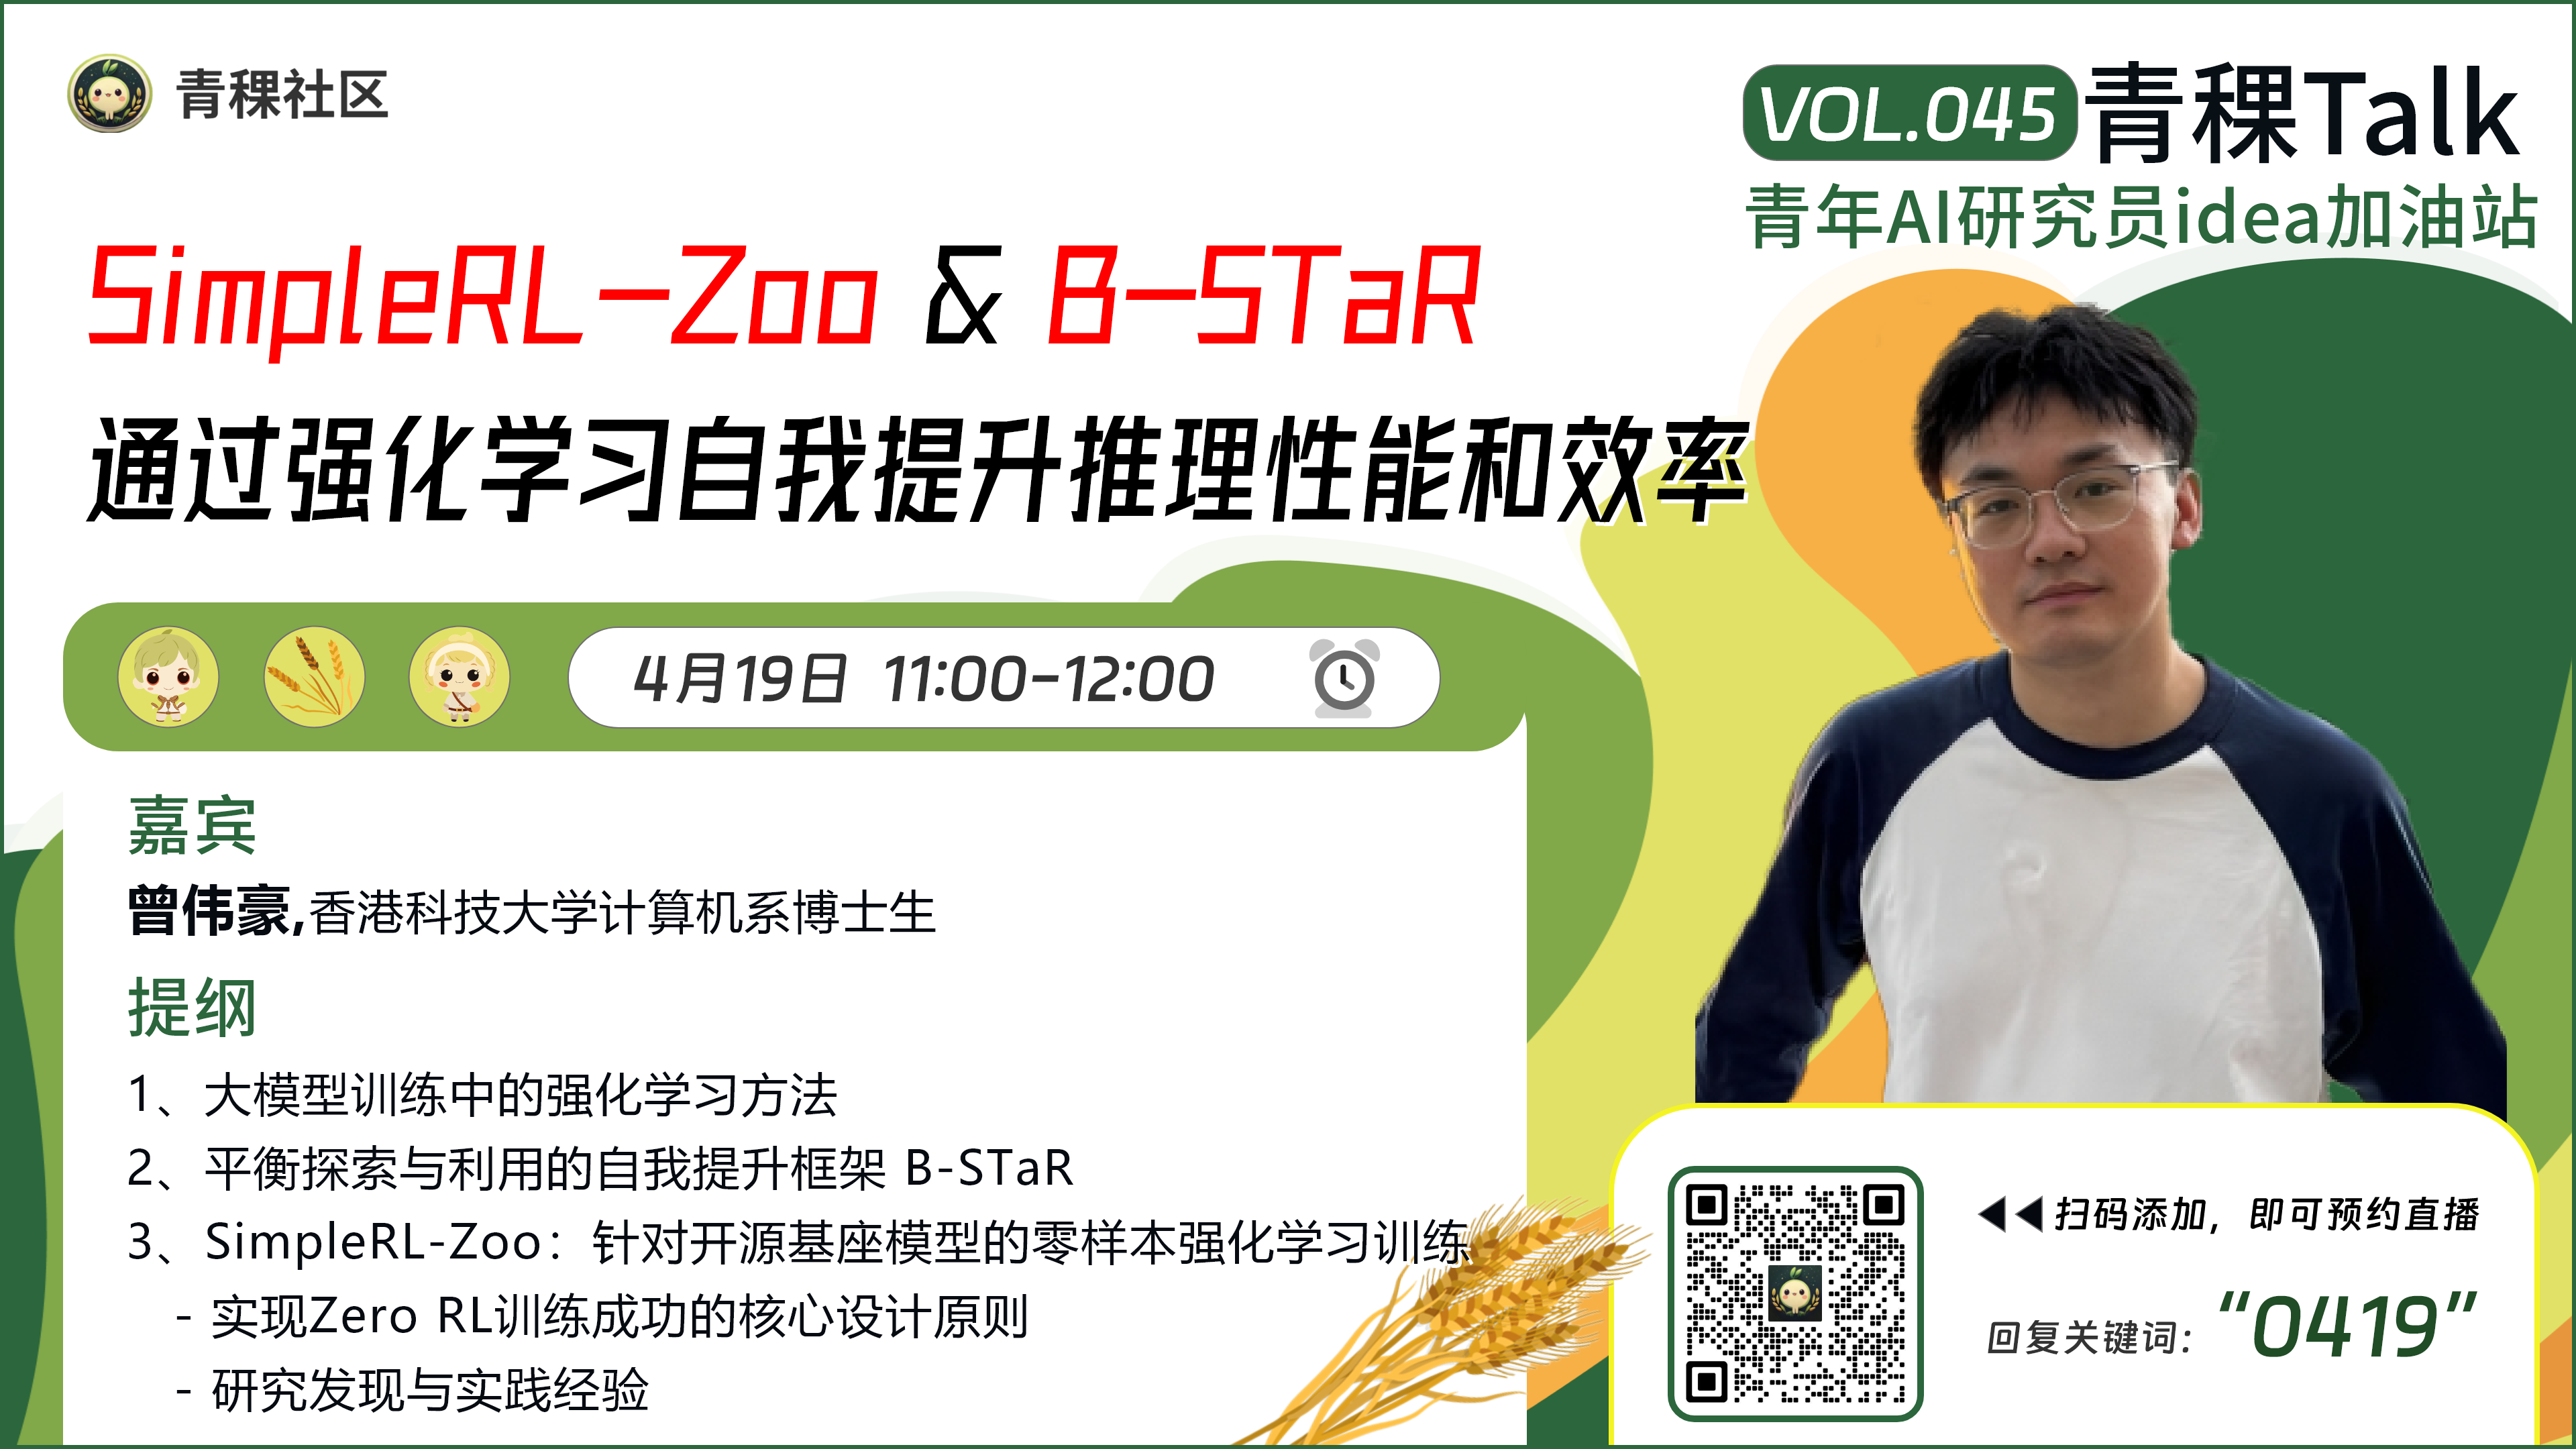
曾伟豪
香港科技大学计算机系博士生曾伟豪,香港科技大学(HKUST)计算机系博士生,主要研究方向为大语言模型(LLM)的post-training,特别关注模型推理能力增强、对齐数据工程、自我进化训练方法等。他提出了SimpleRL方法,利用极少数据结合强化学习显著提升模型在数学推理任务上的能力(Github 3K Star);在B-STAR中引入探索与利用的动态平衡机制,进一步提升LLM的自我学习效果(ICLR 2025);在Deita项目中,通过自动数据筛选实现高效指令微调,使对齐训练更加数据节省(ICLR 2024);他还与微软合作提出Auto Evol-Instruct框架,实现无人工干预的指令进化(EMNLP 2024)。
青稞 Talk / AMA
返回青年科学家目录
研究动态最后更新: 2026-10-24