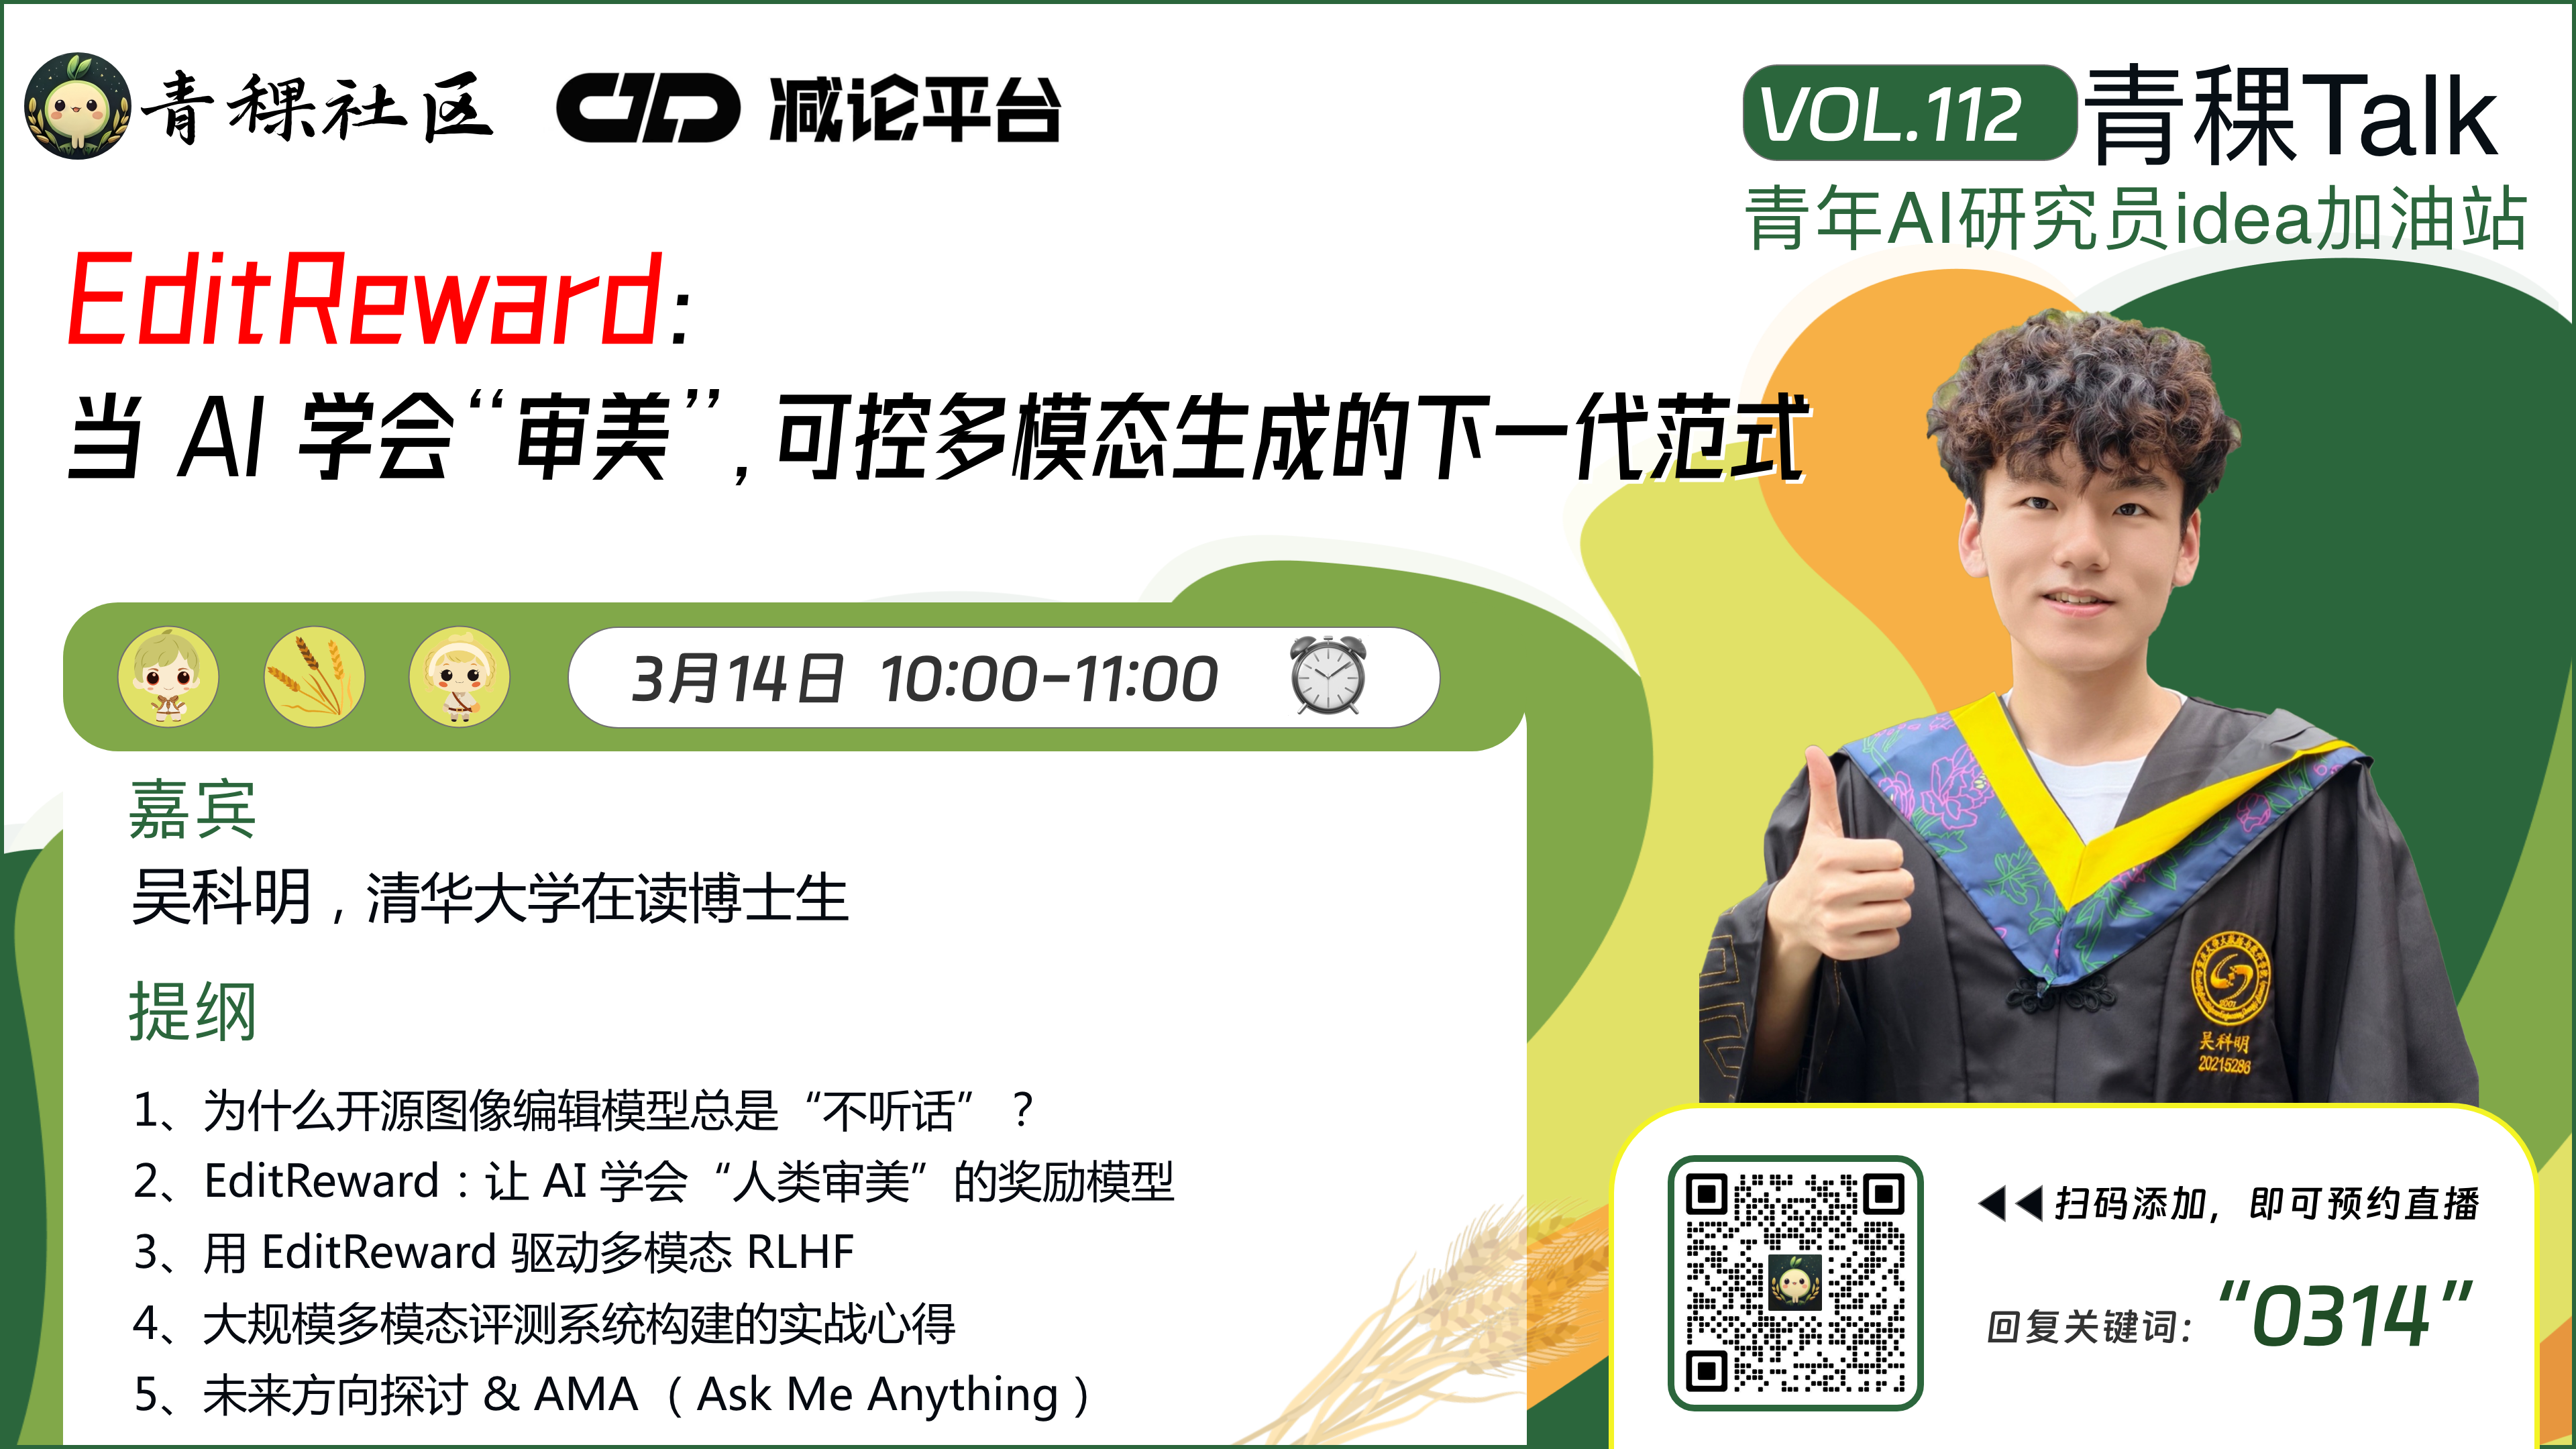
目前专注于多模态生成(侧重Post-training 与强化学习对齐)及复杂多模态推理研究。其研究成果多次发表于ICLR、CVPR、ICCV、ACM MM 等顶会。作为核心作者,他在ICLR 2026 提出了人类对齐奖励模型 EditReward,并在CVPR 2026 推出多模态推理框架 OpenMMReasoner。曾于 微软亚洲研究院(MSRA)进行深度学术访问与研究。
研究动态最后更新: 2026-10-24
打开微信扫一扫,即可观看
最近搜索
热门标签
输入关键词开始搜索
没有完全匹配「」的文章
没有找到「」相关的文章
试试更短的关键词,或点下面的标签